Dodanie narzędzia wygląda na czynność addytywną. Agent umie o jedną rzecz więcej, reszta zostaje jak była.
Nie zostaje. Każde kolejne narzędzie pogarsza wybór wszystkich pozostałych i podnosi cenę każdego obrotu pętli — a oba efekty są niewidoczne, dopóki ktoś ich nie zmierzy.
Dwa koszty naraz
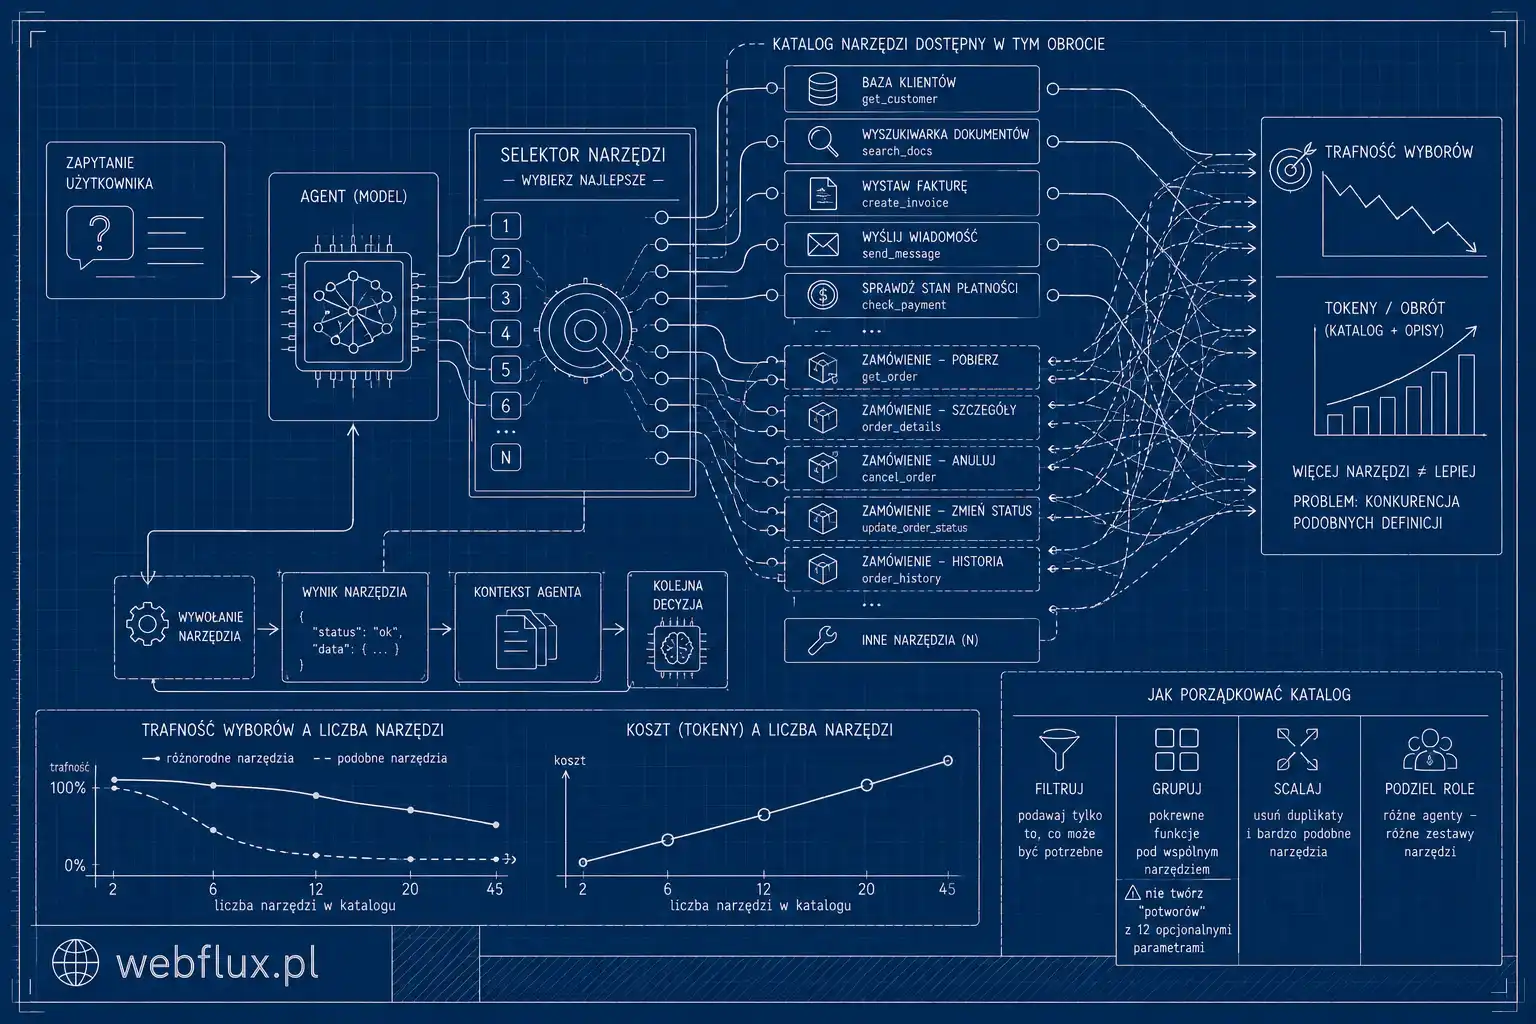
Koszt finansowy jest łatwy do policzenia. Katalog narzędzi jedzie do modelu przy każdym wywołaniu. Dwadzieścia narzędzi po osiemdziesiąt tokenów definicji to tysiąc sześćset tokenów na obrót. Przy dziesięciokrokowym zadaniu — szesnaście tysięcy tokenów wejściowych za samo powiedzenie modelowi, co potrafi. Zanim padnie jedno pytanie.
To tłumaczy się dalej na koszt kumulacyjny pętli, o którym była mowa w pierwszym artykule. Dobra wiadomość: to akurat jest kandydat idealny do cache promptu, bo katalog jest stały.
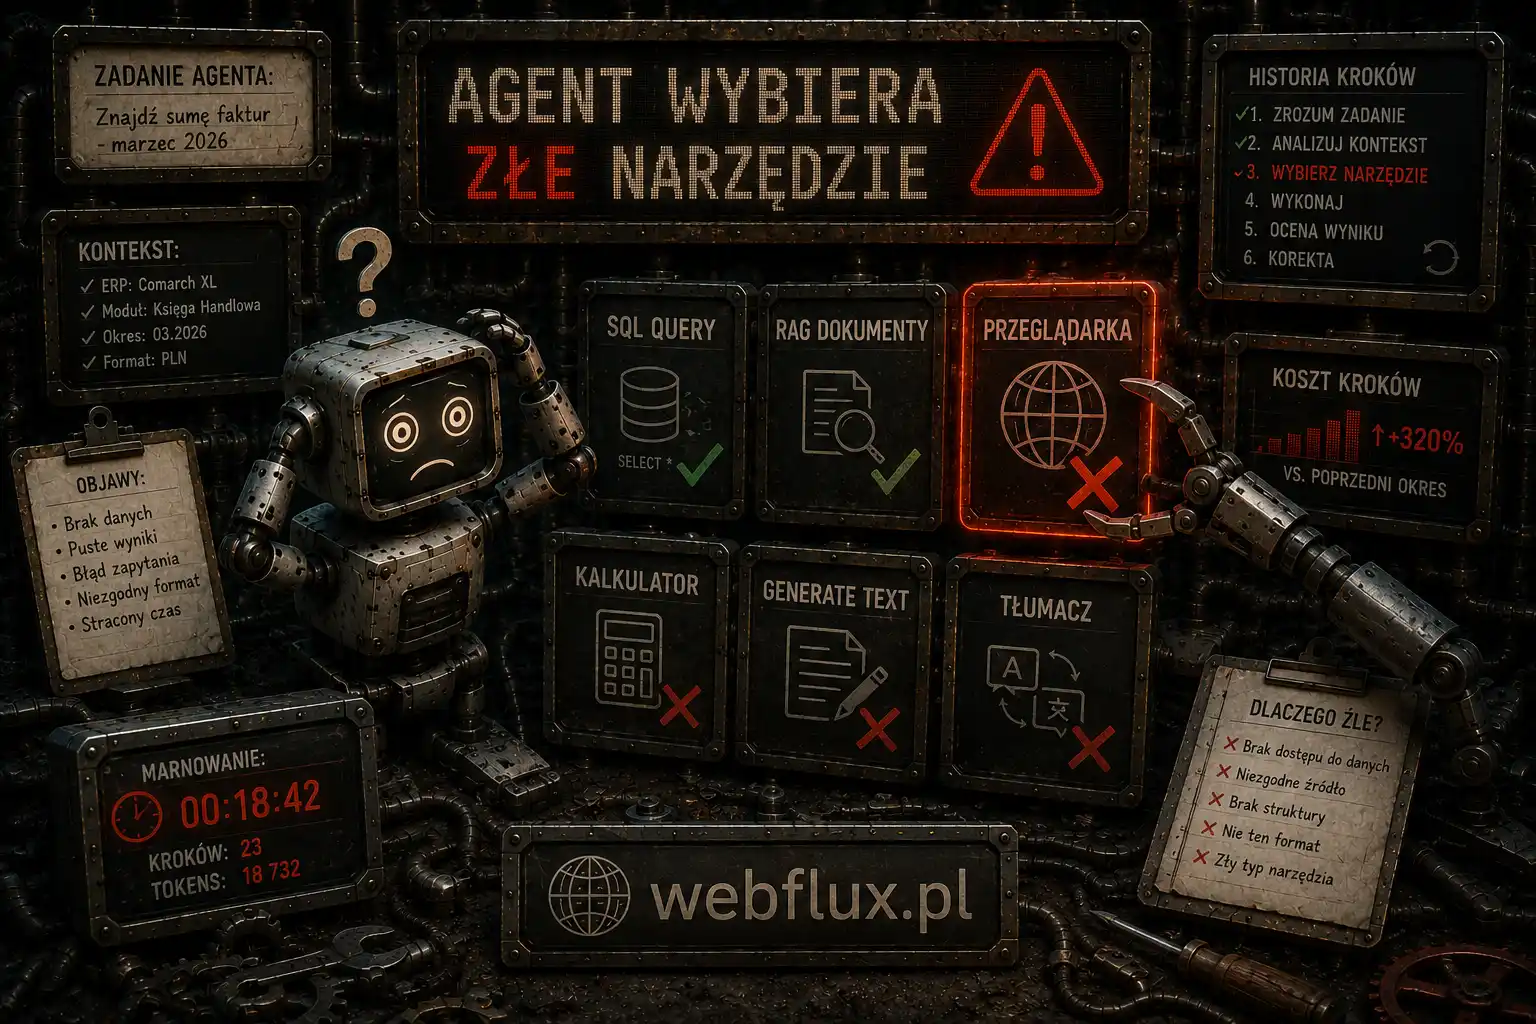
Koszt jakościowy jest trudniejszy i groźniejszy. Wraz z liczbą narzędzi spada trafność wyboru — najbardziej przy narzędziach pokrewnych, bo ich opisy realnie ze sobą konkurują.
Dlaczego jakość spada
Wynika to wprost z mechanizmu opisanego w Anatomii LLM. Model nie przegląda listy narzędzi metodycznie, po kolei, odrzucając nietrafione. Waży wszystko naraz. Każdy opis dostaje wagę, a opisy podobne dostają wagi zbliżone.
Przy dwóch narzędziach różnica między nimi jest wyraźna. Przy dwudziestu, z których siedem dotyczy zamówień, model rozstrzyga między siedmioma podobnymi kandydatami — i część tych rozstrzygnięć wypada losowo.
Dochodzi do tego drugi efekt: długi katalog to długi kontekst, a im dłuższy kontekst, tym bardziej rozmywa się wszystko inne, łącznie z instrukcjami.
Skąd bierze się rozrost
Rzadko z projektu. Zwykle z jednego z trzech nawyków.
Narzędzia jeden do jednego z API. Masz dwadzieścia endpointów, więc robisz dwadzieścia narzędzi. To najczęstszy anty-wzorzec w całym temacie: narzędzia projektuje się pod zadania agenta, nie pod strukturę API. Agent rzadko potrzebuje dostępu do wszystkiego, co system udostępnia.
Podłączenie kilku serwerów MCP naraz. Każdy wnosi własny katalog i katalogi się sumują. Trzy serwery po piętnaście narzędzi to czterdzieści pięć definicji w kontekście przy każdym obrocie — i to jest dziś najczęstsza droga do przeciążenia, bo podłączenie serwera wygląda na decyzję bezkosztową.
Dokładanie na zapas. Narzędzie dodane, bo „może się przydać”, zostaje w katalogu na zawsze i konkuruje z resztą przy każdym zapytaniu.
Cztery strategie
Ładowanie warunkowe. Model dostaje tylko narzędzia istotne dla bieżącego etapu zadania. Agent obsługi klienta w fazie diagnozy nie potrzebuje narzędzi do wystawiania faktur. To najskuteczniejsza strategia i jednocześnie wymagająca najwięcej pracy w pętli, bo ktoś musi wiedzieć, który etap trwa.
Grupowanie. Zamiast szukaj_po_numerze, szukaj_po_emailu, szukaj_po_telefonie — jedno narzędzie z parametrem określającym kryterium. Pięć definicji zamienia się w jedną, a model rozstrzyga w argumencie zamiast w wyborze.
Łączenie kroków. Jeśli dwa narzędzia są zawsze wywoływane po sobie, warto rozważyć jedno, które robi obie rzeczy. Oszczędzasz definicję, obrót pętli i całą wysyłkę kontekstu.
Rozdzielenie ról. Przy naprawdę dużych katalogach — planer i wykonawca, gdzie każda rola widzi swój wycinek. To jest odpowiedź na sytuację, w której trzy poprzednie strategie już nie wystarczają.
Gdzie grupowanie przestaje działać
Warto od razu postawić granicę, bo grupowanie łatwo przesadzić.
Narzędzie z dwunastoma opcjonalnymi parametrami, obsługujące osiem różnych przypadków, nie jest lepsze od ośmiu narzędzi. Przeniosłeś tylko problem z wyboru narzędzia na wybór argumentów — a tam nie działa walidacja schematu, bo formalnie wszystko jest dopuszczalne.
Test praktyczny: jeśli opis narzędzia musi tłumaczyć, w których przypadkach które parametry są istotne, to są to osobne narzędzia. Grupuj warianty tej samej czynności, nie różne czynności.
Ile to jest za dużo
Nie ma progu uniwersalnego i nieufnie podchodziłbym do liczb podawanych jako reguła. Wszystko zależy od tego, jak bardzo narzędzia są do siebie podobne i jak długie mają opisy — pięć narzędzi bliźniaczo podobnych daje gorsze wyniki niż piętnaście wyraźnie rozłącznych.
Miarą właściwą nie jest liczba, tylko trafność wyboru na twoim zestawie zapytań, mierzona przed dodaniem narzędzia i po nim. Ten sam zestaw, który zbudowałeś przy testowaniu definicji w poprzednim artykule, służy tutaj bez zmian.
Jak to sprawdzić u siebie
Kod mierzy trafność wyboru przy rosnącym katalogu — te same dwa narzędzia docelowe, dosypywane wypełniaczami — i przy okazji liczy, ile tokenów zajmują same definicje.
import json
from openai import OpenAI

client = OpenAI()

def f(nazwa, opis, pole):
    return {"type": "function", "function": {
        "name": nazwa, "description": opis,
        "parameters": {"type": "object",
                       "properties": {pole: {"type": "string"}},
                       "required": [pole]}}}

docelowe = [
    f("szukaj_zamowien",
      "Zwraca LISTĘ zamówień klienta. NIE używaj przy znanym numerze zamówienia.",
      "numer_klienta"),
    f("status_zamowienia",
      "Zwraca status JEDNEGO zamówienia o znanym numerze.",
      "numer_zamowienia"),
]

# wypełniacze celowo z tego samego obszaru — tak wygląda realny rozrost
wypelniacze = [
    f("historia_klienta", "Zwraca historię kontaktów z klientem", "numer_klienta"),
    f("faktury_klienta", "Zwraca faktury wystawione klientowi", "numer_klienta"),
    f("zwroty_klienta", "Zwraca zwroty zgłoszone przez klienta", "numer_klienta"),
    f("pozycje_zamowienia", "Zwraca pozycje zamówienia", "numer_zamowienia"),
    f("wysylka_zamowienia", "Zwraca dane wysyłki zamówienia", "numer_zamowienia"),
    f("platnosc_zamowienia", "Zwraca dane płatności zamówienia", "numer_zamowienia"),
    f("reklamacje_klienta", "Zwraca reklamacje klienta", "numer_klienta"),
    f("adresy_klienta", "Zwraca adresy dostawy klienta", "numer_klienta"),
    f("rabaty_klienta", "Zwraca przyznane rabaty", "numer_klienta"),
    f("dokumenty_zamowienia", "Zwraca dokumenty zamówienia", "numer_zamowienia"),
]

przypadki = [
    ("Gdzie jest zamówienie ZAM-4471?",             "status_zamowienia"),
    ("Co zamawiał klient KL-0012 w tym roku?",      "szukaj_zamowien"),
    ("Czy ZAM-9001 zostało wysłane?",               "status_zamowienia"),
    ("Pokaż zamówienia klienta KL-0300.",           "szukaj_zamowien"),
    ("Klient KL-0012 pyta o swoje zakupy.",         "szukaj_zamowien"),
    ("Sprawdź ZAM-1234.",                           "status_zamowienia"),
]

for ile in (0, 4, 10):
    katalog = docelowe + wypelniacze[:ile]
    trafienia = 0
    for pytanie, oczekiwane in przypadki:
        odp = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": pytanie}],
            tools=katalog,
        ).choices[0].message
        wybrane = odp.tool_calls[0].function.name if odp.tool_calls else "brak"
        trafienia += (wybrane == oczekiwane)
    znaki = len(json.dumps(katalog, ensure_ascii=False))
    print(f"{len(katalog):2} narzędzi  {trafienia}/{len(przypadki)}  "
          f"~{znaki // 4} tokenów definicji na obrót")
Wypełniacze są celowo z tego samego obszaru — tak wygląda realny rozrost katalogu, a nie dosypywanie narzędzi o pogodzie. Przy dwóch narzędziach wynik powinien być bezbłędny. Przy dwunastu zwykle zaczyna się sypać, i to na tych samych przypadkach za każdym razem.
Ostatnia kolumna pokazuje, ile płacisz za sam katalog w każdym obrocie. Pomnóż to przez typową liczbę kroków twojego agenta.
Drugie ćwiczenie: weź te przypadki, na których model się pomylił, i dopisz do definicji granice negatywne z poprzedniego artykułu. Zmierz ponownie. Dobre opisy odsuwają próg przeciążenia — nie usuwają go, ale przesuwają wyraźnie.
Co dalej
Wiemy, jak opisać narzędzia i ile ich pokazywać. Zostaje pytanie, co się dzieje, kiedy narzędzie zawiedzie — bo API mają awarie, limity i czasy oczekiwania, a to, co pętla powie wtedy modelowi, decyduje, czy agent znajdzie inną drogę, czy zacznie kręcić się w kółko.
O tym jest artykuł szósty: Kiedy narzędzie zawodzi.