W poprzednim artykule w kodzie pętli siedziała linia obrot < 8. Wpisana na sztywno, bez komentarza, żeby przykład się nie rozjechał.
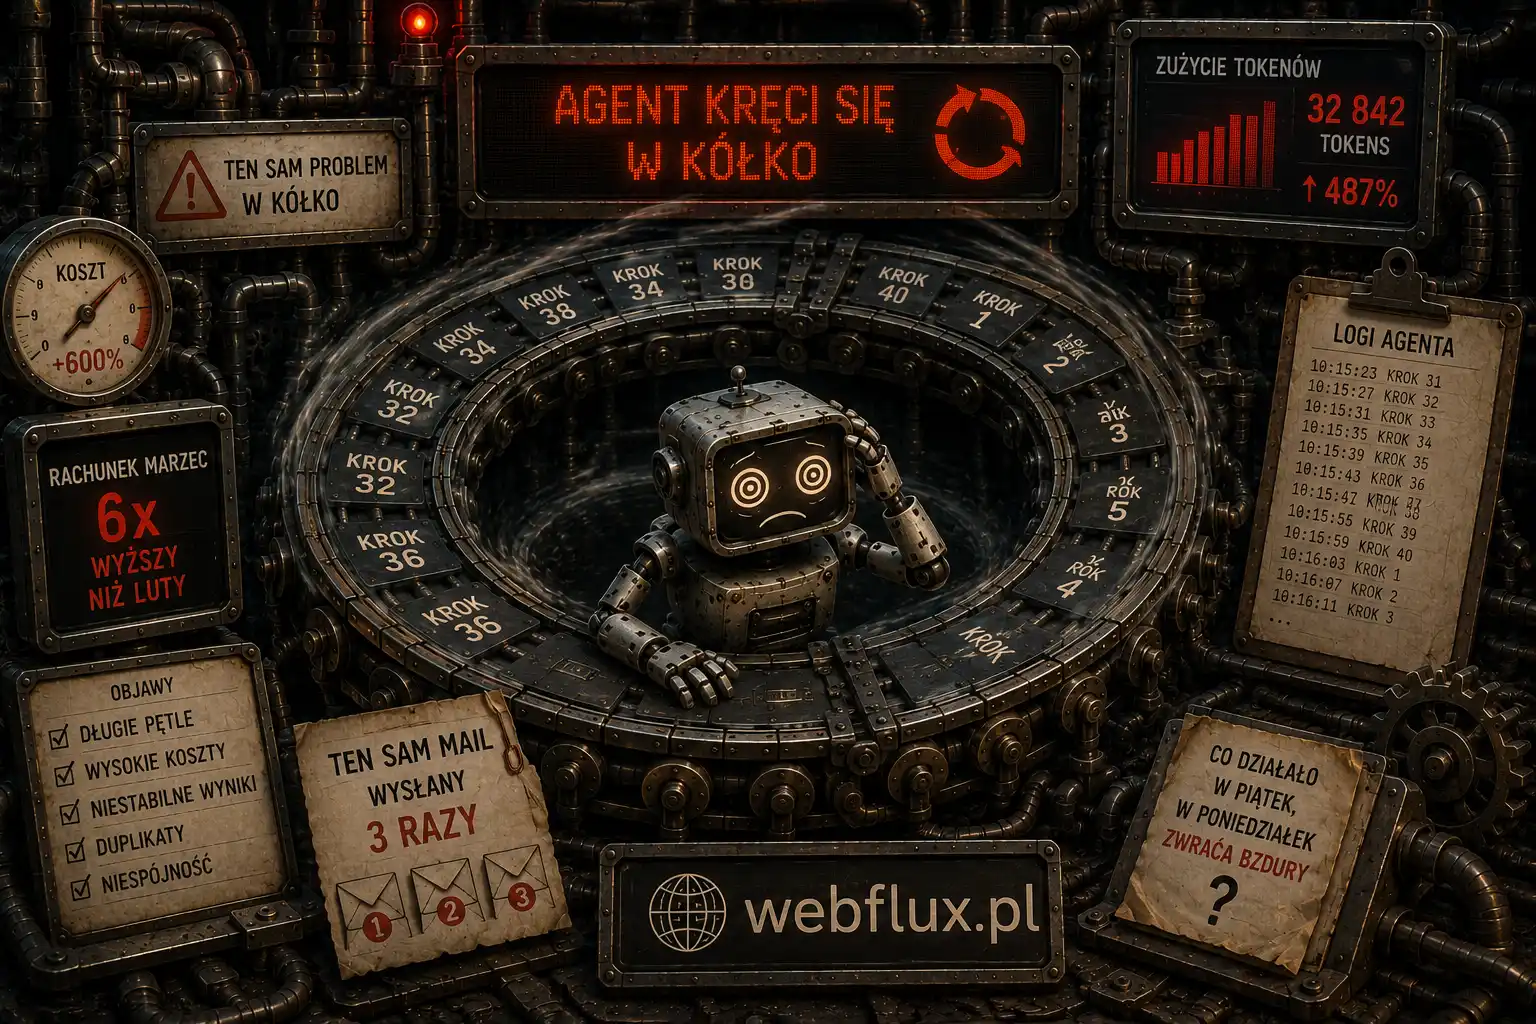
Ta jedna linia jest tematem całego tego tekstu. Bez niej pętla kręci się dopóty, dopóki model prosi o narzędzia — a model potrafi prosić bardzo długo, powtarzając w kółko ten sam krok.
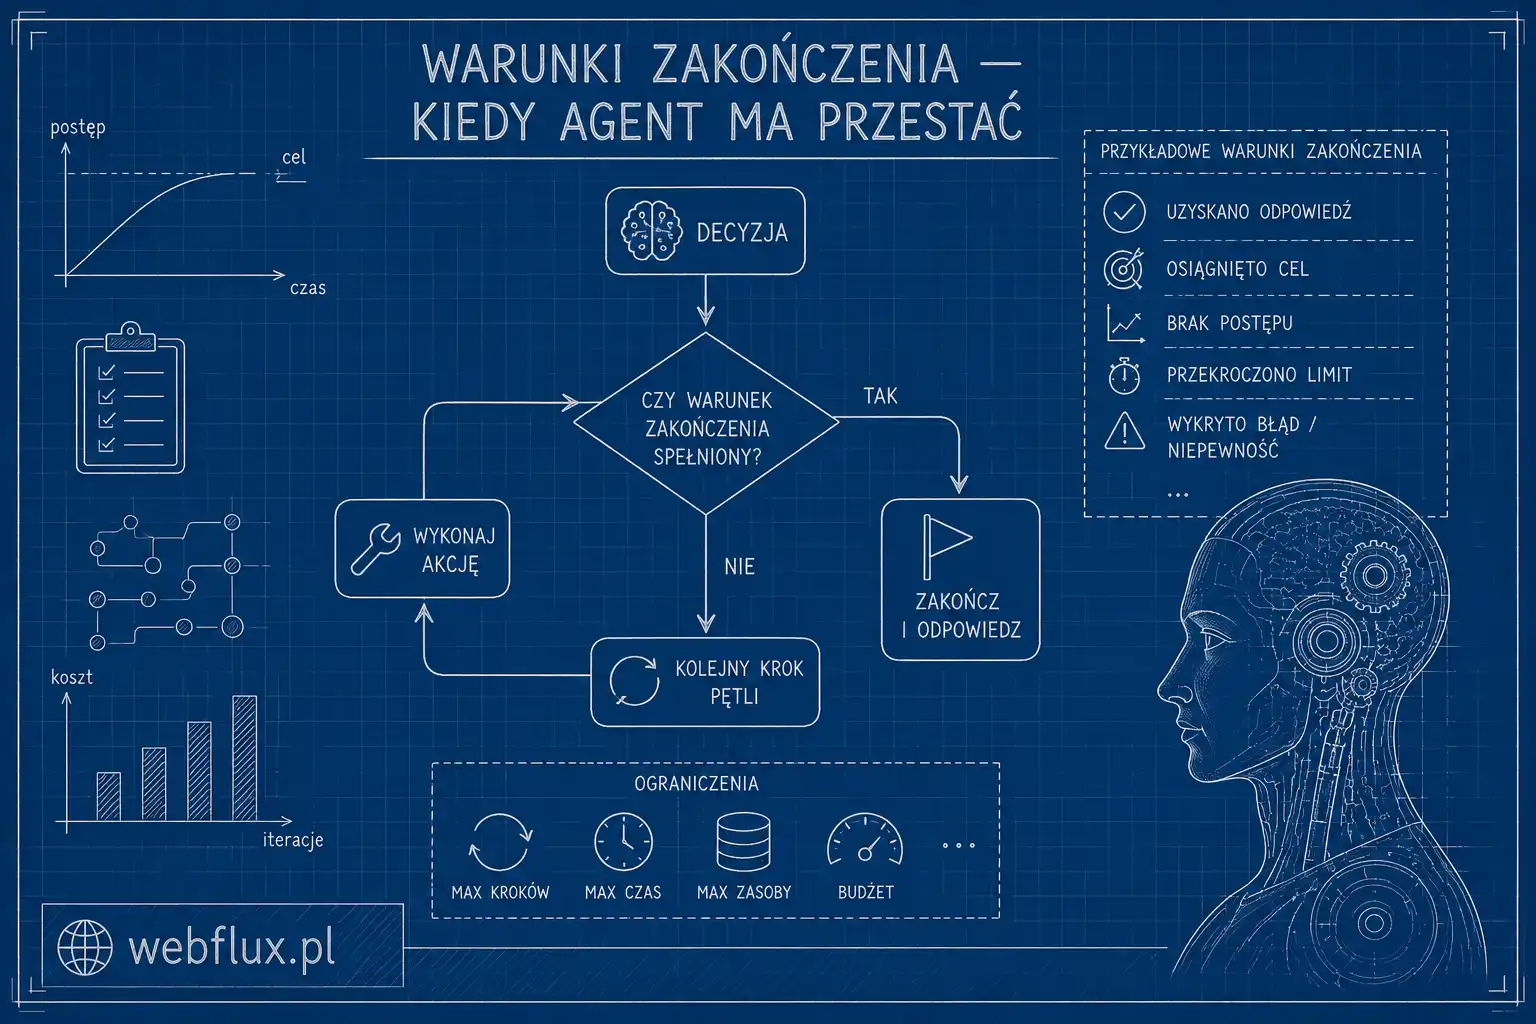
Cztery rodzaje warunków
Naturalny. Model zwrócił odpowiedź zamiast prośby o wywołanie narzędzia. To jedyny warunek wynikający z zachowania modelu i jedyny, na którym nie wolno poprzestać.
Limit kroków. Twarda górna granica liczby obrotów. To zabezpieczenie, nie mechanizm sterowania — jeśli agent regularnie w nie uderza, problem leży gdzie indziej.
Limit budżetu. Przerwanie po przekroczeniu zadanej liczby tokenów albo kosztu. W praktyce ważniejszy od limitu kroków, bo obroty mają bardzo różną cenę: krok, w którym narzędzie zwróciło pięćdziesiąt rekordów, kosztuje wielokrotnie więcej niż krok z trzema polami. Dziesięć kroków może oznaczać złotówkę albo dwadzieścia.
Limit czasu. Przerwanie po przekroczeniu czasu wykonania. Istotne wszędzie tam, gdzie na odpowiedź czeka człowiek albo system nadrzędny z własnym limitem.
Sensowna pętla ma wszystkie cztery. Trzy ostatnie nie są nadmiarowe — każdy łapie inny rodzaj wykolejenia.
Dlaczego model nie zatrzyma się sam
To wynika wprost z tego, co ustaliliśmy w Anatomii LLM: model nie ma dostępu do pętli i nie wie, ile kroków już wykonano, poza tym, co widzi w kontekście. Nie ma też pojęcia „poddaję się” — zawsze istnieje rozkład prawdopodobieństwa, a w nim kolejna prośba o narzędzie jest zwykle sensowną kontynuacją.
Model nie jest więc wykonawcą, który wie, kiedy skończyć. Jest funkcją, którą trzeba przestać wywoływać.
Zapętlenie i jego trzy postacie
Zapętlenie to najczęstsza awaria produkcyjna agentów i przybiera trzy formy.
Powtórzenie. To samo narzędzie, te same argumenty, raz za razem. Najłatwiejsze do wykrycia.
Oscylacja. Agent wywołuje na przemian dwa narzędzia, wracając wciąż w to samo miejsce. Sprawdzanie dwóch kolejnych kroków tego nie złapie, bo żadne dwa pod rząd nie są identyczne.
Dryf argumentów. Model wywołuje wciąż to samo narzędzie, minimalnie zmieniając zapytanie — raz z myślnikiem, raz bez, raz po polsku, raz po angielsku. Wygląda na postęp, nim nie jest.
Skąd się to bierze
Przyczyna jest mechaniczna. Model nie pamięta poprzedniego kroku — widzi tylko kontekst. Jeśli wynik narzędzia nie wniósł informacji, którą model szukał, sytuacja przy kolejnym obrocie wygląda niemal identycznie jak poprzednio. A niemal identyczne wejście daje niemal identyczną decyzję.
Najczęstszym wyzwalaczem jest narzędzie zwracające pustkę. Puste [] albo null to dla modelu sygnał nierozróżnialny: czy nic nie znaleziono, czy zapytanie było złe? Skoro nie wie, próbuje jeszcze raz.
To jest najtańsza naprawa w całym temacie i zarazem najczęściej pomijana: niech narzędzie mówi, co się stało. Nie [], tylko „nie znaleziono zamówień dla klienta 4471 w zakresie dat 2026-01-01 do 2026-06-30″. Model dostaje wtedy informację, która realnie zmienia kontekst, i może wybrać inną drogę zamiast powtarzać.
Jak wykrywać
Prosta wersja porównuje nazwę narzędzia i argumenty dwóch kolejnych wywołań. Łapie powtórzenie i nie łapie reszty.
Wersja użyteczna trzyma okno kilku ostatnich wywołań i liczy, ile razy powtórzyła się dana sygnatura. To wychwytuje także oscylację. Na dryf argumentów pomaga normalizacja przed porównaniem — sprowadzenie do małych liter, usunięcie spacji, uporządkowanie kluczy.
Co zrobić po wykryciu
Trzy sensowne reakcje.
Przerwać i zwrócić to, co udało się ustalić. Najbezpieczniejsze. Częściowy wynik z informacją o przerwaniu jest lepszy niż wynik pełny, ale zmyślony.
Wstrzyknąć do kontekstu jawną informację. „Krok wyszukiwania po numerze klienta został już wykonany i zwrócił zero wyników. Spróbuj innego podejścia albo zakończ.” To zmienia sytuację, którą model widzi — a więc może zmienić decyzję.
Eskalować do człowieka. Sensowne przy zadaniach o wysokiej stawce, gdzie przerwanie jest kosztowne.
Czwarta reakcja, najczęściej spotykana w praktyce, to milczące kontynuowanie do wyczerpania limitu. Kosztuje i nie kończy się niczym.
Zatrzymanie się to nie sukces
To rozróżnienie ginie w większości implementacji, a jest ważne.
Pętla może zakończyć się na cztery różne sposoby: model odpowiedział, wyczerpano limit kroków, wyczerpano budżet, wykryto zapętlenie. Tylko pierwszy oznacza, że zadanie prawdopodobnie zostało wykonane.
Agent przerwany limitem też coś zwróci — najczęściej odpowiedź niepełną, sformułowaną równie pewnie jak każda inna. Jeśli pętla nie odróżnia zakończenia normalnego od wymuszonego i nie przekazuje tego dalej, system nadrzędny potraktuje jedno i drugie tak samo.
Zwracaj więc nie samą odpowiedź, lecz odpowiedź razem z powodem zakończenia, liczbą kroków i zużytym budżetem. Bez tego nie da się ani sensownie monitorować, ani ocenić przebiegu — a ewaluacja trajektorii potrzebuje dokładnie tych danych.
Jak to sprawdzić u siebie
Pętla z poprzedniego artykułu, rozbudowana o cztery limity i wykrywanie zapętlenia. Narzędzie celowo zwraca pustkę, żeby zobaczyć mechanizm w działaniu.
import json, time
from openai import OpenAI

client = OpenAI()

def szukaj_zamowien(numer_klienta):
    return []                              # celowo: pustka bez wyjaśnienia

narzedzia = [{
    "type": "function",
    "function": {
        "name": "szukaj_zamowien",
        "description": "Wyszukuje zamówienia klienta po numerze",
        "parameters": {
            "type": "object",
            "properties": {"numer_klienta": {"type": "string"}},
            "required": ["numer_klienta"],
        },
    },
}]

MAX_KROKOW, MAX_TOKENOW, MAX_SEKUND, OKNO = 10, 20000, 30, 4

wiadomosci = [{"role": "user",
               "content": "Znajdź zamówienia klienta 4471 i podsumuj je."}]
historia, krok, tokeny, start = [], 0, 0, time.time()
powod = None

while True:
    if krok >= MAX_KROKOW:            powod = "limit kroków";  break
    if tokeny >= MAX_TOKENOW:         powod = "limit budżetu"; break
    if time.time() - start > MAX_SEKUND: powod = "limit czasu"; break

    krok += 1
    odp = client.chat.completions.create(
        model="gpt-4o-mini", messages=wiadomosci, tools=narzedzia
    )
    tokeny += odp.usage.total_tokens
    komunikat = odp.choices[0].message
    wiadomosci.append(komunikat)

    if not komunikat.tool_calls:
        powod = "model odpowiedział"
        break

    for w in komunikat.tool_calls:
        sygnatura = (w.function.name, w.function.arguments.strip().lower())
        historia.append(sygnatura)
        if historia[-OKNO:].count(sygnatura) >= 3:
            powod = "wykryto zapętlenie"

        wynik = szukaj_zamowien(**json.loads(w.function.arguments))
        wiadomosci.append({"role": "tool", "tool_call_id": w.id,
                           "content": json.dumps(wynik)})
    if powod:
        break

print(f"powód: {powod} | kroki: {krok} | tokeny: {tokeny}")
Uruchom i zobacz, ile obrotów agent wykonuje, zanim coś go zatrzyma. Prawdopodobnie kilka — i żaden nie przybliży go do celu.
Teraz najważniejsza część ćwiczenia. Zamień pustą listę na komunikat:
def szukaj_zamowien(numer_klienta):
    return {"znaleziono": 0,
            "komunikat": f"Brak zamówień dla klienta {numer_klienta}. "
                         f"Numer nie występuje w bazie."}
Uruchom ponownie. W większości przypadków agent zakończy po jednym wywołaniu, odpowiadając, że takiego klienta nie ma. Zmieniło się jedno zdanie w narzędziu — nie prompt, nie model, nie parametry.
To jest cała lekcja tego artykułu: zapętlenie zwykle nie jest problemem modelu, tylko projektu narzędzia.
Co dalej
Wszystko powyżej zakłada agenta, który dostaje zadanie i ma je skończyć. Istnieje jednak druga kategoria: agenci, którzy nie kończą wcale — działają w tle, budzą się co jakiś czas i sami decydują, czy jest coś do zrobienia.
Warunek zakończenia przestaje wtedy dotyczyć agenta, a zaczyna dotyczyć pojedynczego cyklu. Zmienia się też sposób liczenia budżetu i model nadzoru.
O tym jest artykuł trzeci: Agent wyzwalany kontra agent długo żyjący.