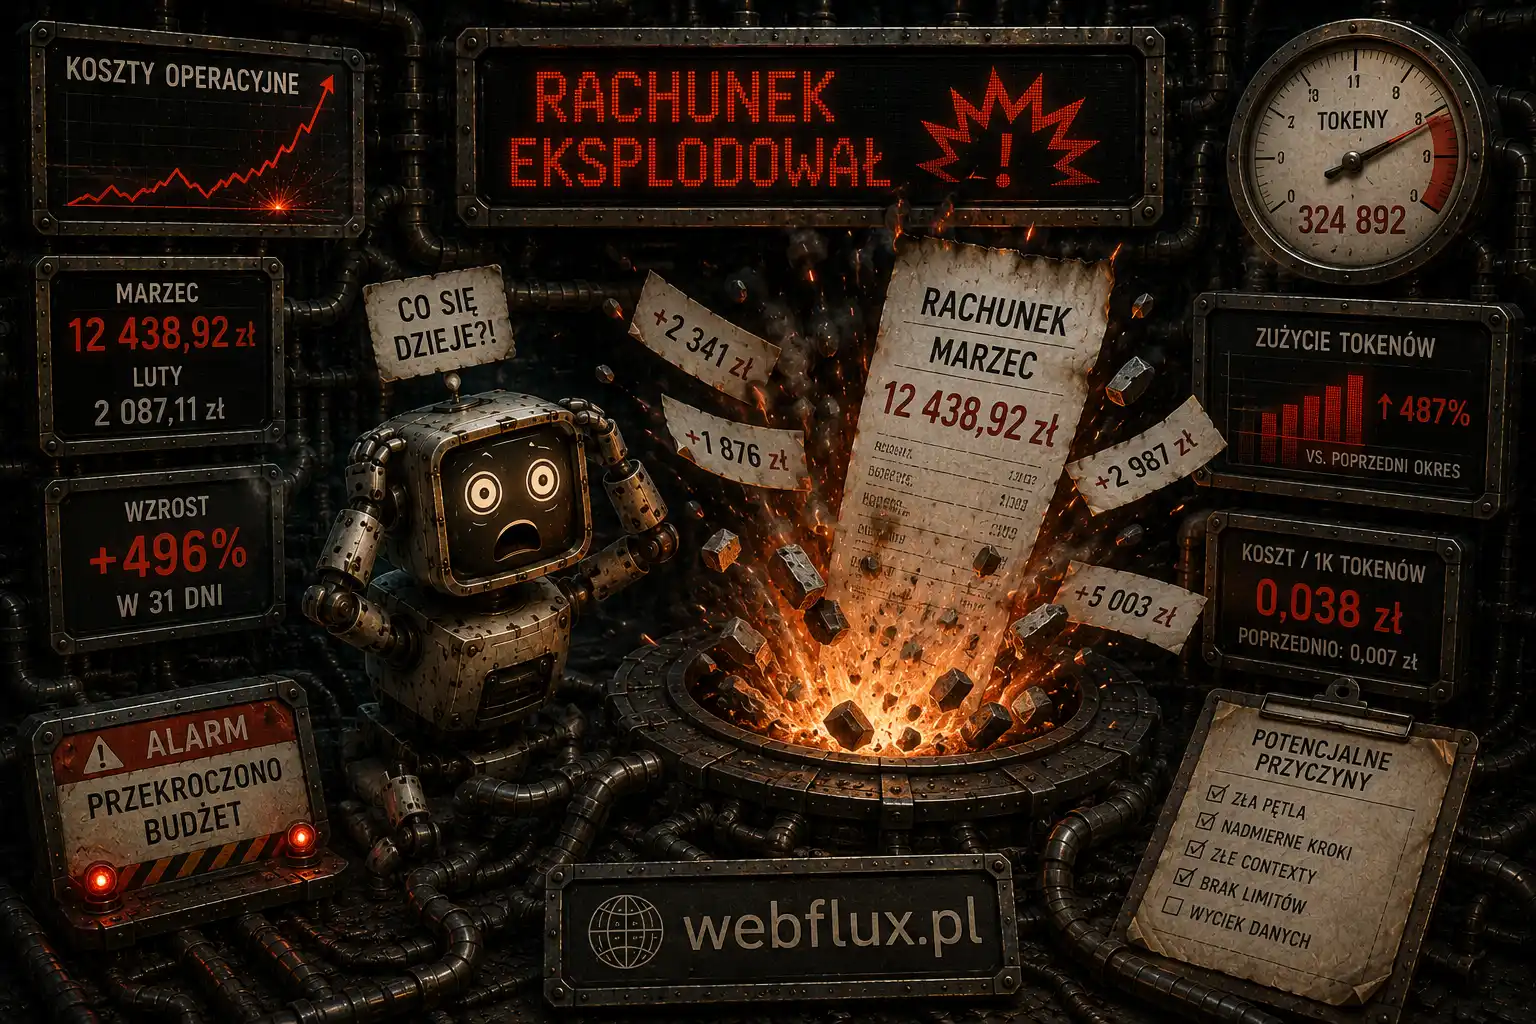
To samo pytanie, dwa modele. Pierwszy odpowiada po sekundzie. Drugi milczy pół minuty, wypisuje komunikat o myśleniu, a potem odpowiada — i na rachunku widnieje wielokrotność tego, co kosztował pierwszy.
Za tę różnicę czasem warto zapłacić dziesięciokrotnie. Czasem płacisz dziesięciokrotnie za nic. Rozstrzygnięcie zależy od tego, co dokładnie dzieje się w tej przerwie.
To nie jest nowy mechanizm
Zacznijmy od rozwiania nadziei, którą podsyca słowo „myślenie”.
Model rozumujący nie robi niczego, czego nie opisaliśmy w artykule pierwszym. Nadal przewiduje kolejny token, nadal token po tokenie, nadal bez dostępu do czegokolwiek poza kontekstem. Nie ma tam osobnego modułu rozumowania ani innej architektury.
Różnica polega na tym, co generuje przed odpowiedzią. Zanim napisze cokolwiek dla ciebie, produkuje długi ciąg tokenów dla siebie: rozpisuje kroki, rozważa warianty, wraca do wcześniejszych ustaleń. Dopiero potem formułuje odpowiedź, mając ten cały wywód w swoim kontekście.
Skoro model widzi wyłącznie to, co ma w kontekście, to wygenerowanie sobie pośrednich kroków realnie pomaga — bo przy formułowaniu odpowiedzi ma się o co oprzeć. Rozumowanie nie jest tu metaforą procesu wewnętrznego. Jest dosłownie tekstem, który model sobie dopisał.
Czym to się różni od chain-of-thought w prompcie
Trik z proszeniem modelu, żeby „myślał krok po kroku”, jest znany od dawna i nadal działa. Chain-of-thought to technika promptowa — mówisz modelowi, jak ma się zachować, a on rozpisuje kroki w normalnej odpowiedzi.
W modelach rozumujących to samo zachowanie jest wtrenowane, i to nie przykładami, lecz uczeniem ze wzmocnieniem na zadaniach z weryfikowalnym wynikiem. Model dostaje sygnał za dojście do poprawnej odpowiedzi, więc wypracowuje sposoby rozumowania, które faktycznie do niej prowadzą — łącznie z wycofywaniem się z błędnej ścieżki i sprawdzaniem własnego wyniku.
Praktyczne różnice są trzy. Rozumowanie odpala się samo, bez proszenia. Jest znacznie dłuższe niż to, które wyprosisz promptem. I jest rozliczane osobno — o czym za chwilę, bo to najważniejsza pułapka w całym temacie.
Nowa oś skalowania
To jest szersza zmiana, niż wygląda z perspektywy jednego zapytania.
Przez lata jedynym sposobem na lepszy model było zbudowanie większego: więcej parametrów, więcej danych, dłuższy trening. Kosztowne, powolne i wymagające ogromnej infrastruktury.
Modele rozumujące dokładają drugą oś: więcej obliczeń w momencie odpowiadania. Ten sam model może myśleć krócej albo dłużej, a wraz z długością rozumowania rośnie skuteczność w zadaniach złożonych. Jakość staje się parametrem, który ustawiasz per zapytanie, zamiast być cechą modelu, którą dostajesz z góry.
Dla ciebie oznacza to jedno: koszt przestaje być pochodną wyłącznie długości promptu i odpowiedzi. Dochodzi trzeci składnik, którego nie widać.
Płacisz za tokeny, których nie zobaczysz
Tokeny rozumowania są liczone jako wyjściowe i rozliczane po stawce wyjściowej. Bywają przy tym kilkukrotnie liczniejsze niż sama odpowiedź.
Jednocześnie większość dostawców ich nie pokazuje — albo ukrywa całkowicie, albo prezentuje streszczenie. Powstaje sytuacja, w której główny składnik rachunku jest niewidoczny w interfejsie.
Stąd bierze się zaskoczenie przy pierwszej fakturze i stąd praktyczna zasada: przy modelach rozumujących trzeba czytać pole z liczbą tokenów rozumowania w odpowiedzi API, a nie szacować koszt na oko z długości tekstu. Aneks na dole pokazuje, gdzie tego szukać.
Druga konsekwencja dotyczy opóźnienia. Trzydzieści sekund myślenia to trzydzieści sekund, przez które użytkownik patrzy w ekran. W zastosowaniach interaktywnych bywa to koszt większy niż finansowy.
Czy ten wywód to wyjaśnienie?
Tu potrzebne jest to samo zastrzeżenie, które postawiliśmy przy attention — i z tego samego powodu.
Kuszące jest czytanie rozumowania jako zapisu tego, jak model doszedł do odpowiedzi. Badania nad wiernością tych zapisów pokazują, że tak nie jest: model potrafi w wywodzie napisać jedno, a odpowiedzieć zgodnie z czymś innym, i potrafi pominąć w rozumowaniu przesłankę, która realnie zaważyła na wyniku.
Wywód jest wygenerowanym tekstem, który pomaga dojść do odpowiedzi, a nie protokołem z procesu decyzyjnego. To użyteczne narzędzie i kiepski dowód. Traktowanie go jako uzasadnienia — zwłaszcza tam, gdzie trzeba wykazać podstawy decyzji — jest nieporozumieniem.
Kiedy się opłaca, a kiedy nie
Reguła wynika wprost z tego, jak te modele trenowano: na zadaniach, w których da się sprawdzić, czy wynik jest poprawny.
Opłaca się przy matematyce i obliczeniach, przy kodzie i debugowaniu, przy planowaniu wielokrokowym, przy analizie z wieloma warunkami naraz, przy zadaniach, w których trzeba wychwycić sprzeczność w materiale.
Nie opłaca się przy ekstrakcji danych z dokumentu, klasyfikacji, streszczaniu, przepisywaniu, tłumaczeniu, generowaniu treści i zwykłej rozmowie. Tu rozumowanie jest czystym narzutem — kosztuje, opóźnia i nie poprawia wyniku, bo nie ma czego rozważać.
Warto też wiedzieć o zjawisku odwrotnym do oczekiwanego: model rozumujący potrafi rozmyślać nad zadaniem trywialnym. Zapytany o rzecz oczywistą wygeneruje akapity rozważań, zanim odpowie. Część dostawców daje parametr sterujący wysiłkiem rozumowania i przy prostych zadaniach warto go świadomie obniżać.
W agencie: nie wszędzie to samo
Wraca wzorzec z poprzedniego artykułu, tylko na innej osi.
Agent wykonuje kroki różnego rodzaju. Rozłożenie zadania na etapy i wybór strategii to miejsce, gdzie rozumowanie realnie pomaga. Wyciągnięcie trzech pól z odpowiedzi narzędzia i sformatowanie podsumowania — nie.
Ustawianie modelu rozumującego na wszystkie kroki pętli to najprostszy sposób na wielokrotne przepłacenie i na agenta, który myśli dłużej, niż działa. Sensowny podział to model rozumujący w kroku planowania i szybki model w krokach wykonawczych.
I ostrzeżenie na koniec: rozumowanie nie usuwa halucynacji. Zmniejsza część błędów wynikających z pośpiechu, ale sam wywód powstaje tym samym mechanizmem co odpowiedź — więc może być równie przekonującą konfabulacją, tylko dłuższą. Weryfikacja wobec źródła prawdy nadal należy do warstwy nad modelem.
Jak to sprawdzić u siebie
Ćwiczenie pokazuje, gdzie znika twój budżet. Dwa zadania — trywialne i złożone — i porównanie liczby tokenów rozumowania.
from openai import OpenAI
client = OpenAI()

zadania = [
    ("proste",  "Ile to jest 17 + 25?"),
    ("złożone", "Mam trzy paczki: 2,4 kg, 1,1 kg i 3,8 kg. Kurier liczy 15 zł "
                "za paczkę do 2 kg i 22 zł powyżej, ale przy trzech paczkach "
                "daje 10% rabatu na całość. Ile zapłacę?"),
]

for etykieta, tresc in zadania:
    r = client.chat.completions.create(
        model="o4-mini",
        messages=[{"role": "user", "content": tresc}],
    )
    u = r.usage
    detale = getattr(u, "completion_tokens_details", None)
    rozumowanie = getattr(detale, "reasoning_tokens", 0) if detale else 0
    widoczne = u.completion_tokens - rozumowanie
    print(f"{etykieta:8} rozumowanie {rozumowanie:5}   widoczne {widoczne:4}")
Przy zadaniu prostym stosunek bywa absurdalny — kilkaset tokenów rozumowania na kilkunastotokenową odpowiedź. Przy złożonym rozumowanie zarabia na siebie.
Drugie ćwiczenie: uruchom to samo złożone zadanie na zwykłym modelu bez rozumowania i porównaj poprawność oraz koszt. Dopiero to zestawienie odpowiada na pytanie, czy w twoim przypadku warto — bo przy części zadań, które wyglądają na trudne, zwykły model radzi sobie równie dobrze za ułamek ceny.
Nazwy modeli i pól różnią się między dostawcami; część udostępnia też parametr sterujący długością rozumowania, którym warto pobawić się na własnych przypadkach.
Co dalej
Przeszliśmy przez cały model: od tokenów, przez znaczenie, uwagę, trening i generowanie, po koszt i rozmiar. Wiemy, co model robi.
Zostało ustalić, czego nie robi — i gdzie dokładnie przebiega granica między nim a wszystkim, co buduje się nad nim.
O tym jest artykuł dwunasty: Gdzie kończy się model — granica między modelem, pętlą i agentem.