Pętla agenta to trzydzieści linii kodu. Prawie nikt ich nie napisał, bo prawie wszyscy używają frameworka — i to jest rozsądne. Problem zaczyna się wtedy, gdy agent zachowuje się dziwnie, a ty nie wiesz, co dokładnie dzieje się między pytaniem użytkownika a odpowiedzią, bo między nimi jest czarna skrzynka.
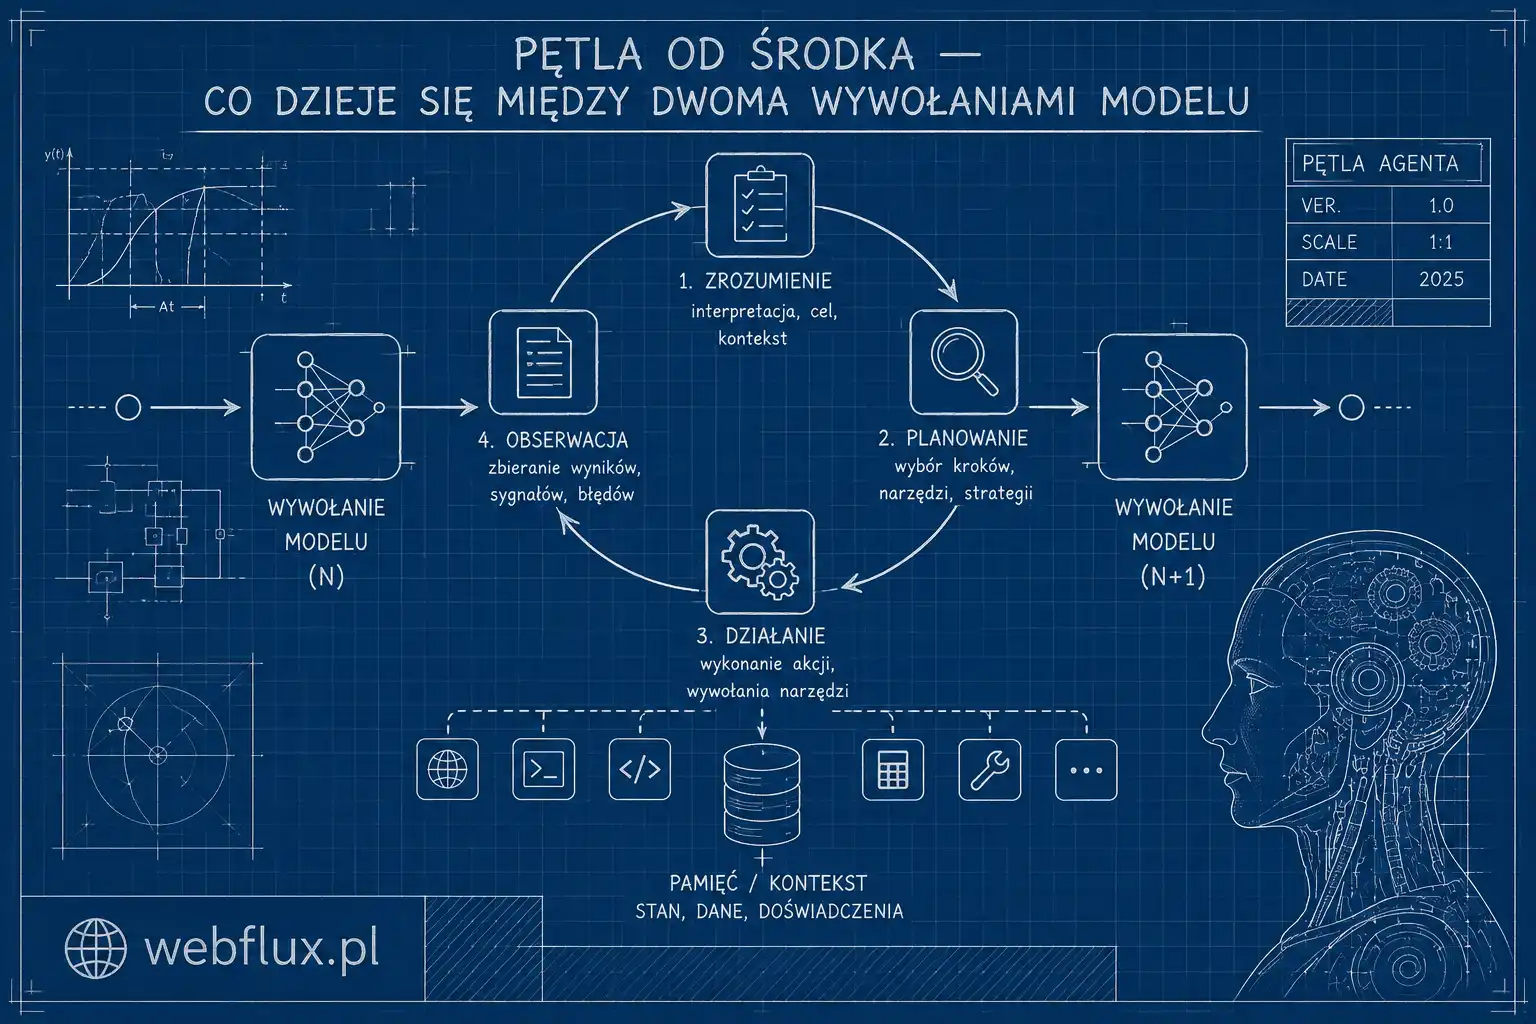
Nie ma tam nic tajemniczego. Jest sześć kroków, powtarzanych w kółko.
Sześć kroków jednego obrotu
Zbudowanie kontekstu. Pętla składa całą sekwencję, którą za chwilę wyśle: instrukcje systemowe, definicje narzędzi, historię dotychczasowych kroków, wyniki wcześniejszych wywołań, pytanie użytkownika. To nie jest doklejanie jednej wiadomości — to złożenie całości od zera.
Wywołanie modelu. Sekwencja idzie do modelu, który zwraca tekst. Nic więcej się tu nie dzieje.
Rozpoznanie wyjścia. Pętla sprawdza, czy to odpowiedź dla użytkownika, czy prośba o wywołanie narzędzia. Przy nowoczesnych API dostajesz to w ustrukturyzowanym polu, ale pod spodem to nadal wygenerowany tekst, który ktoś sparsował.
Decyzja. Czy to wykonać. Czy argumenty są sensowne. Czy potrzebna jest zgoda użytkownika. Czy nie przekroczyliśmy limitu. Ten krok jest w całości twój — model nie ma na niego wpływu.
Wykonanie i zebranie wyniku. Funkcja jest odpalana, zwraca dane. Mogą to być trzy pola albo pięćset rekordów.
Dopisanie wyniku. Wynik trafia do historii w formacie, który model zrozumie — i tu zapada decyzja, ile z niego przekazać. Całość? Streszczenie? Pierwsze dziesięć rekordów?
Potem wszystko wraca do kroku pierwszego.
Model nie ma stanu — stan ma pętla
To jest najważniejsza rzecz w tym artykule i wynika wprost z tego, co ustaliliśmy w Anatomii LLM: wagi modelu są zamrożone, więc między wywołaniami nie zostaje w nim absolutnie nic.
Model nie pamięta poprzedniego kroku. Nie wie, że jest w połowie zadania. Nie wie nawet, że to samo zadanie — dostaje po prostu dłuższą sekwencję niż poprzednio.
Ciągłość, którą widzi użytkownik, jest w całości iluzją utrzymywaną przez pętlę. To ona przechowuje historię i wysyła ją od nowa przy każdym obrocie. Agent nie kontynuuje pracy — zaczyna od zera z coraz dłuższą notatką.
Ma to konsekwencję, którą warto mieć w głowie przy debugowaniu: jeśli czegoś nie ma w kontekście, to dla modelu nie istnieje. Nieważne, że działo się trzy kroki wcześniej, że jest w twojej bazie albo że wypisałeś to do logów.
Skąd bierze się kwadratowy rachunek
Skoro cały kontekst idzie do modelu przy każdym obrocie, a przy każdym obrocie rośnie, to koszt nie rośnie liniowo z liczbą kroków.
Załóżmy, że instrukcje i definicje narzędzi to tysiąc tokenów, a każdy krok dokłada pięćset. Pierwszy obrót wysyła tysiąc pięćset. Drugi dwa tysiące. Dziesiąty sześć tysięcy. Suma za całe zadanie to nie sześć tysięcy, tylko około trzydziestu siedmiu tysięcy tokenów wejściowych.
Dziesięć kroków to dziesięciokrotność liczby wywołań i mniej więcej dwudziestopięciokrotność kosztu pojedynczego zapytania. Dlatego agent, który w testach na trzech krokach kosztował grosze, potrafi zaskoczyć na produkcji, gdzie zadania mają kroków dwanaście.
Dwie rzeczy realnie to ograniczają i obie należą do pętli. Pierwsza to cache promptu — stały początek sekwencji rozliczany taniej, pod warunkiem że jest naprawdę stały. Druga to decyzja z kroku szóstego: ile z wyniku narzędzia dopisać do historii. Pięćset rekordów wrzuconych w całości będzie wysyłanych ponownie przy każdym kolejnym obrocie.
Trzy rzeczy, które framework robi za ciebie
Warto wiedzieć, że je robi, bo to tam mieszkają najczęstsze niespodzianki.
Składa historię i decyduje, co w niej zostaje. Niektóre frameworki trzymają wszystko, inne przycinają starsze kroki, jeszcze inne podmieniają je na streszczenie. To zmienia zachowanie agenta w długich przebiegach i rzadko jest widoczne w konfiguracji.
Zamienia wynik narzędzia na tekst. Twoja funkcja zwróciła obiekt, a model potrzebuje znaków. Ktoś to serializuje — i sposób serializacji ma znaczenie, o czym jest osobny artykuł w serii o context engineeringu.
Obsługuje sytuacje, gdy model zwróci coś niepoprawnego. Niedomknięty JSON, nieistniejąca nazwa funkcji, brakujący argument. Większość frameworków po cichu ponawia — czyli płacisz za wywołanie, którego nie widzisz w żadnym logu.
Pętla jest sekwencyjna, dopóki jej nie zrównoleglisz
Domyślnie wszystko dzieje się po kolei: jedno wywołanie modelu, jedno narzędzie, kolejne wywołanie modelu. Przy zadaniu wymagającym sprawdzenia trzech niezależnych rzeczy oznacza to trzy pełne obroty i trzykrotność opóźnienia.
Współczesne modele potrafią poprosić o kilka wywołań naraz — i wtedy pętla może je wykonać równolegle, a wyniki dopisać razem. To jedna z niewielu optymalizacji, która skraca czas, nie pogarszając niczego innego.
Warunek: wywołania muszą być od siebie niezależne. Jeśli drugie potrzebuje wyniku pierwszego, model i tak poprosi o nie osobno, w kolejnych obrotach.
Jak to sprawdzić u siebie
Poniższa pętla jest minimalna, ale ma jedną rzecz, której nie ma większość frameworków: pokazuje, jak rośnie kontekst i ile realnie kosztuje każdy obrót.
import json
from openai import OpenAI

client = OpenAI()

def stan_zamowienia(numer):
    return {"numer": numer, "status": "w drodze", "kurier": "DPD"}

def dane_klienta(numer):
    return {"numer": numer, "klient": "Kowalski", "miasto": "Wrocław"}

funkcje = {"stan_zamowienia": stan_zamowienia, "dane_klienta": dane_klienta}

narzedzia = [{
    "type": "function",
    "function": {
        "name": nazwa,
        "description": f"Zwraca dane: {nazwa}",
        "parameters": {
            "type": "object",
            "properties": {"numer": {"type": "string"}},
            "required": ["numer"],
        },
    },
} for nazwa in funkcje]

wiadomosci = [{"role": "user", "content":
               "Gdzie jest zamówienie 4471 i do kogo ma trafić?"}]

obrot, suma_wejscie = 0, 0
while obrot < 8:
    obrot += 1
    odp = client.chat.completions.create(
        model="gpt-4o-mini", messages=wiadomosci, tools=narzedzia
    )
    u = odp.usage
    suma_wejscie += u.prompt_tokens
    print(f"obrót {obrot}: wejście {u.prompt_tokens:5}   "
          f"suma wejścia {suma_wejscie:6}")

    komunikat = odp.choices[0].message
    wiadomosci.append(komunikat)

    if not komunikat.tool_calls:
        print("\nODPOWIEDŹ:", komunikat.content)
        break

    for wywolanie in komunikat.tool_calls:
        argumenty = json.loads(wywolanie.function.arguments)
        wynik = funkcje[wywolanie.function.name](**argumenty)
        wiadomosci.append({
            "role": "tool",
            "tool_call_id": wywolanie.id,
            "content": json.dumps(wynik, ensure_ascii=False),
        })
Uruchom i popatrz na drugą kolumnę. Liczba tokenów wejściowych rośnie z każdym obrotem, mimo że pytanie zadałeś raz. Suma na końcu jest tym, za co faktycznie płacisz — i jest wielokrotnie wyższa niż długość ostatniego kontekstu.
Teraz eksperyment, który to unaocznia: zmień jedną z funkcji tak, żeby zwracała dużą strukturę — na przykład listę pięćdziesięciu pozycji zamiast trzech pól. Wywołaj ponownie. Zobaczysz, że jednorazowo duży wynik podnosi koszt wszystkich kolejnych obrotów, bo od tego momentu jest wysyłany za każdym razem.
To jest cały argument za przycinaniem wyników narzędzi, pokazany w dwóch przebiegach.
Co dalej
W pętli powyżej jest warunek obrot < 8, wpisany na sztywno. Bez niego pętla może kręcić się dopóty, dopóki model prosi o narzędzia — a on potrafi prosić w nieskończoność, powtarzając ten sam krok w kółko.
Kiedy zatrzymać agenta i jak rozpoznać, że utknął, jest pytaniem trudniejszym, niż wygląda.
O tym jest artykuł drugi: Warunki zakończenia — kiedy agent ma przestać.