Wszystkie dotychczasowe przykłady zakładały, że narzędzie działa. W produkcji to założenie jest fałszywe częściej, niż się zakłada przy projektowaniu: API mają awarie, limity, przeciążenia i czasy oczekiwania.
To, co pętla zrobi w takim momencie — i co powie o tym modelowi — decyduje o tym, czy agent jest odporny, czy tylko drogi.
Cztery rodzaje awarii
Traktowanie ich jednym except jest najczęstszym błędem, bo każdy wymaga innej reakcji.
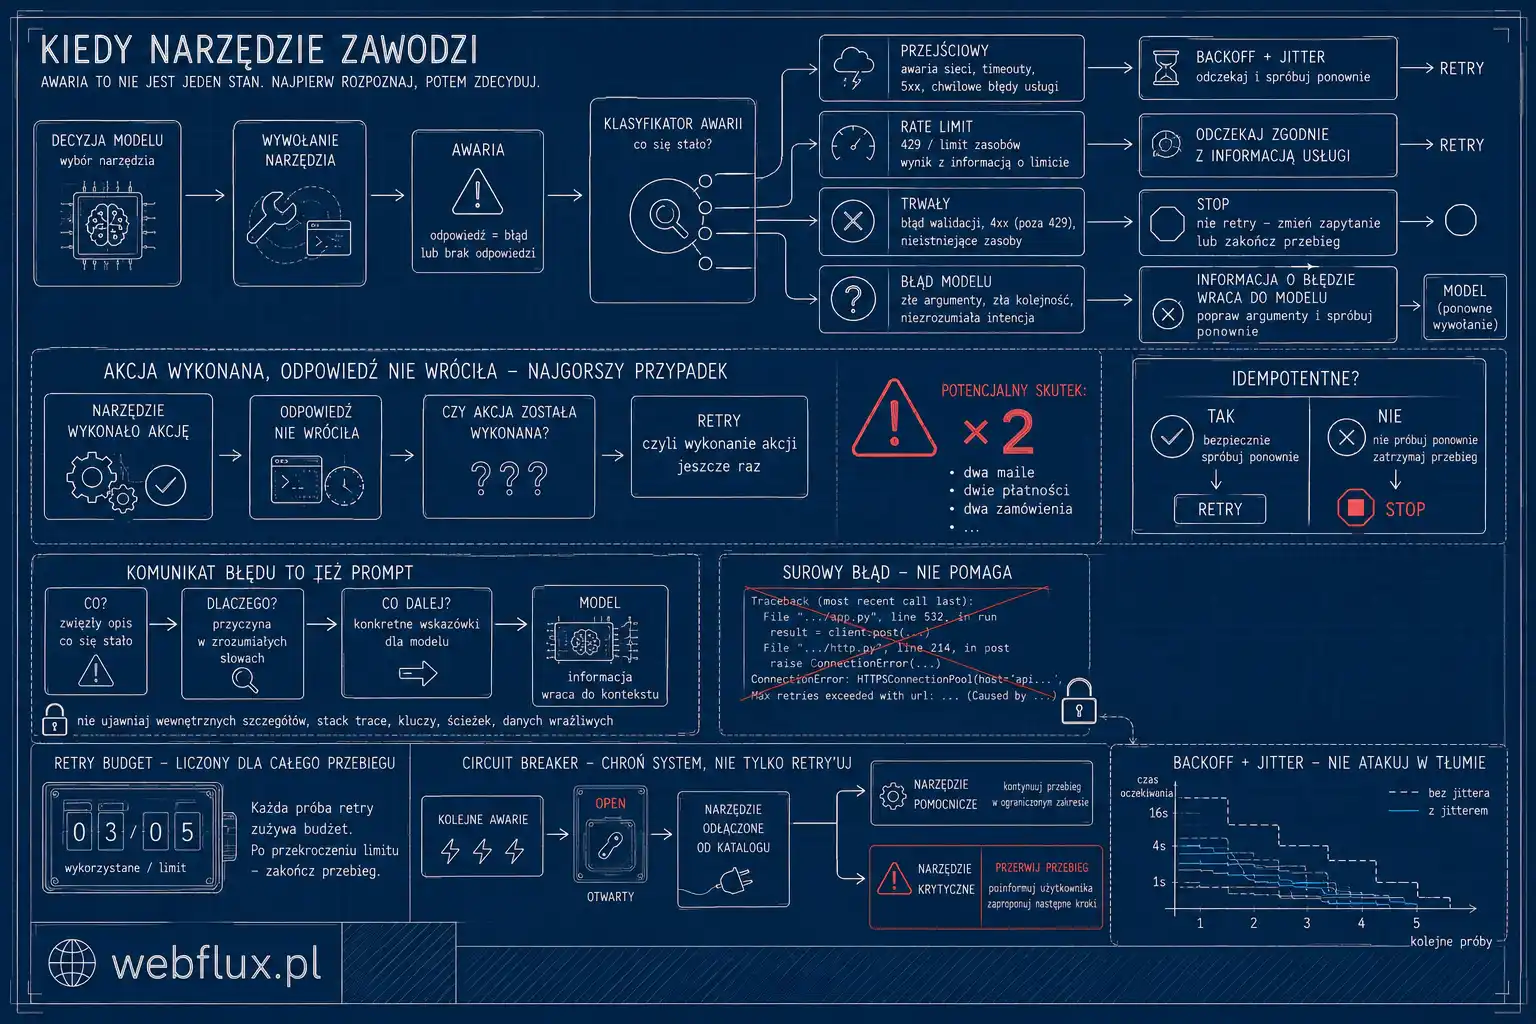
Przejściowa awaria techniczna. Przekroczony czas oczekiwania, błąd sieci, chwilowa niedostępność usługi. Warunki mogą się zmienić za sekundę, więc ponowienie ma sens.
Przekroczony limit zapytań. Formalnie też błąd przejściowy, ale wymaga innego traktowania: usługa mówi wprost, że jest za szybko. Ponowienie natychmiast pogarsza sytuację, a jeśli odpowiedź niesie informację o czasie oczekiwania, należy ją uszanować zamiast zgadywać.
Błąd trwały. Zasób nie istnieje, brak uprawnień, argument niepoprawny. Ponawianie nie ma tu żadnego sensu — sytuacja nie zmieni się bez zmiany zapytania. To najczęściej marnowana kategoria: pętle ponawiają trzy razy coś, co nigdy nie zadziała.
Błąd po stronie modelu. Niedomknięta struktura argumentów, nieistniejąca nazwa funkcji, brakujące pole wymagane. To nie jest awaria narzędzia — narzędzie w ogóle nie zostało wywołane. Ponowienie oznacza tu pełne wywołanie modelu, czyli realny koszt, i ma sens wyłącznie wtedy, gdy do kontekstu wróci informacja, co było nie tak.
Backoff i po co jest rozrzut
Ponawianie natychmiast po błędzie zwykle pogarsza sytuację. Standardem jest odczekanie rosnącego odstępu przed każdą kolejną próbą.
Do tego dochodzi element, który bywa pomijany: niewielki losowy rozrzut. Bez niego wszystkie równoległe sesje, które zawiodły w tym samym momencie, ponowią próbę dokładnie w tej samej chwili — i wywrócą usługę drugi raz. Rozrzut rozkłada je w czasie.
Przy agencie długo żyjącym, który budzi się cyklicznie, to szczególnie istotne: bez rozrzutu cała flota instancji uderza w API zsynchronizowana co do sekundy.
Ponowienie a skutki uboczne
Tu jest przypadek, który w kodzie agentów widuje się najrzadziej, a kosztuje najwięcej.
Narzędzie wykonało operację, ale odpowiedź nie wróciła — zerwane połączenie, przekroczony czas po stronie klienta. Z perspektywy pętli to nieudane wywołanie. Z perspektywy systemu docelowego: mail został wysłany, płatność przeszła, zamówienie zostało utworzone.
Ponowienie w takiej sytuacji wykonuje operację drugi raz.
Dlatego reguła z hasła o idempotencji obowiązuje bez wyjątku: narzędzie o skutkach ubocznych jest albo idempotentne, albo nie wolno go automatycznie ponawiać. Trzeciej możliwości nie ma. Jeśli operacja nie jest odporna na powtórzenie, po nieudanym wywołaniu należy przerwać i zapytać, a nie próbować ponownie.
Komunikat błędu jest promptem
W artykule o definicjach ustaliliśmy, że opis narzędzia jest promptem. To samo dotyczy tego, co narzędzie zwraca po niepowodzeniu — bo ten tekst trafia do kontekstu i staje się podstawą kolejnej decyzji modelu.
Widzieliśmy już, co się dzieje przy braku informacji: puste [] z drugiego artykułu wystarczyło, żeby agent wpadł w zapętlenie. Surowy ślad wyjątku działa podobnie — jest długi, kosztuje tokeny i nie mówi modelowi, co zrobić dalej.
Dobry komunikat błędu odpowiada na trzy pytania: co się nie udało, dlaczego, i czy da się coś z tym zrobić.
Zamiast ConnectionTimeout at line 47 — „Nie udało się połączyć z systemem zamówień. Problem przejściowy, spróbuj ponownie za chwilę lub zakończ, informując użytkownika o niedostępności.”
Zamiast 404 — „Zamówienie ZAM-9999 nie istnieje. Sprawdź numer lub użyj szukaj_zamowien, żeby znaleźć właściwy.”
Druga wersja jest dłuższa i tańsza, bo oszczędza obroty pętli.
Jest przy tym granica: komunikat idzie do kontekstu, więc nie powinien zawierać kluczy, wewnętrznych ścieżek, nazw hostów ani identyfikatorów, których model nie ma prawa zobaczyć. Pisz dla modelu, nie zrzucaj logu.
Budżet ponowień
Ponowienia mnożą koszt w sposób, którego nie widać w statystykach obrotów pętli — bo dla pętli to wciąż jeden krok.
Dwie zasady, które to porządkują. Limit ponowień liczony na cały przebieg, nie na pojedyncze wywołanie: trzy ponowienia na wywołanie razy dziesięć wywołań to trzydzieści dodatkowych prób. I logowanie każdej próby, nie tylko wyniku końcowego.
To drugie ma znaczenie, bo większość frameworków ponawia po cichu. Nieudane wywołania modelu bywają rozliczane, a w logu aplikacji nie zostawiają śladu — przy diagnozowaniu nieoczekiwanego rachunku warto zacząć właśnie tutaj.
Kiedy przestać próbować
Jeśli narzędzie zawodzi konsekwentnie, sensowne jest odcięcie go na jakiś czas zamiast wywoływania przy każdym kroku. Klasyczny bezpiecznik: po serii niepowodzeń narzędzie zostaje uznane za niedostępne, a pętla po prostu przestaje je oferować.
Wtedy zapada decyzja projektowa, którą trzeba podjąć świadomie: czy agent ma kontynuować bez tego narzędzia, czy przerwać zadanie. Przy narzędziu pomocniczym kontynuacja jest w porządku. Przy narzędziu, od którego zależy poprawność odpowiedzi, kontynuacja oznacza, że agent odpowie zgadując — a użytkownik nie zobaczy różnicy.
Domyślną odpowiedzią powinno być przerwanie z jawną informacją, że część danych była niedostępna.
Jak to sprawdzić u siebie
Narzędzie z symulowanymi awariami, pętla klasyfikująca błędy i porównanie dwóch sposobów mówienia o nich modelowi.
import json, random, time
from openai import OpenAI

client = OpenAI()
PROBY = {"n": 0}

class Przejsciowy(Exception): pass
class Trwaly(Exception): pass

def status_zamowienia(numer_zamowienia):
    PROBY["n"] += 1
    if numer_zamowienia == "ZAM-9999":
        raise Trwaly(f"Zamówienie {numer_zamowienia} nie istnieje")
    if PROBY["n"] < 3:                      # dwa razy padnie, potem zadziała
        raise Przejsciowy("Przekroczono czas oczekiwania")
    return {"numer": numer_zamowienia, "status": "w drodze"}

def wywolaj_z_ponowieniem(numer, max_prob=4, surowy=False):
    for proba in range(max_prob):
        try:
            return json.dumps(status_zamowienia(numer), ensure_ascii=False)
        except Trwaly as e:
            if surowy:
                return f"Error: {e}"
            return (f"BŁĄD TRWAŁY: {e}. Nie ponawiaj. "
                    f"Sprawdź numer lub użyj szukaj_zamowien.")
        except Przejsciowy as e:
            czekaj = (2 ** proba) * 0.2 + random.uniform(0, 0.1)   # backoff + rozrzut
            print(f"  próba {proba+1}: {e} — czekam {czekaj:.2f}s")
            time.sleep(czekaj)
    if surowy:
        return "Error: timeout"
    return ("BŁĄD PRZEJŚCIOWY: system zamówień niedostępny po 4 próbach. "
            "Zakończ i poinformuj użytkownika o chwilowej niedostępności.")

print("--- przejściowy, ponowienia działają ---")
print(wywolaj_z_ponowieniem("ZAM-4471"))

PROBY["n"] = 99
print("\n--- trwały, komunikat surowy ---")
print(wywolaj_z_ponowieniem("ZAM-9999", surowy=True))
print("\n--- trwały, komunikat dla modelu ---")
print(wywolaj_z_ponowieniem("ZAM-9999"))
Zwróć uwagę na trzy rzeczy. Błąd trwały nie jest ponawiany ani razu — klasyfikacja dzieje się przed decyzją o powtórzeniu. Odstęp rośnie i ma losowy rozrzut. A komunikat w wersji dla modelu mówi wprost, czego nie robić i co zrobić zamiast.
Ćwiczenie: podłącz oba warianty komunikatu do pętli z pierwszego artykułu i porównaj liczbę obrotów przy pytaniu o ZAM-9999. Wersja surowa zwykle prowokuje kolejne próby — model nie wie, że to bez sensu. Wersja z jawnym „nie ponawiaj” kończy zadanie w jednym kroku.
Drugie ćwiczenie, bardziej niepokojące: zmień status_zamowienia na narzędzie ze skutkiem ubocznym — niech przy każdym wywołaniu dopisuje linię do pliku, a dopiero potem rzuca wyjątek przejściowy. Uruchom z ponowieniami i policz linie. To jest dokładnie ten scenariusz, w którym klient dostaje trzy identyczne maile.
Co dalej
Agent, który przetrwa awarie, natrafia na kolejny problem: co ma pamiętać między krokami i między przebiegami. Bo nie wszystko musi jechać do modelu — a część rzeczy w ogóle nie powinna.
O tym jest artykuł siódmy: Stan poza kontekstem.