W pierwszym artykule padło zdanie, że agent nie kontynuuje pracy — zaczyna od zera z coraz dłuższą notatką. Notatką jest kontekst, a jego rosnąca długość to główny składnik rachunku.
Pytanie, które z tego wynika, brzmi: co właściwie musi być w tej notatce, a co powinno leżeć gdzie indziej.
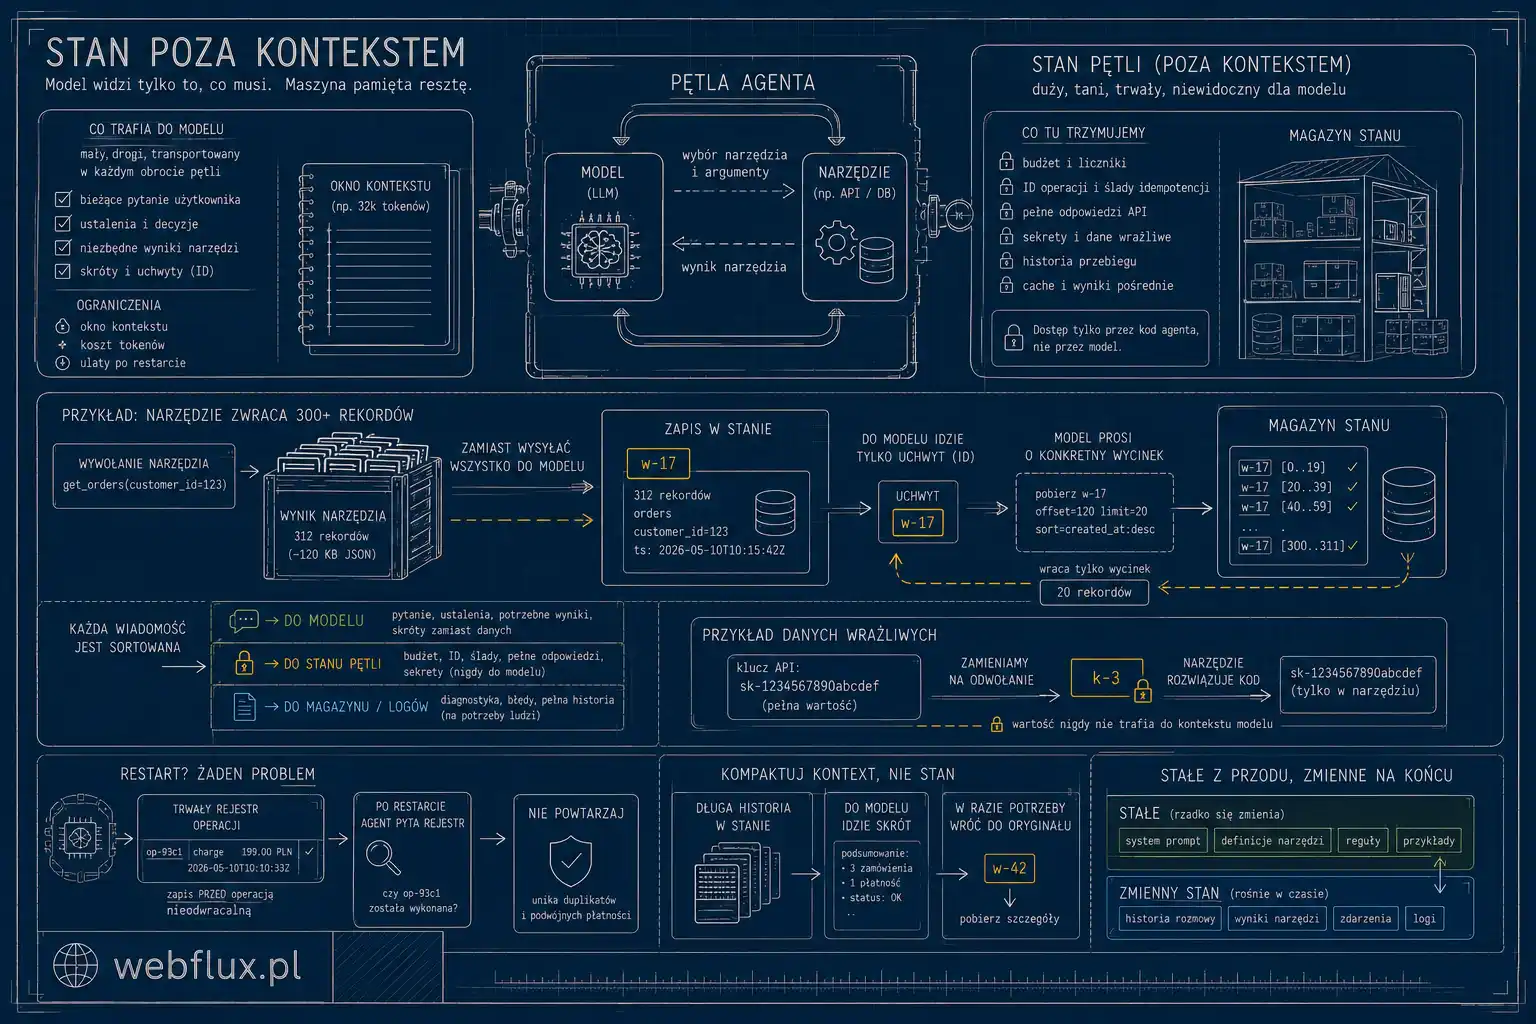
Stan pętli to nie kontekst modelu
To rozróżnienie porządkuje cały temat i bywa mylone.
Kontekst modelu to sekwencja wysyłana przy każdym obrocie. Jest droga, ograniczona i widoczna dla modelu.
Stan pętli to wszystko, co trzyma twój kod: liczniki, budżet, identyfikatory wykonanych operacji, klucze, oryginalne odpowiedzi API. Nie kosztuje nic i nie jest widoczne dla modelu.
Te dwa zbiory pokrywają się tylko częściowo — a domyślne wrzucanie wszystkiego do kontekstu jest najczęstszym źródłem niepotrzebnych kosztów.
Trzy kategorie
Musi być w kontekście. To, czego model potrzebuje do podjęcia następnej decyzji: pytanie użytkownika, dotychczasowe ustalenia, wyniki narzędzi w zakresie, który ma znaczenie dla dalszych kroków.
Musi być w pętli, ale nie w kontekście. Identyfikatory już wykonanych operacji, zużyty budżet i liczba kroków, klucze i poświadczenia, pełne odpowiedzi API, dane wrażliwe. Model nie potrzebuje ich do decydowania, a część z nich nie powinna go w ogóle dotknąć.
Nie musi być nigdzie w bieżącym przebiegu. Logi, ślady diagnostyczne, historia poprzednich zadań. To idzie do magazynu na potrzeby obserwowalności, nie do pamięci agenta.
Uchwyt zamiast danych
Tu jest wzorzec, który daje największą oszczędność i skaluje się najlepiej.
Domyślne zachowanie wygląda tak: narzędzie zwraca trzysta rekordów, pętla wkleja je do kontekstu, a od tego momentu trzysta rekordów jedzie do modelu przy każdym kolejnym obrocie. Jednorazowo duży wynik podnosi koszt wszystkich następnych kroków — to ta sama obserwacja, którą aneks z pierwszego artykułu pokazywał na liczbach.
Alternatywa: pętla zapisuje wynik u siebie, a do kontekstu wkłada opis wyniku i uchwyt.
Zamiast trzystu rekordów — „zapisano jako w-17: 312 zamówień klienta KL-0012 z lat 2024–2026, pola: numer, data, kwota, status. Użyj pobierz_wycinek, żeby zobaczyć fragment.”
Model dostaje wtedy to, czego naprawdę potrzebuje do decyzji: wie, co znalazł, ile tego jest i jak sięgnąć po szczegół. Jeśli potrzebuje pięciu rekordów, poprosi o pięć. Reszta leży w pętli i nie kosztuje ani grosza.
To jest zresztą dokładnie ta sama logika co przy retrieval just-in-time z serii o context engineeringu — z tą różnicą, że tutaj dotyczy wyników narzędzi, a nie bazy wiedzy.
Dane wrażliwe nie idą do kontekstu
Osobna kategoria, rozstrzygana nie kosztem, tylko ryzykiem.
Numer karty, PESEL, pełny adres, klucz API, treść dokumentu objętego poufnością — to wszystko, raz wysłane do modelu, opuściło twoją infrastrukturę. Przy dostawcy zewnętrznym oznacza to przekazanie danych stronie trzeciej, ze wszystkimi konsekwencjami prawnymi.
Wzorzec obejścia jest prosty: pętla podstawia. Model operuje na zastępniku — „karta klienta zapisana jako k-3” — a rzeczywista wartość jest podstawiana dopiero w momencie wywołania narzędzia, po stronie kodu. Model nigdy jej nie widzi, a i tak może poprowadzić zadanie do końca.
Ta sama zasada dotyczy komunikatów błędów, o czym była mowa w poprzednim artykule: ślad wyjątku potrafi zawierać ścieżki, nazwy hostów i fragmenty poświadczeń.
Co przeżywa restart
Przy agencie wyzwalanym stan przebiegu ginie razem z przebiegiem i nikomu to nie przeszkadza.
Przy agencie długo żyjącym trwałe musi być minimum: co już zostało zrobione i na czym skończył. Pierwsze jest warunkiem idempotencji — bez trwałego rejestru wykonanych operacji restart oznacza powtórzenie ich wszystkich razem ze skutkami.
Warto przy tym zapisywać ślad przed wykonaniem operacji nieodwracalnej, nie po. Kolejność ma tu znaczenie większe niż cokolwiek innego w całym mechanizmie.
Kompakcja i jej pułapka
Kiedy historia rośnie ponad rozsądny rozmiar, standardowym zabiegiem jest zastąpienie starszych kroków podsumowaniem.
Jest w tym pułapka, którą łatwo przeoczyć: podsumowanie robi model. Podlega więc wszystkiemu, co wiemy o modelach — może pominąć szczegół, który okaże się istotny za trzy kroki, i może dodać coś, czego nie było.
Dlatego kompaktowanie warto traktować jako operację na kontekście, nie na stanie. Oryginalna historia zostaje w pętli, do kontekstu idzie skrót. Jeśli model potrzebuje szczegółu, może po niego sięgnąć — tak samo jak po wycinek wyniku narzędzia. Więcej o samej technice jest w artykule o kompaktowaniu kontekstu.
Gdzie wstawiać stan w prompcie
Rzecz drobna, a kosztowna. Cache promptu działa od początku sekwencji do pierwszej różnicy — wszystko po niej jest liczone od nowa.
Jeśli więc wstawisz zmienny stan w środek promptu systemowego, unieważnisz cache dla całej reszty. Reguła, która to porządkuje, jest ta sama co w haśle o KV cache: stałe na początku, zmienne na końcu. Prompt systemowy i definicje narzędzi jako niezmienny prefiks, stan i historia dopisywane wyłącznie na końcu.
Jak to sprawdzić u siebie
Kod porównuje dwa sposoby zwracania obszernego wyniku: pełne dane w kontekście kontra uchwyt z opisem.
import json
from openai import OpenAI

client = OpenAI()
MAGAZYN = {}                       # stan pętli — model tego nie widzi

def duzy_wynik(n=300):
    return [{"numer": f"ZAM-{i:04d}", "kwota": 100 + i, "status": "zrealizowane"}
            for i in range(n)]

def jako_dane(wynik):
    return json.dumps(wynik, ensure_ascii=False)

def jako_uchwyt(wynik, klucz="w-17"):
    MAGAZYN[klucz] = wynik
    return json.dumps({
        "uchwyt": klucz,
        "liczba_pozycji": len(wynik),
        "pola": list(wynik[0].keys()),
        "podglad": wynik[:2],
        "wskazowka": "Użyj pobierz_wycinek(uchwyt, od, do) po szczegóły.",
    }, ensure_ascii=False)

wynik = duzy_wynik()

for etykieta, tresc in [("pełne dane", jako_dane(wynik)),
                        ("uchwyt", jako_uchwyt(wynik))]:
    odp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "user", "content": "Podsumuj zamówienia klienta KL-0012."},
            {"role": "assistant", "content": "Pobieram dane."},
            {"role": "user", "content": f"Wynik narzędzia: {tresc}"},
        ],
        max_tokens=80,
    )
    print(f"{etykieta:11} wejście: {odp.usage.prompt_tokens:6} tokenów")
    print(f"            {odp.choices[0].message.content.strip()[:90]}\n")
Różnica w tokenach wejściowych będzie rzędu kilkudziesięciu razy. Ale najważniejsze jest to, czego ten pomiar niepokazuje: przy agencie wykonującym dziesięć kroków ta różnica mnoży się przez wszystkie kolejne obroty, bo pełne dane raz wrzucone do historii jadą do modelu za każdym razem.
Ćwiczenie: dopisz pobierz_wycinek jako prawdziwe narzędzie odczytujące z MAGAZYN i podłącz oba warianty do pętli z pierwszego artykułu. Zadaj pytanie wymagające szczegółu — na przykład o trzy największe kwoty. Wersja z uchwytem wykona jeden dodatkowy obrót i mimo to zwykle wyjdzie taniej.
Drugie ćwiczenie, o innym charakterze: dopisz do rekordów pole z adresem e-mail klienta i sprawdź, jak wygląda kontekst w obu wersjach. W wariancie z uchwytem dane osobowe trzystu klientów w ogóle nie opuszczają twojej infrastruktury.
Co dalej
Wiemy już, co pętla trzyma i czego nie wysyła. Zostaje pytanie, co robi z tym, co model proponuje — bo między propozycją a wykonaniem stoi jedyne miejsce w całym systemie, w którym cokolwiek da się zatrzymać.
O tym jest artykuł ósmy: Pętla jako miejsce kontroli.