Objawy
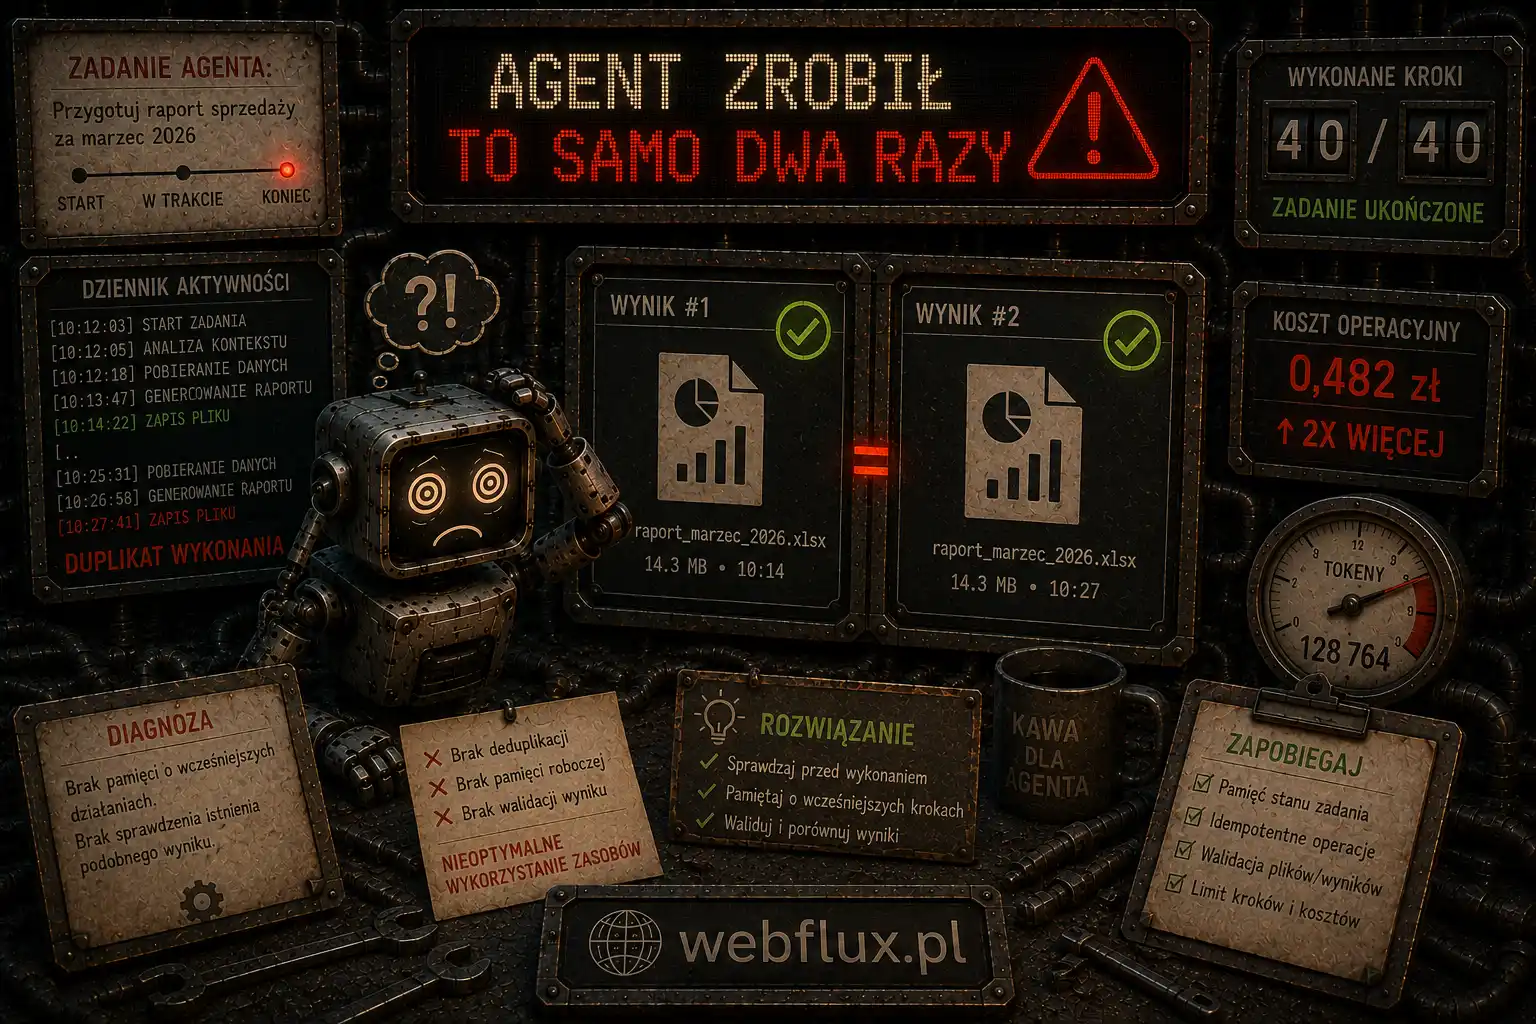
Ten syndrom różni się od pozostałych jedną rzeczą: objaw widzi klient, nie ty.
Trzy identyczne wiadomości w skrzynce. Dwa zamówienia zamiast jednego. Podwójne obciążenie. Duplikaty rekordów, które ktoś zauważa tydzień później.
W twoim dzienniku wszystko wygląda poprawnie — jedno wywołanie, jeden wynik. Bywa nawet gorzej: log mówi, że operacja się nie udała, a w systemie docelowym jest wykonana.
Ten rozjazd między tym, co widzisz, a tym, co się wydarzyło, jest głównym sygnałem rozpoznawczym.
Mechanizm w trzech zdaniach
W pętli agenta powtórzenie jest regułą, nie wyjątkiem: ponowienia po błędach, zapętlenie modelu, restart procesu, równoległe wywołania, ponowne uruchomienie zadania. W klasycznej aplikacji ścieżki wykonania są przewidywalne — tutaj nie są.
Operacja, która nie jest odporna na powtórzenie, prędzej czy później zostanie powtórzona. Pojęcie porządkujące to idempotencja, a warstwę wykonawczą opisuje artykuł o awariach narzędzi.
Najpierw ustal, gdzie powstaje duplikat
Trzy miejsca, każde z inną naprawą.
Na wejściu — to samo zadanie trafiło do agenta dwa razy. W pętli — agent wywołał narzędzie więcej niż raz. W transporcie — wywołanie było jedno, dotarło dwa razy albo dotarło mimo zgłoszonego błędu.
Rozstrzyga to porównanie trzech liczb za ten sam okres: ile zadań weszło, ile wywołań narzędzia jest w twoim logu, ile operacji ma system docelowy.
Diagnostyka różnicowa
1. Ponowienie po przekroczeniu czasu po stronie klienta
Jak rozpoznać: log mówi „timeout”, system docelowy ma rekord. Liczba operacji w systemie docelowym jest wyższa niż liczba udanych wywołań w twoim logu.
Dlaczego to najgroźniejsze: operacja się wykonała, tylko odpowiedź nie wróciła. Z perspektywy pętli to nieudane wywołanie, więc ponawia. Nie ma sposobu, żeby odróżnić „nie zadziałało” od „zadziałało, ale nie wiem” bez pytania systemu docelowego.
Test: dla kilku spraw z timeoutem sprawdź ręcznie, czy operacja istnieje po drugiej stronie.
2. Ciche ponowienie na poziomie biblioteki
Jak rozpoznać: liczba wywołań w twoim kodzie i w logu dostawcy się różni, a ty nigdzie nie napisałeś pętli ponowień.
Dlaczego się dzieje: SDK, klient HTTP albo framework agentowy ponawiają domyślnie. Zwykle rozsądnie — dopóki operacja nie ma skutków ubocznych.
Test: wypisz faktyczną konfigurację ponowień w używanych bibliotekach, zamiast zakładać, że jest wyłączona.
3. Zapętlenie modelu
Jak rozpoznać: w kontekście widać kilka wywołań tego samego narzędzia z tymi samymi argumentami — świadomych, nie technicznych.
Dlaczego się dzieje: to pierwszy syndrom z konsekwencjami w świecie. Jeśli narzędzie ma skutki uboczne, każde powtórzenie jest osobną operacją.
Test: policz wystąpienia narzędzia w śladzie pojedynczego przebiegu.
4. Restart bez trwałego rejestru
Jak rozpoznać: duplikaty pojawiają się seriami, skorelowanymi z wdrożeniami albo restartami procesu. Dotyczy agentów działających w tle.
Dlaczego się dzieje: agent długo żyjący po restarcie zaczyna od zera. Wszystko, czego nie zapisał trwale, jest dla niego niewykonane.
Test: sprawdź, czy rejestr wykonanych operacji przeżywa restart i czy zapis następuje przed operacją, nie po.
5. Równoległe wywołania z jednej odpowiedzi
Jak rozpoznać: duplikaty mają identyczny znacznik czasu co do sekundy.
Dlaczego się dzieje: model poprosił o kilka wywołań naraz, wśród nich dwa takie same albo różniące się nieistotnie. Pętla wykonała je współbieżnie.
Test: sprawdź, czy zrównoleglasz wywołania i czy obejmuje to narzędzia zapisujące.
6. Brak deduplikacji na wejściu
Jak rozpoznać: liczba zadań, które weszły, jest wyższa niż liczba zgłoszeń od użytkowników.
Dlaczego się dzieje: użytkownik kliknął dwa razy, kolejka dostarczyła wiadomość ponownie, webhook przyszedł podwójnie. Agent zadziałał poprawnie — dwa razy, bo dwa razy go poproszono.
Test: porównaj liczby na wejściu z liczbą realnych zgłoszeń.
7. Wiele instancji tego samego agenta
Jak rozpoznać: duplikaty pojawiły się po skalowaniu poziomym albo po dodaniu drugiego środowiska.
Dlaczego się dzieje: dwie instancje pobrały to samo zadanie z kolejki, bo nie ma blokady ani znacznika przetwarzania.
Test: sprawdź, czy zadanie jest oznaczane jako podjęte, zanim zacznie być wykonywane.
Postępowanie
Natychmiast: wyłącz automatyczne ponawianie dla operacji ze skutkami ubocznymi. Lepiej zgłosić błąd i poprosić o decyzję, niż wykonać coś drugi raz. To zatrzymuje krwawienie w kilkanaście minut.
Potem: klucz idempotencji. Wywołanie niesie identyfikator, po którym system docelowy rozpoznaje powtórzenie i zwraca wynik pierwszego wykonania zamiast wykonywać ponownie. Standard w API płatniczych i najlepsze dostępne rozwiązanie przyczyn pierwszej, drugiej, trzeciej i piątej naraz. Jako klucza użyj identyfikatora przebiegu połączonego z numerem kroku — masz go już w śladzie przebiegu.
Gdy systemu docelowego nie da się zmienić: sprawdzenie stanu przed działaniem. Zanim wyślesz, zapytaj, czy taka operacja już istnieje. Słabsze niż klucz idempotencji, bo między sprawdzeniem a zapisem jest szczelina, ale zwykle wystarczające.
Dla operacji nieodwracalnych: rozdzielenie przygotowania od zatwierdzenia. Agent tworzy operację w stanie oczekującym, zatwierdza ją osobny krok — najlepiej z udziałem człowieka.
Zapisuj ślad przed operacją, nie po. Ta kolejność ma większe znaczenie niż cokolwiek innego w tym mechanizmie: rejestr zapisany po wykonaniu nie chroni przed niczym, bo awaria zdarza się dokładnie pomiędzy.
Profilaktyka
Reguła, od której warto zacząć projektowanie narzędzi: każde narzędzie ze skutkiem ubocznym jest albo idempotentne, albo objęte potwierdzeniem przed wykonaniem. Trzeciej możliwości nie ma.
Oznaczaj narzędzia jawnie w kodzie, żeby pętla mogła automatycznie decydować o ponawianiu i zrównoleglaniu. Nie zrównoleglaj operacji zapisujących. Deduplikuj na wejściu.
Jak zdiagnozować u siebie
Symulacja przyczyny pierwszej — operacja wykonana, odpowiedź zgubiona — i porównanie zachowania bez klucza idempotencji i z nim.
import uuid

SYSTEM_DOCELOWY = []          # "baza" po drugiej stronie
WIDZIANE_KLUCZE = {}

class Timeout(Exception): pass

def wyslij_mail(adres, tresc, klucz=None, gubie_odpowiedz=False):
    """Narzędzie po drugiej stronie sieci."""
    if klucz and klucz in WIDZIANE_KLUCZE:
        return WIDZIANE_KLUCZE[klucz]          # rozpoznane powtórzenie

    SYSTEM_DOCELOWY.append({"adres": adres, "tresc": tresc})
    wynik = {"status": "wyslano", "id": len(SYSTEM_DOCELOWY)}
    if klucz:
        WIDZIANE_KLUCZE[klucz] = wynik

    if gubie_odpowiedz:                        # wykonane, ale nie wróciło
        raise Timeout("brak odpowiedzi")
    return wynik

def z_ponowieniami(klucz=None, prob=3):
    for i in range(prob):
        try:
            return wyslij_mail("klient@firma.pl", "Potwierdzenie",
                               klucz=klucz, gubie_odpowiedz=(i < 2))
        except Timeout:
            print(f"  próba {i+1}: timeout — ponawiam")
    return None

print("BEZ klucza idempotencji:")
SYSTEM_DOCELOWY.clear(); WIDZIANE_KLUCZE.clear()
z_ponowieniami()
print(f"  maili w systemie docelowym: {len(SYSTEM_DOCELOWY)}\n")

print("Z kluczem idempotencji:")
SYSTEM_DOCELOWY.clear(); WIDZIANE_KLUCZE.clear()
klucz = f"{uuid.uuid4().hex[:8]}-krok3"
z_ponowieniami(klucz=klucz)
print(f"  maili w systemie docelowym: {len(SYSTEM_DOCELOWY)}")
Pierwszy przebieg wysyła trzy maile, mimo że pętla widzi wyłącznie nieudane próby. Drugi wysyła jednego — bo system docelowy rozpoznaje powtórzenie po kluczu, choć z perspektywy pętli sytuacja jest identyczna.
To jest cała różnica między agentem, który po awarii sieci zawiadamia klienta raz, a takim, który robi to trzy razy. Kod pętli w obu przypadkach ten sam.
Ćwiczenie: policz w swoim systemie trzy liczby za ostatni miesiąc — zadania na wejściu, wywołania narzędzi ze skutkami ubocznymi w logu, operacje w systemie docelowym. Jeśli trzecia jest wyższa od drugiej, masz przyczynę pierwszą albo drugą i wiesz, gdzie szukać.
Powiązane
Klasyfikacja awarii, ponowienia i skutki uboczne: Maszyneria agenta.
Następny syndrom: Agent zrobił coś, o co nikt nie prosił.