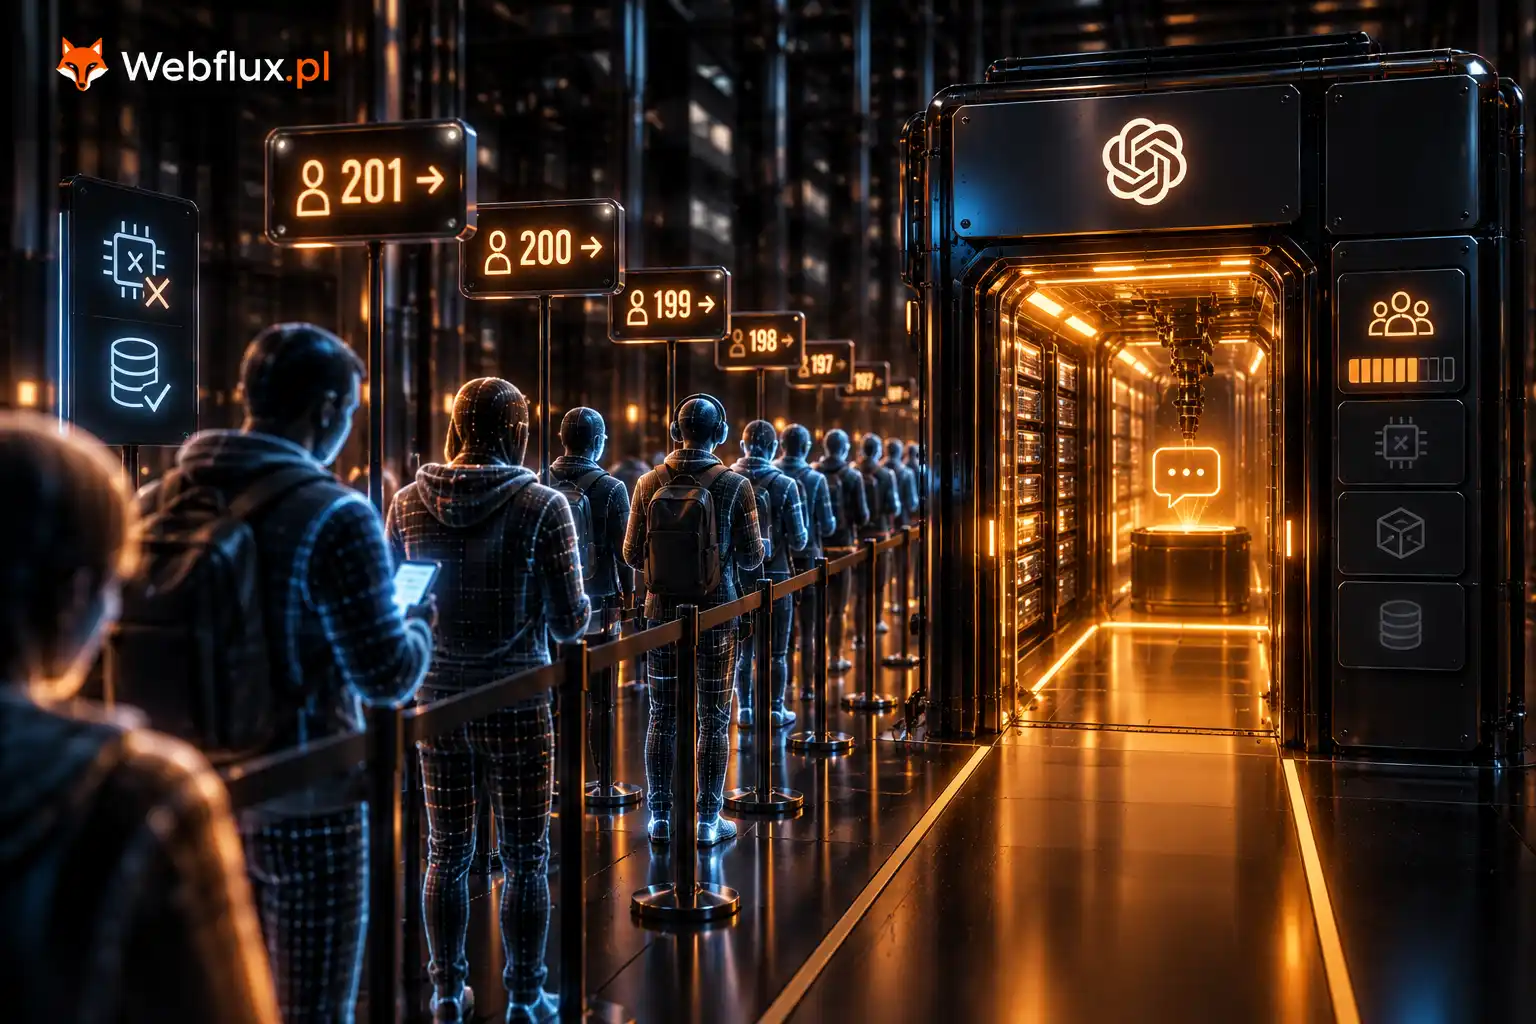
Cennik API wygląda jak cennik produktu, a jest cennikiem czasu na karcie. Dwie kolumny, wejście i wyjście, różnica trzy- do pięciokrotnej — i żadna z tych liczb nie mówi o modelu. Mówią o tym, ile miejsca zajmujesz w partii i jak długo je blokujesz.
To zamknięcie toru drugiego, więc nie będzie tu stawek. Ceny zmieniają się co kwartał, a to, co za chwilę opiszę, nie zmieniło się od czasu, gdy istnieje ten sposób serwowania modeli.
Trzy liczby, które opisują ofertę
Każdy dostawca podaje ci co najmniej trzy rzeczy. Warto wiedzieć, co która z nich naprawdę oznacza.
Cena tokenu wejściowego. Koszt przetworzenia twojego promptu w prefillu. Niski, bo prefill dzieli jeden odczyt wag na tysiąc tokenów i obciąża kartę efektywnie.
Cena tokenu wyjściowego. Koszt wygenerowania jednego słowa odpowiedzi. Kilkukrotnie wyższy, bo każdy taki token wymaga osobnego przejścia przez cały model przy wykorzystaniu karty na poziomie kilku procent.
Limit tokenów na minutę. Nie limit żądań — limit pamięci, jaką wolno ci zająć. Liczy się do niego cały kontekst wysyłany przy każdym wywołaniu, nie tylko nowa treść.
Te trzy liczby to nie są trzy niezależne decyzje handlowe. To są trzy odczyty tego samego mechanizmu: prefill jest tani, decode jest drogi, a pamięć jest skończona.
Dlaczego dwie kolumny, a nie jedna
Zatrzymajmy się przy różnicy między wejściem a wyjściem, bo to najczęściej źle czytana rzecz w całym cenniku.
Powszechne wytłumaczenie brzmi: generowanie jest trudniejsze niż czytanie. To nieprawda. Matematyka jest identyczna — te same wagi, ten sam graf, to samo mnożenie macierzy. Różni je wyłącznie to, ile pracy przypada na jeden odczyt modelu z pamięci.
W prefillu tysiąc tokenów dzieli jeden odczyt. W decode każdy pojedynczy token wymaga własnego. Karta spędza na twoim tokenie wyjściowym kilkadziesiąt razy więcej czasu niż na wejściowym.
Ciekawe jest to, że cennik tej przepaści nie odzwierciedla w pełni. Różnica w cenie to trzy do pięciu razy, różnica w koszcie karty jest znacznie większa. Brakującą część odrabia batching — dostawca upycha w kartę tyle równoległych rozmów, że koszt jednego tokenu wyjściowego spada kilkudziesięciokrotnie.
Innymi słowy: tę zniżkę fundują ci inni użytkownicy dzielący z tobą kartę. I ty fundujesz ją im.
Co naprawdę kupujesz
Skoro nie model, to co?
Kupujesz czas na karcie, wyceniony w dwóch stawkach, i miejsce w pamięci, rozliczane limitem. Nic więcej. Dostawca nie sprzedaje ci inteligencji, tylko dostęp do maszyny na chwilę, razem z dwustoma innymi osobami.
Z tej perspektywy sensowne stają się rzeczy, które inaczej wyglądają na kaprys.
Długie konteksty bywają wyceniane osobno albo wyżej, bo zajmują pamięć, której nie da się oddać nikomu innemu, przez cały czas trwania sesji.
Tryb wsadowy bywa wyraźnie tańszy, bo pozwala dostawcy wcisnąć twoje zadanie w dziurę w obciążeniu zamiast trzymać dla ciebie miejsce od razu. Płacisz mniej za rezygnację z pilności.
Modele rozumujące są drogie nie dlatego, że są mądrzejsze, tylko dlatego, że generują ogromną liczbę tokenów wyjściowych, zanim dojdą do odpowiedzi — a token wyjściowy to najdroższa rzecz w całym cenniku.
Dwie różne rzeczy nazywane szybkością
Kiedy ktoś pyta, który dostawca jest szybszy, pytanie nie ma odpowiedzi bez dopowiedzenia, co się robi.
Czas do pierwszego tokena zależy głównie od tego, jak długo czekasz na miejsce w partii i jak długi masz prompt. Poprawia go mniejsza partia i krótszy kontekst.
Tokeny na sekundę zależą od rozmiaru modelu, przepustowości pamięci i tego, czy partia przekroczyła próg, za którym wąskim gardłem stają się rdzenie.
Te dwie metryki bywają ze sobą w konflikcie, a dostawcy ustawiają ten suwak w różnych miejscach. To jest jeden z niewielu realnych powodów, dla których ta sama nazwa modelu u dwóch dostawców to dwa różne produkty — obok precyzji wag, runtime’u i sprzętu.
Stąd też bierze się coś, co wygląda na sprzeczność w recenzjach: ten sam dostawca bywa najszybszy w jednym teście i najwolniejszy w drugim. Testy mierzyły co innego, na zadaniach o innym profilu.
Jak czytać cennik w pięciu krokach
Praktyczna część, bo cała reszta prowadziła do tego.
Policz swój profil, nie średni. Ile tokenów wchodzi, ile wychodzi, na jedno typowe zadanie. Stosunek wejścia do wyjścia decyduje o tym, która kolumna cennika dotyczy ciebie. Agent z długim promptem systemowym i krótkimi decyzjami żyje w kolumnie wejściowej. Generator raportów żyje w wyjściowej.
Sprawdź, czy cache trafia. Zanim porównasz dostawców, upewnij się, że nie przepłacasz u obecnego z powodu jednej źle umieszczonej linijki. Odpowiedź API podaje liczbę tokenów odczytanych z pamięci podręcznej osobno.
Policz kroki pętli, nie zapytania. Agent wykonujący dwadzieścia kroków wysyła kontekst dwadzieścia razy. Koszt rośnie z liczbą kroków, nie z długością pytania użytkownika.
Sprawdź, czy twoje zadanie znosi opóźnienie. Jeśli nikt nie patrzy na ekran, tryb wsadowy wymaga zmiany kilku linii i obniża rachunek o połowę. To najtańsza dostępna optymalizacja i najczęściej pomijana.
Zmierz obie metryki na własnym ruchu. Cudzy benchmark mierzył cudzy profil zadania.
Czego ten tor nie obejmował
Uczciwie: w tym torze nie było nic o jakości. Ani jednego zdania o tym, który model lepiej odpowiada.
To nie przeoczenie. Rozróżnienie, które próbowałem tu utrzymać, brzmi: jakość jest własnością modelu, koszt i opóźnienie są własnościami maszynerii. Te dwie rzeczy mieszają się w dyskusjach nieustannie i przez to obie są źle rozumiane.
Dostawca nie może sprawić, że model będzie mądrzejszy. Może sprawić, że będzie tańszy, szybszy albo bardziej przewidywalny — i na tym polega jego praca.
Co dalej
Zostały dwie warstwy do rozłożenia i są to dwie warstwy, których nie widać z żadnej strony.
Kiedy piszesz do okna czatu, nie rozmawiasz z API. Między tobą a modelem stoi jeszcze produkt: instrukcja systemowa, której nie widzisz, historia przepisywana od zera przy każdej turze, wyszukiwarka, pamięć, narzędzia, filtry.
Tor trzeci jest krótki i celowo wąski. Nie o tym, jak zbudować własną pętlę — o tym, co w gotowym produkcie nie jest modelem.