Pamięć jako sufit — dlaczego kontekst kończy się szybciej niż cierpliwość
Wagi to nie wszystko, co model trzyma w pamięci. Obok nich rośnie druga struktura, która przy pierwszym tokenie zajmuje tyle co nic, a przy długiej rozmowie potrafi przekroczyć rozmiar samego modelu. I to ona, nie wagi, najczęściej decyduje o tym, gdzie kończy się...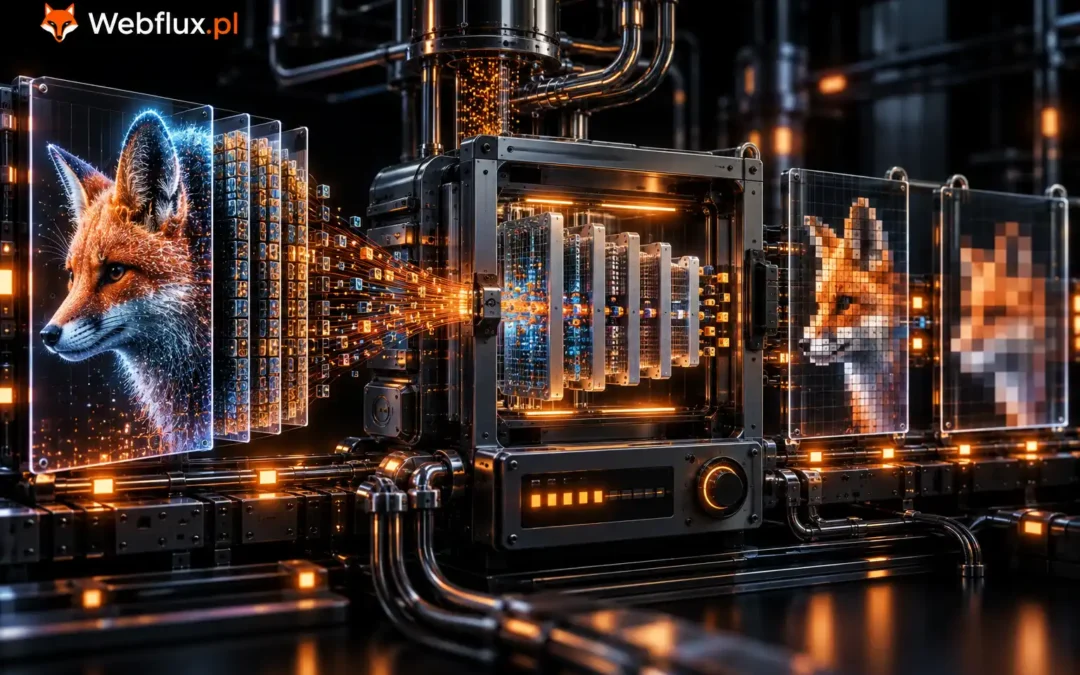
Kwantyzacja, którą widać — co tracisz schodząc do czterech bitów
Model w czterech bitach nie jest „trochę gorszy”. Jest dokładnie tak samo dobry w dziewięciu sytuacjach na dziesięć i wyraźnie gorszy w tej dziesiątej. Cała trudność polega na tym, że to nie jest przypadkowa dziesiąta. Da się z góry powiedzieć, gdzie strata się...
Od wag do odpowiedzi — co runtime robi z plikiem modelu
Model nie jest uruchamiany. Model jest kompilowany. Między wczytaniem pliku a pierwszym tokenem dzieje się praca, o której nie mówi ani nazwa modelu, ani jego rozmiar — a która potrafi zmienić prędkość dwudziestokrotnie. To dlatego ten sam model u dwóch różnych...