Model w czterech bitach nie jest „trochę gorszy”. Jest dokładnie tak samo dobry w dziewięciu sytuacjach na dziesięć i wyraźnie gorszy w tej dziesiątej. Cała trudność polega na tym, że to nie jest przypadkowa dziesiąta. Da się z góry powiedzieć, gdzie strata się pojawi, i jeśli akurat tam masz swoje zastosowanie, żadna średnia z benchmarku cię nie uratuje.
Przez dwa poprzednie artykuły traktowałem kwantyzację jak darmowy obiad. Mniej bajtów, mniej czytania z pamięci, więcej tokenów na sekundę. Wszystko to jest prawdą i nic z tego nie cofam. Teraz płacimy rachunek.
Zaokrąglanie, czyli o co w ogóle chodzi
Waga w modelu to liczba rzeczywista. Coś w rodzaju 0,0347291. Miliardy takich liczb, każda zapisana z pewną precyzją.
Zapis szesnastobitowy daje jakieś sześćdziesiąt pięć tysięcy możliwych wartości na parametr. Zapis czterobitowy daje szesnaście. Nie szesnaście tysięcy. Szesnaście.
Brzmi jak katastrofa i pierwsza reakcja każdego, kto to słyszy, jest taka sama: to nie ma prawa działać. A jednak działa i warto zrozumieć dlaczego, bo z tego samego mechanizmu wynika, gdzie przestaje działać.
Wyobraź sobie, że masz zapisać ceny wszystkich produktów w sklepie, ale wolno ci użyć tylko szesnastu etykiet cenowych. Katastrofa? Zależy od sklepu. Jeśli sprzedajesz warzywa i wszystko kosztuje między dwa a dwanaście złotych, szesnaście etykiet co sześćdziesiąt groszy wystarczy w zupełności. Klient nie zauważy różnicy. Ale jeśli w tym samym sklepie stoi jedna butelka wina za cztery tysiące, właśnie zepsułeś cały cennik — bo żeby ją zmieścić, musisz rozciągnąć skalę tak, że warzywa wylądują wszystkie na jednej etykiecie.
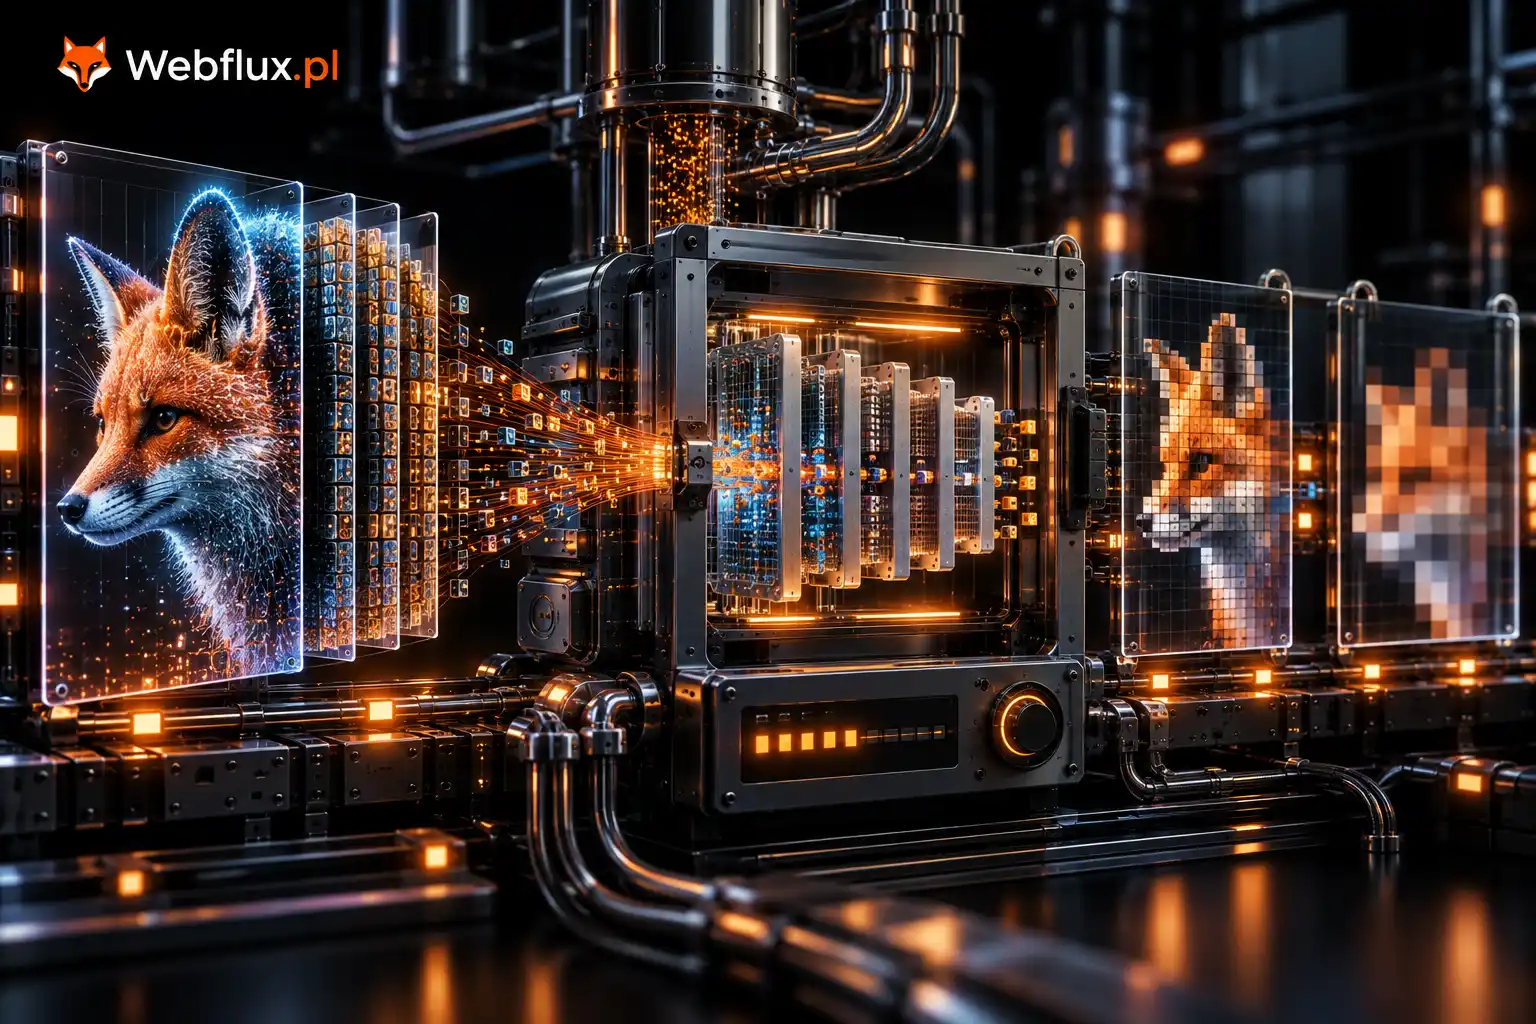
To jest cała kwantyzacja, dosłownie. Bierzesz zakres wartości, dzielisz go na szesnaście poziomów, każdą wagę przypisujesz do najbliższego. I dlatego nie robi się tego na całym modelu naraz.
Dlaczego to w ogóle działa
Wagi w wytrenowanym modelu nie są rozrzucone losowo po całej dostępnej skali. Skupiają się ciasno wokół zera, z cienkimi ogonami po bokach. Rozkład jest przewidywalny i to jest pierwszy prezent od natury.
Drugi prezent to redundancja. Model ma miliardy parametrów, a informacja jest w nim rozsmarowana, nie zapisana punktowo. Pojedyncza waga przesunięta o ułamek nie zmienia niczego, bo ta sama wiedza siedzi jednocześnie w setkach innych miejsc. Przeczytasz o tym przy embeddingach — znaczenie nie ma współrzędnych, ma kierunek. Kierunek da się utrzymać nawet wtedy, gdy każda pojedyncza współrzędna jest nieco przesunięta.
Trzeci prezent jest już zasługą inżynierii, nie natury. Nikt nie kwantyzuje całego modelu jedną skalą. Wagi dzieli się na małe grupy, zwykle po kilkadziesiąt albo sto kilkadziesiąt sąsiadujących liczb, i każda grupa dostaje własną skalę. Wracając do sklepu: nie jeden cennik na całą placówkę, tylko osobny na każdą półkę. Warzywa mają swoje szesnaście etykiet, alkohole swoje. Butelka za cztery tysiące przestaje psuć marchewkę.
Ta jedna decyzja robi różnicę między kwantyzacją, która działa, a kwantyzacją, która zamienia model w generator bełkotu. Kosztuje trochę miejsca, bo każda grupa musi gdzieś zapisać swoją skalę, i dlatego model „czterobitowy” waży w praktyce nieco więcej niż pół bajta na parametr.
Wartości odstające, czyli wino w warzywniaku
Zostaje problem, którego grupowanie nie rozwiązuje do końca.
W niektórych miejscach modelu — dość konsekwentnie w tych samych, niezależnie od architektury — siedzą pojedyncze wartości kilkadziesiąt razy większe od sąsiadów. Nie są błędem treningu. Są nośnikiem czegoś istotnego, model sam je sobie wyhodował i najwyraźniej ich potrzebuje.
Te wartości odstające psują skalę swojej grupy i, co gorsza, gubią się jako pierwsze przy zaokrąglaniu, mimo że akurat one mają największe znaczenie dla wyniku.
Odpowiedzią jest precyzja mieszana. Runtime nie kwantyzuje wszystkiego równo: warstwy wrażliwe zostają w wyższej precyzji, reszta schodzi nisko. Zwykle chroni się tablicę embeddingów, warstwę wyjściową i wybrane fragmenty mechanizmu uwagi. To dlatego oznaczenia wariantów modeli wyglądają jak q4f16, a nie po prostu q4. Ten zapis mówi wprost: większość wag w czterech bitach, część w szesnastu.
Stąd też bierze się wniosek, który warto zapamiętać, bo tłumaczy sporą część chaosu w tym temacie: dwa modele opisane jako „4-bitowe” mogą być zupełnie różnej jakości. Różnią się wielkością grup, doborem chronionych warstw i tym, czy ktoś przed kwantyzacją przepuścił przez model dane kalibracyjne, żeby zobaczyć, które wagi naprawdę pracują. Etykieta „4 bity” mówi mniej więcej tyle, co „samochód benzynowy”.
Gdzie strata wychodzi, a gdzie nie
To jest sedno artykułu, więc wyłożę to wprost: degradacja nie jest równomierna. Nie dostajesz modelu, który jest o pięć procent gorszy we wszystkim. Dostajesz model, który w typowych zadaniach jest nieodróżnialny, a w kilku konkretnych sytuacjach zaczyna się sypać.
Sypie się tam, gdzie odpowiedź zależy od wąskiego marginesu między dwiema możliwościami.
Wiedza rzadka. Popularne fakty są w modelu zapisane grubo, wielokrotnie, wieloma ścieżkami. Fakt wspomniany w danych treningowych trzy razy wisi na cienkim sygnale, który przy zaokrąglaniu może po prostu zniknąć. Model nie powie „nie wiem”. Model nigdy nie mówi „nie wiem” — powie coś prawdopodobnie brzmiącego. Kwantyzacja nie tworzy halucynacji, ale przesuwa granicę, za którą się zaczynają.
Precyzja formalna. Kod, matematyka, poprawna składnia JSON-a, zamknięte nawiasy w długim wyrażeniu. Wszędzie tam „prawie dobrze” znaczy „źle”. Tekst wybacza drobne przesunięcie doboru słowa, parser nie wybacza niczego.
Długi kontekst. Im dłuższa rozmowa, tym więcej kroków, na których mikroskopijne błędy się nawarstwiają. Model w niskiej precyzji częściej gubi wątek pod koniec długiego zadania. Brzmi znajomo, bo ten objaw opisany już został od strony agenta. Warto wiedzieć, że jedną z możliwych przyczyn jest wybór wariantu modelu, a nie pętla ani prompt.
I język. Tu robi się ciekawie dla nas.
Polski płaci drugi raz
Jest na webflux.pl artykuł o tym, dlaczego polski kosztuje więcej w tokenach. Ten sam tekst po polsku rozpada się na więcej kawałków niż po angielsku, więc płacisz więcej za to samo zdanie.
Kwantyzacja dokłada drugą ratę i z zupełnie innego powodu.
Angielski jest w danych treningowych reprezentowany tak obficie, że odpowiadające mu wzorce są w modelu zapisane z ogromnym zapasem. Polski zajmuje ułamek tego wolumenu. Wzorce fleksyjne, rzadsze konstrukcje składniowe, idiomy — wszystko to siedzi na cieńszym sygnale. A cieńszy sygnał jest dokładnie tym, co ginie przy zaokrąglaniu jako pierwsze.
Konsekwencja praktyczna: ten sam model w czterech bitach traci po polsku zauważalnie więcej niż po angielsku. Zwykle nie w sposób spektakularny. Raczej drobnymi zgrzytami w odmianie, sztywniejszą składnią, częstszym zapożyczeniem angielskiej konstrukcji, wyraźniejszym „przetłumaczonym” posmakiem.
Zastrzeżenie, które muszę zrobić uczciwie: to jest obserwacja jakościowa i wynik z mechanizmu, nie liczba z pomiaru na polskim korpusie. Takiego pomiaru po prostu publicznie brakuje i to jest, nawiasem mówiąc, jedna z ciekawszych rzeczy, które ktoś w Polsce mógłby zrobić.
Wniosek dla czytelnika jest za to twardy i niezależny od pomiarów: benchmark kwantyzacji zrobiony po angielsku nie mówi nic o tym, jak ten model poradzi sobie z twoją polską treścią. Musisz to sprawdzić sam. Dlatego pod tym artykułem stoi widget, a nie tabelka.
Dlaczego liczby w benchmarkach nic nie mówią
Standardową miarą degradacji jest perplexity, czyli mierzenie, jak bardzo model jest zaskoczony tekstem, który widzi. Kwantyzacja do czterech bitów podnosi tę wartość zwykle o kilka procent i wszystkie tabelki świata pokazują dokładnie to.
Problem polega na tym, że perplexity to średnia po całym tekście. Uśrednia przypadki, w których model jest obojętny, z tymi nielicznymi, w których podejmuje decyzję. A ty odczuwasz wyłącznie te drugie.
Model, który zawaha się raz na trzysta tokenów, ma świetną perplexity i potrafi codziennie psuć ci jeden na pięć wygenerowanych fragmentów kodu. Średnia jest prawdziwa i bezużyteczna.
Dlatego jedyny sensowny test kwantyzacji to test na twoim zadaniu, twoim tekście i twoim języku. Nie cudza średnia.
Zobacz to sam
Wszystko, co opisałem wyżej, da się zobaczyć na sześćdziesięciu czterech wagach. Tyle wystarczy, bo mechanizm jest ten sam niezależnie od skali — w prawdziwym modelu dzieje się to samo, tylko miliardy razy.
Każde pole w siatce to jedna waga. Im mocniejszy czerwony, tym większy błąd, jaki popełniło zaokrąglenie akurat na niej. Pionowe kreski pokazują granice grup — czyli miejsca, w których zaczyna obowiązywać nowa skala. Najedź na dowolne pole — albo kliknij je na telefonie — a pod siatką pokażą się liczby: waga przed zaokrągleniem, po nim i różnica między nimi.
Kwantyzacja, którą widać webflux · maszyneria modelu
Dwa pola wyróżniają się od razu i to nie przypadek. To wstawione ręcznie wartości odstające — wagi kilkanaście razy większe od sąsiadów, dokładnie takie, jakie model sam sobie wyhodowuje w trakcie treningu. Cała reszta to zwyczajny rozkład wokół zera. Zwróć uwagę, gdzie leży czerwień: nie na nich.
Krok pierwszy: rozciągnij skalę
Przełącz wielkość grupy z trzydziestu dwóch na sześćdziesiąt cztery. Znaczy to tyle, że cała próbka dostaje jedną wspólną skalę.
Błąd skacze. Patrz jednak nie na licznik, tylko na siatkę: czerwień rozlewa się na wagi, które przed chwilą były prawie czyste. Same wartości odstające pozostają stosunkowo jasne, bo one mieszczą się w skali bez problemu — to przecież one ją wyznaczyły.
To jest ten psujący się cennik z poprzedniej sekcji, tylko w liczbach. Jedna butelka wina za cztery tysiące nie cierpi. Cierpi każda marchewka w sklepie, bo skala musiała się do tej butelki rozciągnąć, a szesnaście poziomów trzeba było rozłożyć na całym tym dystansie. Sąsiednie wagi lądują na tym samym poziomie i przestają się od siebie różnić.
Zejdź teraz na osiem. Czerwień się cofa, bo każda ósemka wag negocjuje własną skalę i wartość odstająca psuje już tylko swoje najbliższe otoczenie. Ale spójrz na drugi licznik — koszt zapisu w bitach na parametr właśnie urósł. Każda grupa musi gdzieś zapamiętać swoją skalę, a grup jest teraz osiem razy więcej.
I tu masz odpowiedź na pytanie, dlaczego model opisany jako czterobitowy nigdy nie waży pół bajta na parametr. Nigdy nie chodziło o cztery bity. Chodziło o cztery bity plus podatek od skal.
Krok drugi: zapłać ułamek, odzyskaj większość
Wróć na grupę trzydziestodwuelementową i włącz ochronę wartości odstających.
Dwa pola robią się turkusowe — te wagi zostają zapisane w pełnej precyzji i nie biorą udziału w wyznaczaniu skali dla reszty. Błąd leci w dół. Koszt zapisu praktycznie nie drgnął, bo dwie wagi w pełnej precyzji plus ich indeksy to kilka bajtów na całą próbkę.
To jest precyzja mieszana w najprostszej możliwej postaci i teraz widać, dlaczego wszyscy tak robią. Chronisz ułamek procenta parametrów, płacisz ułamek procenta miejsca, ratujesz większość dokładności. Żadna inna decyzja w kwantyzacji nie ma takiego stosunku zysku do kosztu.
Krok trzeci: zejdź za daleko
Zostaw ochronę włączoną i przełącz precyzję na dwa bity.
Cztery poziomy na grupę. Siatka robi się czerwona praktycznie w całości i tym razem nie pomaga ani zmniejszanie grup, ani ochrona — spróbuj, przekonasz się. Przy czterech dostępnych wartościach nie ma już czego ratować. Informacja nie jest zniekształcona, tylko po prostu jej nie ma.
Dla kontrastu przeskocz na osiem bitów. Dwieście pięćdziesiąt sześć poziomów sprawia, że błąd spada do wartości, przy której rozmowa o degradacji przestaje mieć sens, a plik i tak jest dwa razy mniejszy niż w pełnej precyzji. To jest ta darmowa ósemka, do której wrócę w regule na końcu.
Co z tego wynieść
Przejechałeś właśnie całą przestrzeń decyzji, przed którą staje każdy, kto przygotowuje model do wydania. Trzy pokrętła, jedna zależność: precyzja tnie rozmiar, grupowanie ratuje dokładność, ochrona ratuje ją jeszcze skuteczniej i prawie za darmo — a wszystko razem daje wynik, którego etykieta „4 bity” nie opisuje nawet w połowie.
Dlatego dwa pliki z tym samym oznaczeniem potrafią zachowywać się zupełnie inaczej. Nie dlatego, że ktoś skłamał. Dlatego, że ta nazwa opisuje jedno z trzech pokręteł.
Jedno zastrzeżenie na koniec, żeby było uczciwie: wagi w widgecie są syntetyczne. Rozkład odpowiada temu, co znajdziesz w prawdziwym modelu, wartości odstające wstawiłem ręcznie w znanych miejscach, ale to nie jest fragment wyjęty z konkretnego pliku. Mechanizm jest prawdziwy, próbka jest ilustracją.
Reguła, którą bym przyjął
Osiem bitów jest praktycznie darmowe. W większości zastosowań nie odróżnisz go od pełnej precyzji, a plik masz dwa razy mniejszy. Jeśli wahasz się między szesnastoma a ośmioma, bierz osiem i wróć do pracy.
Cztery bity to realny wybór, który wymaga świadomej decyzji. Świetny do streszczania, klasyfikacji, przepisywania, wyciągania danych ze struktury. Ryzykowny przy kodzie, liczbach, długich zadaniach i tekście w języku innym niż angielski.
Poniżej czterech bitów zaczyna się teren, na którym trzeba mierzyć, a nie ufać. Warianty dwubitowe istnieją i mają sens wyłącznie wtedy, gdy alternatywą jest brak modelu.
Najważniejsze: nie wybieraj precyzji raz dla całego projektu. Streszczanie może chodzić w czterech bitach, generowanie kodu w ośmiu, a klasyfikacja intencji spokojnie w dwóch. To nie jest ustawienie globalne, tylko decyzja per zadanie.
Co dalej
Do tej pory rozmawialiśmy tak, jakby jedyną rzeczą zajmującą pamięć były wagi. Ustawiłeś rozmiar, ustawiłeś precyzję, wyszła liczba w gigabajtach i wydawało się, że temat zamknięty.
Nie jest zamknięty. Obok wag rośnie druga struktura, która przy starcie nie zajmuje prawie nic, a po dwudziestu minutach rozmowy potrafi przewyższyć sam model. Nie da się jej skwantyzować tak łatwo i to ona, a nie wagi, najczęściej decyduje o tym, gdzie kończy się kontekst.
Następny artykuł jest o niej.