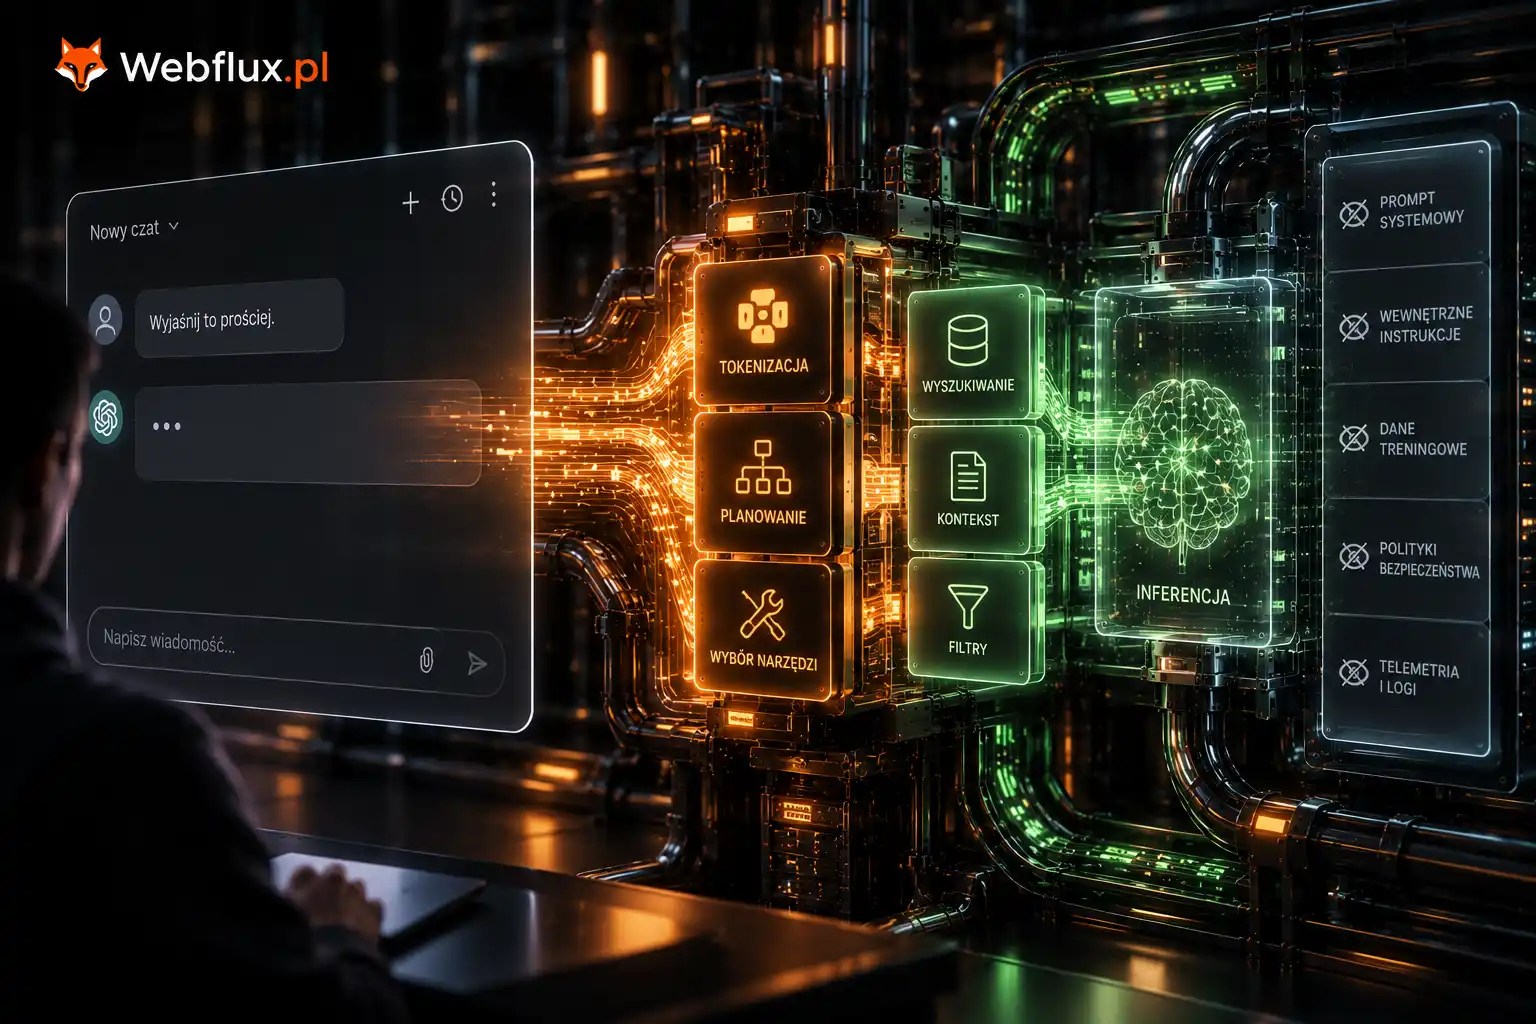
Okno czatu wygląda jak najkrótsza możliwa droga do modelu, a jest najdłuższą. Między twoim zdaniem a wagami stoi więcej warstw niż w wywołaniu API — i żadnej z nich nie widzisz, nie ustawiasz i nie możesz wyłączyć.
W poprzednim torze rozkładaliśmy to, co dzieje się na cudzym serwerze. Tam przynajmniej wiedziałeś, co wysyłasz — kontekst budowałeś sam. Tutaj kontekst buduje za ciebie produkt, a ty widzisz wyłącznie jego ostatni fragment: własne zdanie.
Co produkt dokłada do twojego zdania
Napisałeś sześć słów. Do modelu poszło kilka tysięcy tokenów.
Instrukcja systemowa. Kilkaset do kilku tysięcy tokenów opisujących, kim model ma być, czego nie robić, jak formatować odpowiedzi, co robić w sytuacjach spornych. Napisana przez producenta, aktualizowana bez twojej wiedzy, w większości produktów niepokazywana.
Definicje narzędzi. Opisy wszystkiego, co model może wywołać — wyszukiwarka, wykonywanie kodu, generowanie obrazów, czytanie plików. Każde narzędzie to opis, który zajmuje kontekst niezależnie od tego, czy zostanie użyte.
Historia rozmowy. Cała, od początku, przy każdej turze. O tym osobno w następnym artykule, bo to najczęściej źle rozumiany element.
Wstrzyknięty kontekst. Bieżąca data, czasem lokalizacja, czasem informacje o twoim koncie albo ustawieniach. Rzeczy, o których model „wie”, choć nikt mu ich nie napisał w tej rozmowie.
Materiał z wyszukiwania albo z twoich plików. Jeśli produkt uznał, że są potrzebne. Fragmenty stron, fragmenty dokumentów — wklejone do kontekstu, zwykle bez pokazania ci, które dokładnie.
Twoje sześć słów siedzi na samym końcu tego stosu. Odpowiedź, którą dostajesz, jest funkcją całości, nie tylko twojego zdania.
Co naprawdę idzie do modelu
webflux · maszyneria modelu
Piszesz jedno zdanie. Do modelu idzie cały stos poniżej — w tej kolejności, przy każdej turze rozmowy.
Instrukcja systemowa
Kim model ma być, czego nie robić, jak formatować. Aktualizowana bez ogłoszeń, w większości produktów niepokazywana.
Definicje narzędzi
Opisy wszystkiego, co model może wywołać — wyszukiwarka, kod, pliki, obrazy. Zajmują kontekst niezależnie od tego, czy zostaną użyte.
Wstrzyknięty kontekst
Bieżąca data, czasem lokalizacja, ustawienia konta. Rzeczy, o których model „wie", choć nikt mu ich nie napisał.
Historia rozmowy
Cała, od pierwszego zdania, przepisywana od nowa przy każdej turze. Jedyna warstwa, która rośnie — i po godzinie zwykle największa.
Wyniki wyszukiwania i fragmenty plików
Jeśli produkt uznał, że są potrzebne. Model dostaje je jako zwykły tekst — tak samo jak twoje zdanie.
Twoje pytanie
Ostatnie w kolejce. Przy dłuższej rozmowie — ułamek procenta całości.
Model
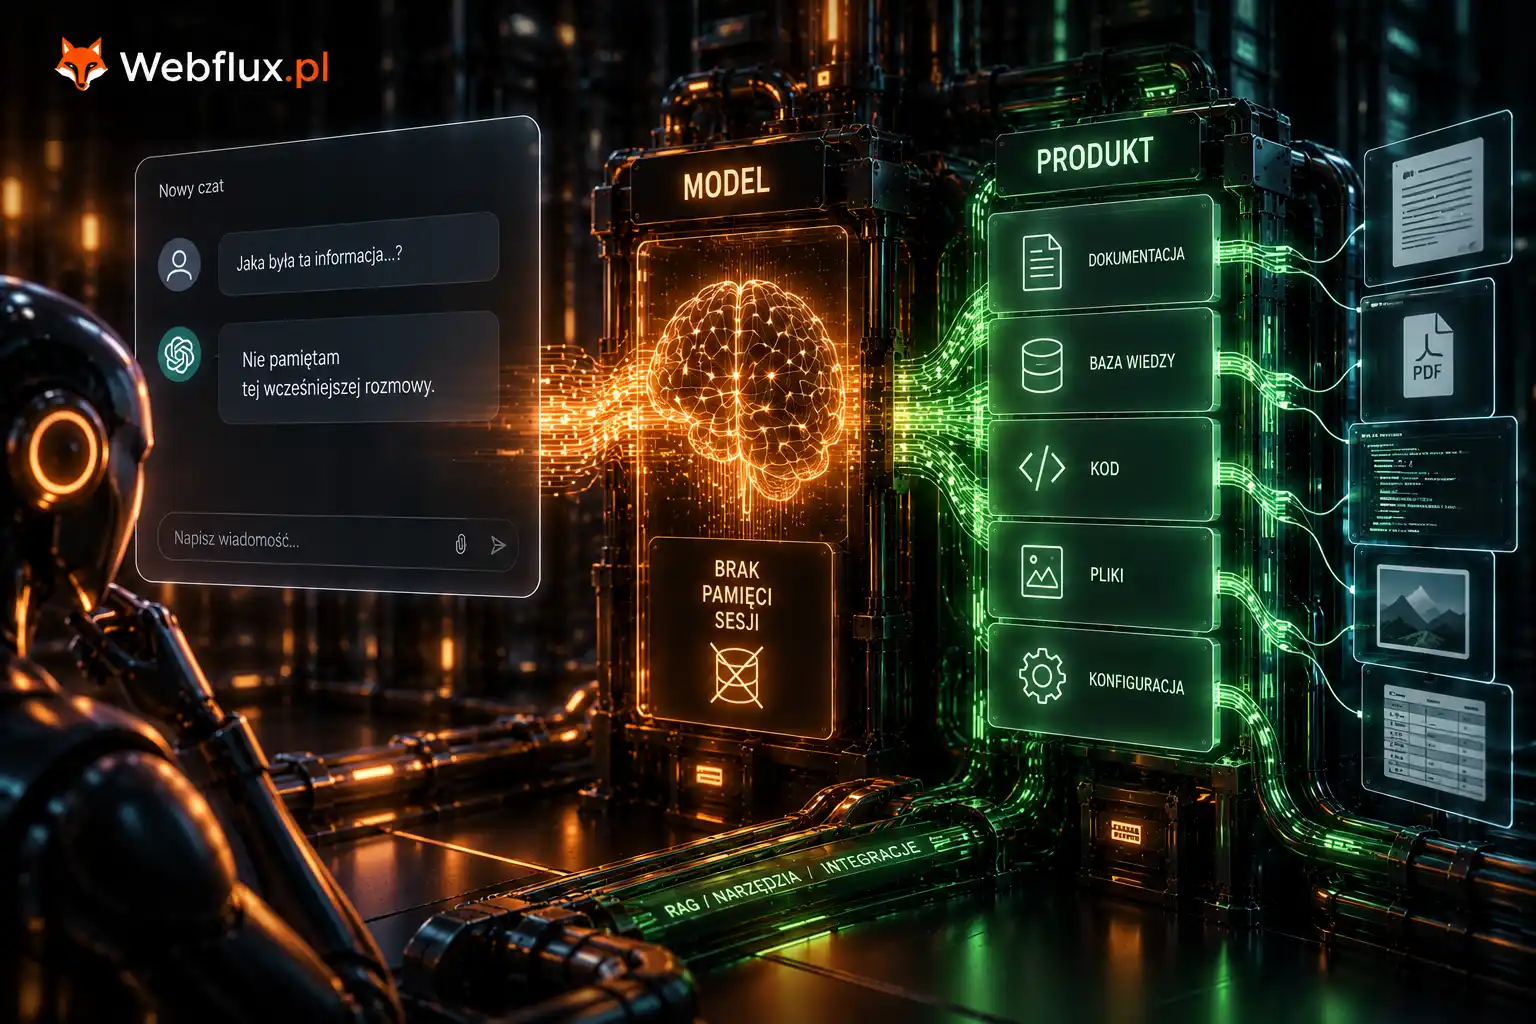
Zamrożone wagi. Nie pamięta poprzedniej tury, nie wie, która część to ty, a która produkt. Widzi jeden tekst i przewiduje, co powinno paść dalej.
Rozmiary warstw celowo nie są tu pokazane w proporcjach — zależą od produktu i nie są publicznie znane. Znana jest kolejność i to, że twoje zdanie stoi na samym końcu.
Dlaczego to nie jest spisek
Warto od razu odgrodzić się od interpretacji, która się tu narzuca.
Nic z tego nie jest ukrywaniem. To jest produkt — to samo, co robi przeglądarka, gdy między twoje wpisanie adresu a wyświetloną stronę wstawia DNS, cache, kompresję i renderowanie. Nikt nie oczekuje, że przeglądarka pokaże ci nagłówki HTTP przy każdym kliknięciu.
Różnica polega na tym, że przy przeglądarce wszyscy wiedzą, że te warstwy istnieją. Przy czacie większość ludzi jest przekonana, że rozmawia z modelem bezpośrednio — i przypisuje modelowi zachowania, które należą do produktu.
To jest cały cel tego toru: nie zdemaskować niczego, tylko przypisać rzeczy właściwej warstwie.
Cztery zachowania, które nie należą do modelu
Teraz konkretnie. Oto rzeczy, o które ludzie mają pretensje do modelu, a które robi coś innego.
„Model odmówił, choć w API by odpowiedział.” To zwykle instrukcja systemowa produktu, nie sam model. Ten sam model przez API, z twoją instrukcją, zachowa się inaczej. Różnica siedzi w warstwie, której nie widzisz.
„Model sam poszedł do internetu.” Nie poszedł. Produkt uznał, że zapytanie wymaga wyszukania, wywołał wyszukiwarkę i wkleił wyniki do kontekstu. Model dostał je jako tekst, tak samo jak twoje zdanie. Prosi o wywołanie narzędzia, wykonuje pętla — to rozróżnienie obowiązuje tu identycznie jak w agencie, którego budujesz sam.
„Model zna dzisiejszą datę, więc ma dostęp do internetu.” Nie ma. Data została wstrzyknięta do kontekstu jako tekst. To jedno z najczęstszych nieporozumień i najłatwiejszych do sprawdzenia.
„Model odpowiada inaczej niż wczoraj, choć nic nie zmieniłem.” Możliwe, że zmieniła się instrukcja systemowa albo router skierował cię do innego wariantu modelu. Producenci aktualizują tę warstwę bez ogłoszeń, bo jest częścią produktu, nie modelu.
Ile z tego kontekstu to ty
Zróbmy rachunek, bo liczba bywa zaskakująca.
W rozmowie, która trwa od dwudziestu minut, na kontekst wysyłany przy twojej ostatniej wiadomości składa się zwykle: kilka tysięcy tokenów instrukcji systemowej, kilka tysięcy definicji narzędzi, kilkanaście do kilkudziesięciu tysięcy historii rozmowy, czasem kilka tysięcy z wyszukiwania — i kilkanaście tokenów twojego pytania.
Twój udział w tym, co model widzi, to ułamek procenta.
To nie znaczy, że twoje zdanie nie ma znaczenia — ma, bo stoi na końcu i mechanizm uwagi premiuje to, co świeże i konkretne. Ale znaczy, że intuicja „napisałem X, więc model odpowiada na X” jest uproszczeniem. Model odpowiada na całość, w której X jest ostatnim akapitem.
Dlaczego rozmowa potrafi „zgłupieć”
Z tego rachunku wynika zjawisko, które każdy zna z praktyki: po godzinie rozmowy model zaczyna gubić instrukcje, które na początku respektował.
Nie zapomniał ich. One nadal są w kontekście, na samej górze. Tylko że teraz konkurują o uwagę z czterdziestoma tysiącami tokenów historii, wynikami wyszukiwania i twoimi ostatnimi dziesięcioma pytaniami. Waga pojedynczej instrukcji rozmyła się wśród tysięcy innych pozycji.
Stąd praktyczna rada, która działa lepiej niż powtarzanie „pamiętaj, że masz X”: zacznij nową rozmowę. Nie dlatego, że model się zepsuł, tylko dlatego, że kontekst spuchł.
Stąd też bierze się coś, co bywa odbierane jako złośliwość produktu — automatyczne streszczanie wcześniejszej części rozmowy. To nie jest kasowanie twoich danych. To zwalnianie miejsca, bez którego sesja przestałaby działać.
Jak to sprawdzić samemu
Trzy rzeczy, które możesz zrobić w pięć minut i które zmieniają intuicję bardziej niż ten artykuł.
Zapytaj o kontekst wprost. „Jaka jest dzisiejsza data i skąd ją znasz?” Większość produktów odpowie zgodnie z prawdą, że została wstrzyknięta. To najprostszy dowód na istnienie warstwy.
Porównaj z API. To samo pytanie, ten sam model, przez API, bez instrukcji systemowej. Różnica w odpowiedzi to dokładnie to, co dokłada produkt.
Obserwuj, kiedy pojawia się wyszukiwanie. Zadaj to samo pytanie raz z prośbą o nieużywanie internetu, raz bez. Zobaczysz, że decyzja nie należy do modelu, tylko do warstwy nad nim.
Co dalej
Jedna z wymienionych warstw zasługuje na osobny artykuł, bo jest źródłem największego nieporozumienia w całym kontakcie zwykłych ludzi z AI.
Wszyscy mówią, że model pamięta rozmowę. Model nie pamięta niczego. Wagi są zamrożone, między turami nie zapisuje się nic, a wrażenie ciągłości powstaje przez mechanizm tak prosty, że po jego poznaniu kilka rzeczy przestaje dziwić — w tym rachunek za API.
Następny artykuł zamyka serię.