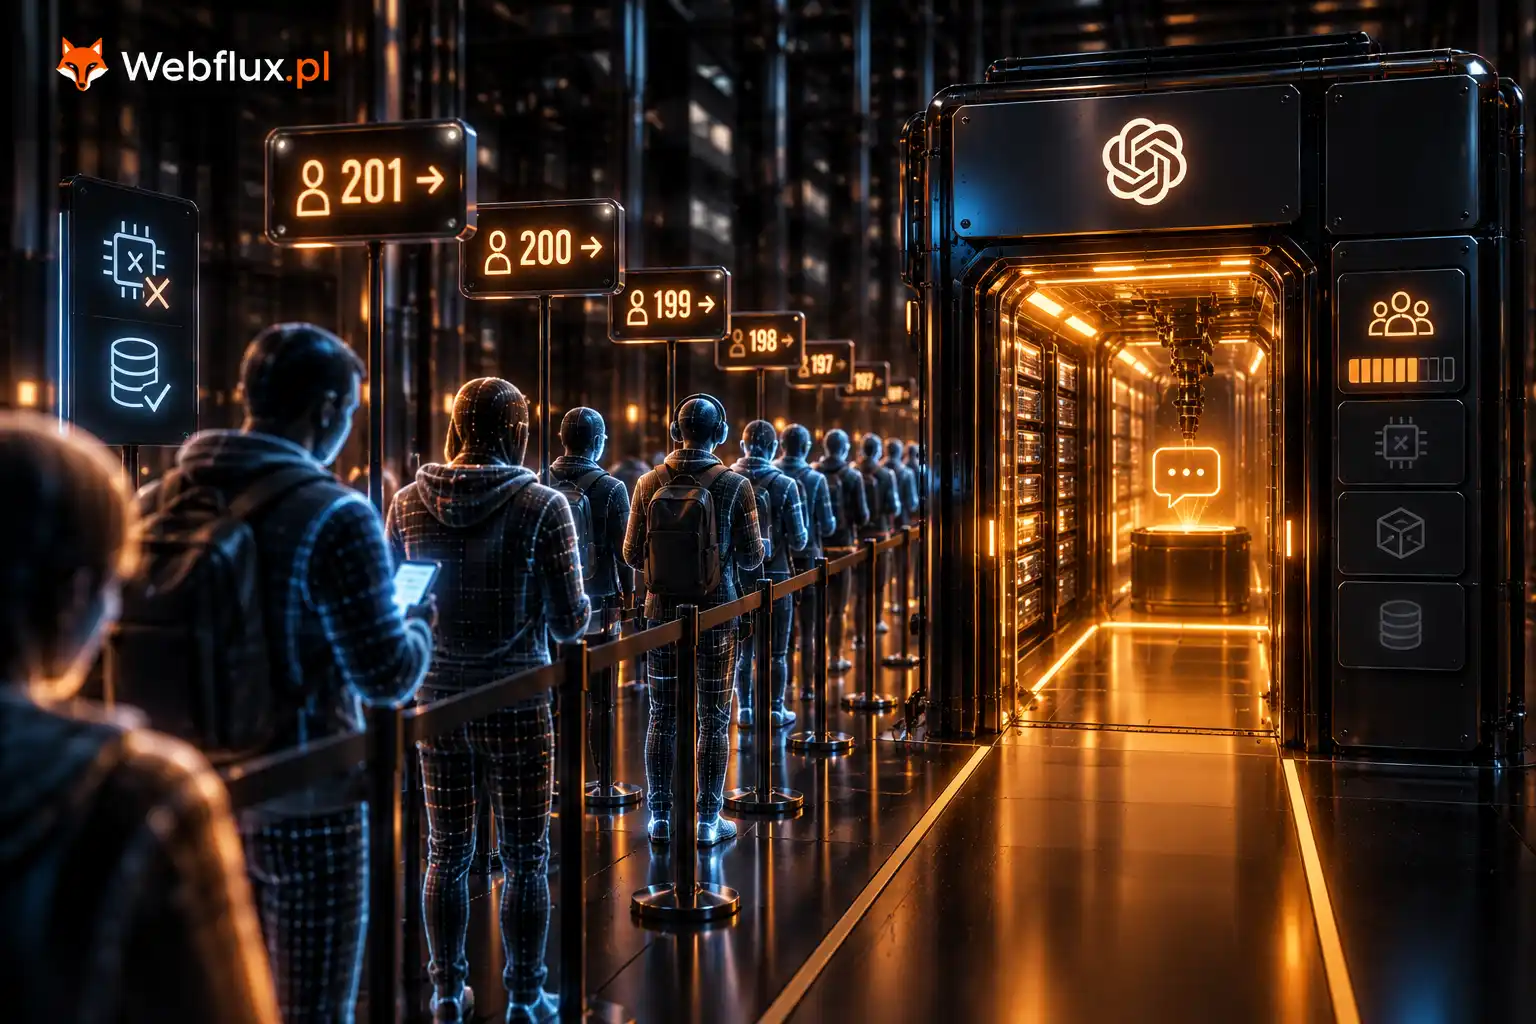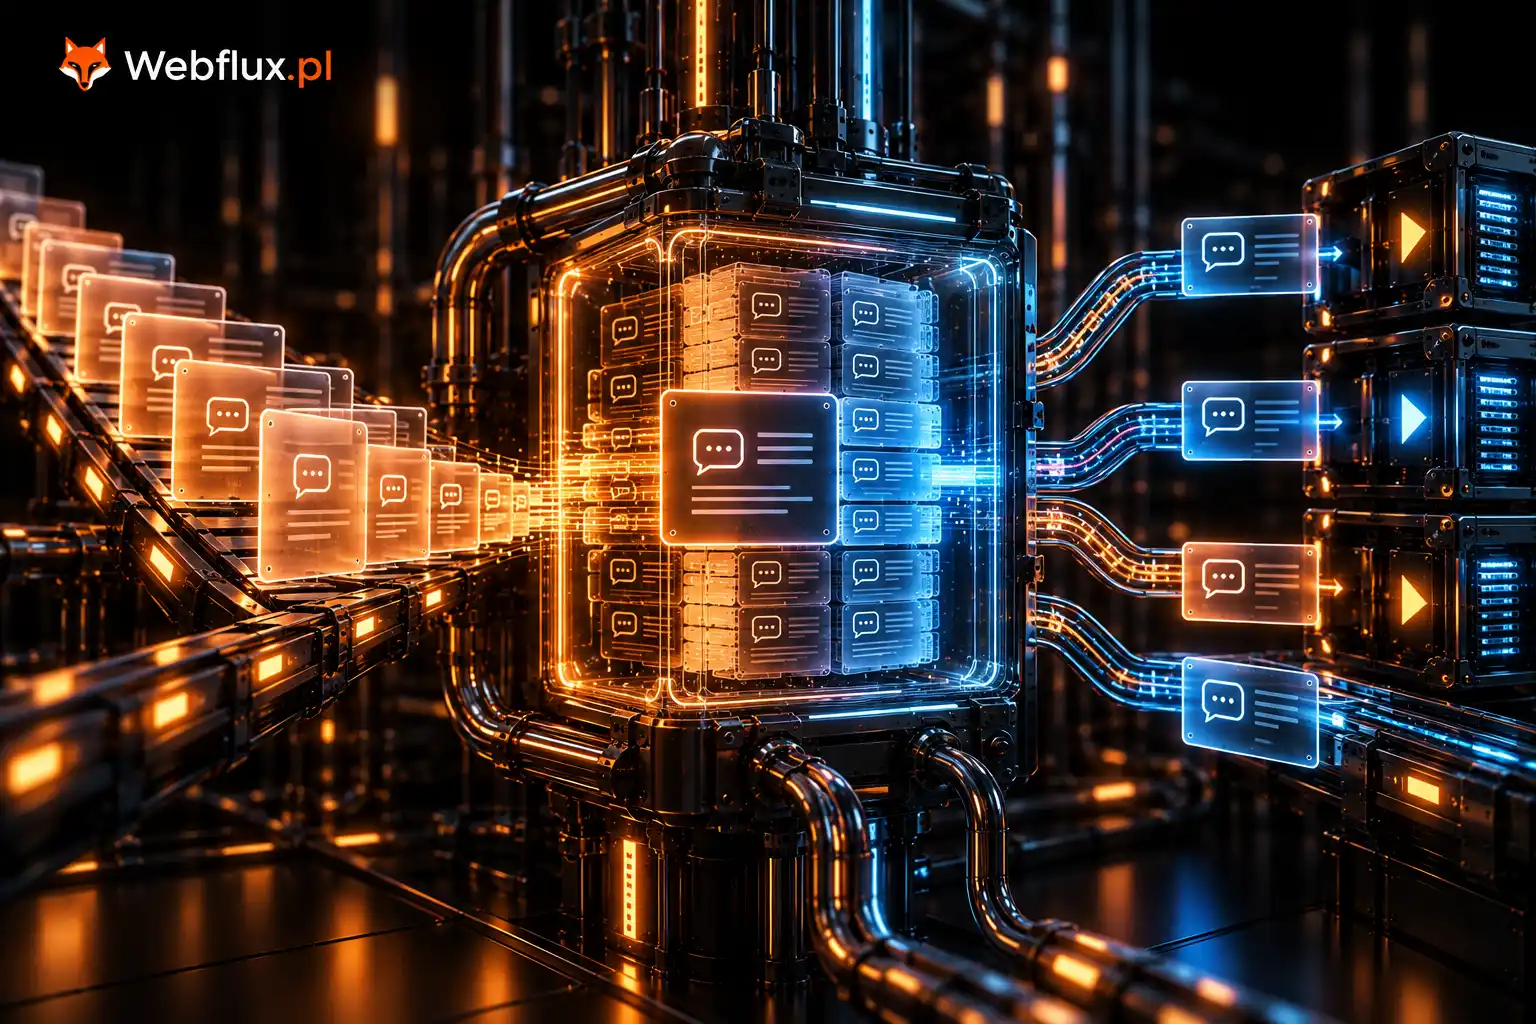
Twoja prośba nie jest obsługiwana sama. Dzieli kartę z kilkudziesięcioma innymi i to nie jest oszczędność dostawcy — to jedyny sposób, żeby rachunek w ogóle się domknął. Wszystko, co odczuwasz jako dziwactwa API, wynika z tej jednej decyzji: kolejka, wahania czasu odpowiedzi, limity liczone w tokenach, a nie w żądaniach.
W poprzednim artykule policzyliśmy, że karta obsługująca jedną rozmowę w fazie generowania pracuje na dwóch procentach mocy. Teraz zobaczymy, co dostawca z tym robi — i jaką cenę ty za to płacisz.
Dlaczego nie można inaczej
Zacznijmy od rachunku, który prowadzi do jedynego możliwego rozwiązania.
Karta serwerowa kosztuje kilkadziesiąt tysięcy dolarów i zużywa tyle prądu co kilka gospodarstw domowych. Obsługując jedną rozmowę w fazie generowania, wykorzystuje między jednym a trzema procentami swojej mocy obliczeniowej. Dziewięćdziesiąt siedem procent sprzętu stoi i czeka, aż wagi przepłyną z pamięci do rdzeni.
Gdyby dostawca przydzielał każdemu klientowi osobną kartę, cena tokenu musiałaby być kilkadziesiąt razy wyższa niż jest. Nie o kilkadziesiąt procent — kilkadziesiąt razy.
Więc robi jedyną rzecz, jaką może zrobić.
Jeden odczyt, dwieście rozmów
Kluczowa obserwacja jest prosta do sformułowania i trudna do docenienia za pierwszym razem: wagi odczytane z pamięci są te same dla wszystkich.
Model nie personalizuje się pod rozmowę. Te 3,5 gigabajta, które trzeba przeczytać, żeby wygenerować twój kolejny token, to dokładnie te same 3,5 gigabajta, które trzeba przeczytać dla kogoś innego. Skoro wąskim gardłem był odczyt, a rdzenie i tak stały bezczynnie — jeden odczyt może obsłużyć dwieście rozmów zamiast jednej.
Zamiast przepuszczać przez warstwę jeden wektor, przepuszczasz macierz o dwustu wierszach. Ta sama operacja, ten sam odczyt wag, dwieście razy więcej wykonanej pracy. Czas rośnie nieznacznie, bo dopiero przy dużych partiach rdzenie zaczynają być realnym ograniczeniem.
To jest cała ekonomia tej branży w jednym zdaniu. Reszta artykułu to konsekwencje.
Dlaczego „ciągły”, a nie zwyczajny
Najprostsza wersja tego pomysłu wyglądałaby tak: zbierz dwieście żądań, przetwórz je razem od początku do końca, wypuść wyniki, zbierz następne dwieście.
I byłaby katastrofą. Odpowiedzi mają bardzo różną długość — jedna kończy się po trzydziestu tokenach, inna po trzech tysiącach. Przy takim podejściu sto dziewięćdziesiąt dziewięć rozmów czeka na tę jedną najdłuższą, a karta przez większość czasu liczy głównie puste miejsca.
Batching ciągły rozwiązuje to tak, że partia jest płynna. Rozmowa, która się skończyła, opuszcza ją natychmiast, a na jej miejsce wchodzi następna z kolejki — bez czekania, aż pozostałe dobiegną końca. Skład partii zmienia się przy każdym kroku generowania.
Efekt jest taki, że karta pracuje niemal bez przestojów. Kosztem jest to, że twoja rozmowa dzieli zasoby ze zbiorem, który zmienia się w trakcie i o którym nic nie wiesz.
Gdzie dokładnie ginie twój czas
Teraz możemy nazwać to, co w poprzednim artykule zostawiłem jako „kolejka”.
Czekanie na wejście. Twoja prośba trafia do systemu w momencie, gdy partia jest właśnie przetwarzana. Wchodzi przy najbliższym kroku, jeśli jest miejsce — albo czeka, aż ktoś skończy. To jest zmienna, na którą nie masz żadnego wpływu i która najbardziej psuje przewidywalność czasu odpowiedzi.
Konkurencja o prefill. Przetwarzanie promptu obciąża rdzenie, w przeciwieństwie do generowania. Jeśli w tym samym momencie do systemu wchodzi kilka długich promptów, ich prefill rywalizuje o tę samą moc obliczeniową — i twoje generowanie zwalnia, mimo że sam nic nie zmieniłeś.
Niektórzy dostawcy rozdzielają te dwie fazy na osobne pule maszyn właśnie po to, żeby czyjś długi prompt nie spowalniał cudzego strumienia. Jeśli zauważasz, że u jednego dostawcy tempo generowania jest stabilniejsze niż u innego przy tym samym modelu, to jest jedna z możliwych przyczyn.
Miejsce w pamięci. Każda rozmowa w partii trzyma własną pamięć podręczną kontekstu, która rośnie z każdym tokenem. To ona, a nie wagi, ogranicza liczbę równoległych sesji — wagi są wspólne, historie nie. Dlatego długie rozmowy zajmują nie tylko więcej czasu, ale i więcej miejsca, którego nie da się oddać nikomu innemu.
Limity przestają być złośliwością
Dostawcy podają zwykle dwa limity: liczbę żądań na minutę i liczbę tokenów na minutę. Drugi jest ważniejszy i teraz widać dlaczego.
Miejsce w partii nie jest liczone w żądaniach. Jest liczone w pamięci zajmowanej przez kontekst. Żądanie z promptem na trzydzieści tysięcy tokenów zajmuje kilkadziesiąt razy więcej miejsca niż żądanie z promptem na pięćset — i blokuje je przez cały czas generowania.
Stąd bierze się zaskoczenie, które spotyka wielu ludzi przy pierwszym większym wdrożeniu: limit tokenów wyczerpuje się od ilości kontekstu wysyłanego wielokrotnie, nie od ilości nowej treści. Dwadzieścia wymian w rozmowie o długości trzydziestu tysięcy tokenów to sześćset tysięcy tokenów wejściowych, nie dwadzieścia zdań. Za każdym razem cała historia idzie przez prefill od nowa, bo pamięć podręczna została zwolniona zaraz po poprzedniej odpowiedzi.
Nie jest to limit administracyjny. Jest to rachunek za pracę, która naprawdę się wykonuje.
Dwie rzeczy, które powinieneś z tego wyciągnąć
Opóźnienie jest rozkładem, nie liczbą. Skoro skład partii zmienia się przy każdym kroku i nie masz na niego wpływu, to czas odpowiedzi ma naturalną zmienność, która nie jest awarią. Planowanie limitów czasowych na podstawie średniej gwarantuje, że co jakiś czas będziesz je przekraczał. Planuj na wartościach skrajnych — te z górnego jednego procenta bywają wielokrotnie wyższe od mediany.
Ponowienia muszą mieć rosnący odstęp. Agent, który po odrzuceniu żądania próbuje natychmiast, dokłada się do zatoru, który właśnie spowodował odrzucenie. Odstęp rosnący wykładniczo nie jest formalnością z dokumentacji — jest warunkiem, żeby system w ogóle się rozładował.
Czego batching nie naprawia
Warto też powiedzieć, czego ten mechanizm nie daje, bo łatwo o nadmierne oczekiwania.
Nie przyspiesza pojedynczej rozmowy. Twoje tokeny na sekundę są mniej więcej takie same w pustej partii i w pełnej — bo ogranicza je przepustowość pamięci, która jest wspólna. Batching poprawia liczbę obsłużonych rozmów, nie tempo jednej.
Nie pomaga na prefill w tym samym stopniu co na generowanie. Prefill już obciąża rdzenie, więc łączenie go w partie daje znacznie mniejszy zysk.
I pogarsza tempo pojedynczej rozmowy — ale dopiero po przekroczeniu pewnego progu. Dopóki wąskim gardłem jest odczyt wag, każda dołożona rozmowa jest darmowa: koszt tokenu spada, a twoje tokeny na sekundę się nie zmieniają. Powyżej progu wąskim gardłem stają się rdzenie i dalsze powiększanie partii przestaje obniżać koszt, za to spowalnia wszystkich. Dostawcy ustawiają ten suwak w różnych miejscach i stąd biorą się różnice w ofertach tego samego modelu.
Co dalej
Zwróć uwagę na rzecz, która w tym artykule pojawiła się dwa razy i za każdym razem jako koszt: cała historia rozmowy przechodzi przez prefill przy każdym zapytaniu, bo pamięć podręczna została zwolniona.
To wygląda na oczywiste marnotrawstwo. Przy agencie z długim promptem systemowym, który wysyła ten sam początek kontekstu trzydzieści razy pod rząd, jest to marnotrawstwo wręcz obraźliwe.
I rzeczywiście da się tego uniknąć — pod jednym warunkiem, który brzmi niewinnie, a w praktyce wywraca sposób budowania promptów. Następny artykuł jest o tym warunku i o tym, dlaczego jego złamanie potrafi po cichu potroić rachunek.
Symulator partii webflux · maszyneria modelu
Ścieżka przez widget
Zostaw suwak na jedynce i popatrz kilkanaście sekund — kolejka puchnie, karta pokazuje 1,7%, tempo 746 tokenów na sekundę. Najszybciej jak się da, dla jednej osoby, przy karcie zmarnowanej w dziewięćdziesięciu ośmiu procentach.
Przesuń na szesnaście. Kolejka przestaje rosnąć, koszt spada szesnastokrotnie — a tempo nadal 746. Na trzydzieści dwa: kolejka pustoszeje, koszt ×32, tempo wciąż 746. Do tego momentu każda dołożona rozmowa jest darmowa.
Teraz sześćdziesiąt cztery. Koszt zatrzymuje się na ×46 i dalej nie spada, a tempo leci z 746 na 536. To jest próg: od tego miejsca powiększanie partii spowalnia wszystkich i nie daje już nic.