Objawy
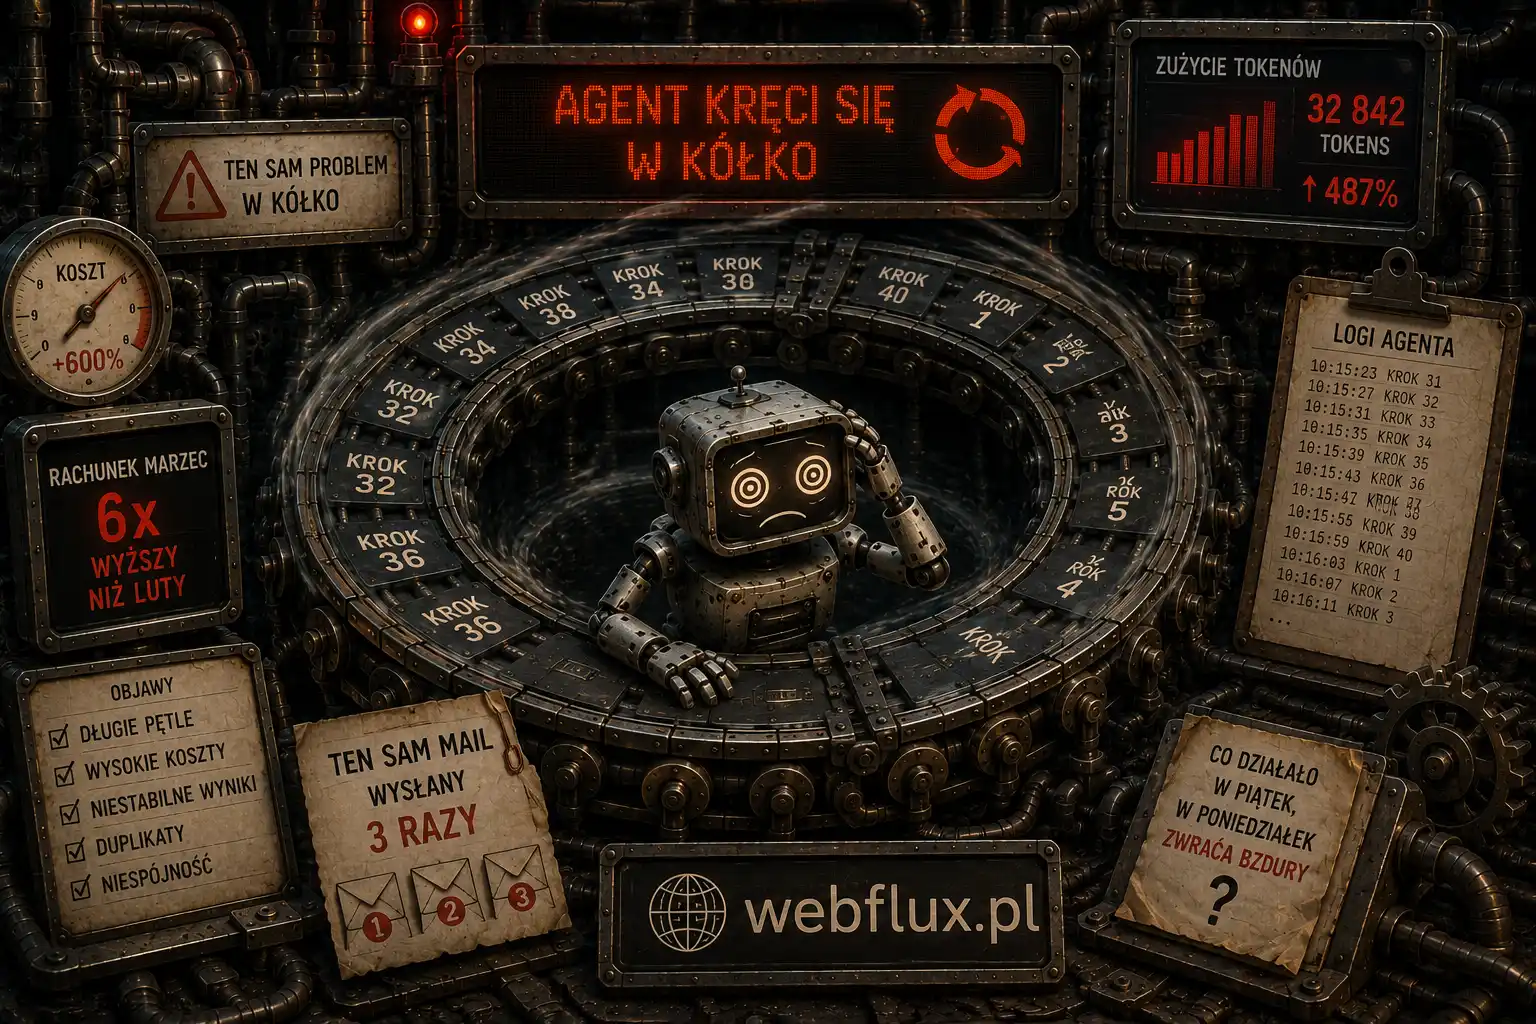
Agent wykonuje kolejne obroty pętli, nie zbliżając się do zakończenia zadania. W dzienniku widać jedną z trzech postaci.
Powtórzenie. To samo narzędzie, te same argumenty, raz za razem — czasem dziesiątki razy pod rząd.
Oscylacja. Agent wywołuje na przemian dwa narzędzia, wracając wciąż w to samo miejsce. Żadne dwa kolejne kroki nie są identyczne, więc prosty detektor tego nie łapie.
Dryf argumentów. To samo narzędzie, argumenty zmieniane minimalnie: raz z myślnikiem, raz bez, raz po polsku, raz po angielsku, raz z prefiksem. Z zewnątrz wygląda jak postęp.
Sygnały pośrednie, które warto sprawdzić w statystykach: liczba kroków w prawym ogonie rozkładu wyraźnie odstająca od mediany, wysoki udział zakończeń wymuszonych limitem oraz przebiegi kosztujące wielokrotnie więcej niż typowe przy pozornie tym samym zadaniu.
Mechanizm w trzech zdaniach
Model nie pamięta poprzedniego kroku — widzi wyłącznie kontekst. Jeśli wynik narzędzia nie wniósł informacji, której szukał, sytuacja przy kolejnym obrocie wygląda niemal identycznie jak poprzednio, a niemal identyczne wejście daje niemal identyczną decyzję.
To nie jest błąd modelu, tylko konsekwencja predykcji kolejnego tokenu. Warstwę wykonawczą, w której to się dzieje, opisuje artykuł o warunkach zakończenia.
Diagnostyka różnicowa
Ten sam objaw ma sześć różnych przyczyn i każda wymaga innej naprawy. Poniżej w kolejności od najczęstszej.
1. Narzędzie zwraca pustkę bez wyjaśnienia
Jak rozpoznać: w śladzie wynik narzędzia to [], null, {} albo pusty ciąg.
Dlaczego to zapętla: model nie odróżnia „nie znaleziono” od „zapytanie było złe”. Skoro nie wie, próbuje jeszcze raz.
Test: podmień wynik na jawny komunikat i powtórz przebieg. Jeśli agent kończy w jednym kroku, masz przyczynę.
2. Ciche odrzucenie przez walidację
Jak rozpoznać: w logu pętli widać odrzucenia, a w kontekście modelu nie ma po nich śladu — albo jest lakoniczny błąd bez powodu.
Dlaczego to zapętla: z perspektywy modelu nic się nie wydarzyło. Skoro nic się nie wydarzyło, próbuje ponownie.
Test: sprawdź, czy powód odrzucenia wraca do modelu jako wynik narzędzia. Jeśli logujesz odrzucenia tylko po swojej stronie, to jest to.
3. Zadanie jest niewykonalne dostępnymi narzędziami
Jak rozpoznać: agent próbuje kolejno różnych narzędzi, każdego raz albo dwa, żadne nie przybliża do celu. To wersja najbardziej przypominająca sensowne działanie.
Dlaczego to zapętla: model szuka drogi, której nie ma, bo nic w kontekście nie mówi, że jej nie ma.
Test: przeczytaj zadanie i katalog narzędzi. Czy dałoby się je wykonać ręcznie tymi narzędziami? Jeśli nie — problem jest w projekcie, nie w agencie.
4. Format argumentu jest niedookreślony
Jak rozpoznać: klasyczny dryf. Argumenty krążą wokół tej samej wartości w różnych zapisach.
Dlaczego to zapętla: model zgaduje konwencję twojego systemu, bo definicja narzędzia jej nie podaje. Każde zgadnięcie jest równie prawdopodobne.
Test: sprawdź, czy opis pola zawiera format. Jeśli brzmi „numer zamówienia” zamiast „numer zamówienia w formacie ZAM-0000″, masz przyczynę.
5. Wynik jest, ale model go nie rozumie
Jak rozpoznać: narzędzie zwróciło dane, agent i tak wywołuje je ponownie albo sięga po inne.
Dlaczego to zapętla: dane są w formie, z której model nie potrafi wyciągnąć odpowiedzi — zagnieżdżona struktura bez etykiet, identyfikatory bez opisu, skróty.
Test: przeczytaj wynik narzędzia tak, jak widzi go model, bez znajomości twojej bazy. Czy da się z tego odpowiedzieć na pytanie?
6. Kontekst został przycięty i model stracił historię
Jak rozpoznać: zapętlenie zaczyna się dopiero po kilkunastu krokach, wcześniej agent działał sensownie. Powtarzany krok był wykonany wcześniej.
Dlaczego to zapętla: kompaktowanie albo przycinanie historii usunęło informację o już wykonanym kroku. Model powtarza go, bo dla niego to pierwszy raz.
Test: sprawdź, czy w przebiegu zadziałał mechanizm skracania kontekstu i czy usunięty fragment zawierał powtórzony krok.
Postępowanie
Natychmiast: upewnij się, że pętla ma limit kroków i limit budżetu. To zatrzymuje krwawienie, nie leczy przyczyny.
Potem, zależnie od rozpoznania: przy przyczynie pierwszej i drugiej — komunikat zamiast pustki i powód odrzucenia wracający do modelu. Przy czwartej i piątej — poprawa definicji narzędzia i formatu wyniku. Przy trzeciej — zmiana zakresu zadania albo katalogu. Przy szóstej — zachowanie śladu wykonanych kroków poza kontekstem podlegającym skracaniu.
Nigdy: nie kontynuuj po cichu i nie licz na to, że mocniejszy model to rozwiąże. Zapętlenie na słabszym modelu jest objawem, nie chorobą — na mocniejszym objaw bywa rzadszy, a przyczyna zostaje.
Profilaktyka
Detektor porównujący nazwę narzędzia i argumenty w oknie kilku ostatnich wywołań, nie tylko dwóch kolejnych — inaczej oscylacja przechodzi bez zatrzymania. Normalizacja argumentów przed porównaniem, żeby złapać dryf.
Narzędzia, które nigdy nie zwracają pustki bez wyjaśnienia. Odrzucenia walidacji zawsze wracające do modelu z powodem. Logowanie odrzuceń, nie tylko wykonań — bo to najwcześniejszy sygnał.
Jak zdiagnozować u siebie
Analizator śladu klasyfikujący typ zapętlenia. Podstaw własny log.
import json, re
from collections import Counter

def normalizuj(argumenty):
    s = json.dumps(argumenty, sort_keys=True, ensure_ascii=False).lower()
    return re.sub(r"[\s\-_]", "", s)

def diagnoza(slad, okno=6):
    """slad: lista {'narzedzie':..., 'argumenty':{...}, 'wynik':...}"""
    sygnatury = [(k["narzedzie"], normalizuj(k["argumenty"])) for k in slad]
    narzedzia = [k["narzedzie"] for k in slad]

    ostatnie = sygnatury[-okno:]
    licznik = Counter(ostatnie)
    powtorka, ile = licznik.most_common(1)[0] if licznik else ((None, None), 0)

    if ile >= 3:
        print(f"POWTÓRZENIE: {powtorka[0]} — {ile} razy w oknie {okno}")
    elif len(set(narzedzia[-okno:])) == 2 and okno >= 4:
        print(f"OSCYLACJA między: {set(narzedzia[-okno:])}")
    elif len(set(narzedzia[-okno:])) == 1 and len(set(ostatnie)) >= 3:
        print(f"DRYF ARGUMENTÓW w narzędziu {narzedzia[-1]}")
    else:
        print("Brak wyraźnego wzorca zapętlenia w oknie.")

    # wskazówka co do przyczyny
    puste = sum(1 for k in slad if k.get("wynik") in ([], None, {}, ""))
    if puste:
        print(f"  → {puste} wywołań zwróciło pustkę bez komunikatu "
              f"(przyczyna nr 1)")
    odrzucone = sum(1 for k in slad if k.get("odrzucenie"))
    if odrzucone:
        print(f"  → {odrzucone} odrzuceń walidacji — sprawdź, czy powód "
              f"wraca do modelu (przyczyna nr 2)")

slad = [
    {"narzedzie": "szukaj_zamowien", "argumenty": {"klient": "KL-12"}, "wynik": []},
    {"narzedzie": "szukaj_zamowien", "argumenty": {"klient": "kl12"},  "wynik": []},
    {"narzedzie": "szukaj_zamowien", "argumenty": {"klient": "KL_12"}, "wynik": []},
    {"narzedzie": "szukaj_zamowien", "argumenty": {"klient": "KL-012"},"wynik": []},
]
diagnoza(slad)
Powyższy ślad to podręcznikowy dryf argumentów z pustymi wynikami — czyli przyczyny czwarta i pierwsza naraz, co zdarza się częściej niż każda z osobna. Normalizacja sprowadza trzy pierwsze warianty do jednej sygnatury, więc detektor rozpozna je jako powtórzenie mimo różnic w zapisie.
Ćwiczenie: puść to na dwudziestu realnych śladach i policz, ile z nich zawiera wywołania z pustym wynikiem. Jeśli więcej niż kilka procent, masz jedną naprawę do zrobienia, która zdejmie większość problemu — i nie dotyczy ona ani modelu, ani promptu.
Powiązane
Mechanizm pętli i warunków zakończenia: Maszyneria agenta. Dlaczego model nie pamięta poprzedniego kroku: Anatomia LLM.
Następny syndrom, często występujący razem z tym: Rachunek eksplodował, a nic się nie zmieniło.