Objawy
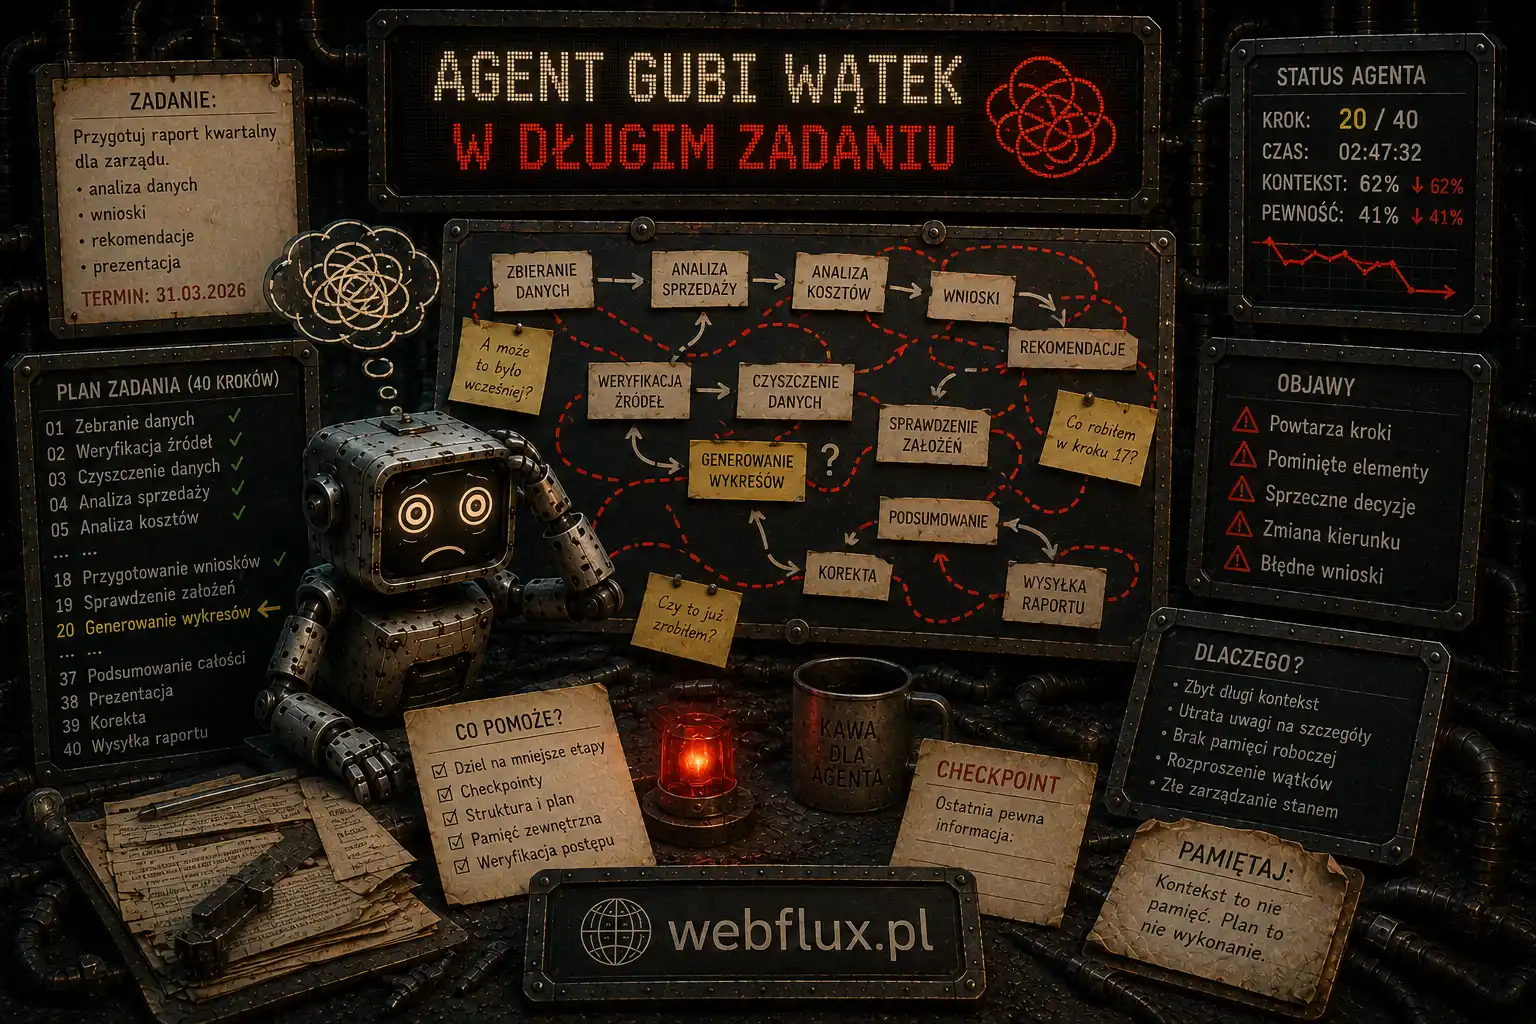
Pierwsze kroki idą wzorowo. Po kilkunastu agent zaczyna się rozjeżdżać.
Przestaje przestrzegać reguły z promptu systemowego, której trzymał się na początku. Zmienia format odpowiedzi w połowie zadania. Wraca do czegoś, co już ustalił, i ustala to inaczej. Odpowiada na pytanie sprzed kilku kroków zamiast na bieżące. Pomija ograniczenie, o którym wyraźnie mu powiedziano.
Odróżnienie od zapętlenia: tam agent powtarzał ten sam krok. Tutaj każdy krok jest inny, tylko całość przestaje się trzymać kupy.
Sygnał rozstrzygający: im dłuższy przebieg, tym gorzej. Jeśli jakość nie zależy od liczby kroków, to nie ten syndrom.
Mechanizm w trzech zdaniach
Mechanizm uwagi waży wszystkie pozycje w kontekście naraz — nie przegląda ich po kolei, nie premiuje instrukcji. Instrukcja umieszczona wśród kilkuset tokenów ma inną wagę niż ta sama instrukcja wśród kilkudziesięciu tysięcy.
Model o niej nie „zapomina” — jej wpływ się rozmywa. Mechanizm opisuje artykuł o attention, skutki dla planowania kontekstu — okno kontekstu i context rot.
Diagnostyka różnicowa
1. Rozmycie instrukcji przez narastanie kontekstu
Jak rozpoznać: degradacja stopniowa, wprost proporcjonalna do długości przebiegu. Najczęstsza przyczyna.
Test: powtórz krytyczną instrukcję jako ostatni element kontekstu przed wywołaniem i porównaj. Jeśli agent znów jej przestrzega, masz rozpoznanie.
2. Kluczowa informacja utonęła w środku
Jak rozpoznać: agent ignoruje konkretny fakt, który obiektywnie jest w kontekście — tyle że w połowie.
Dlaczego to boli: modele radzą sobie lepiej z początkiem i końcem sekwencji niż z jej środkiem.
Test: przesuń tę informację na koniec i powtórz. Ta sama treść, inne miejsce.
3. Kompaktowanie wycięło ustalenie
Jak rozpoznać: degradacja skokowa, nie stopniowa. Do kroku dwunastego wszystko dobrze, od trzynastego agent nie pamięta czegoś z kroku czwartego.
Test: sprawdź, w którym momencie zadziałał mechanizm skracania historii i czy usunięty fragment zawierał utracone ustalenie. To jedyna przyczyna z ostrą granicą czasową.
4. Sprzeczne instrukcje z różnych warstw
Jak rozpoznać: agent robi coś, co ktoś mu kazał — tylko nie ty.
Dlaczego to boli: prompt systemowy mówi jedno, wynik narzędzia sugeruje drugie, użytkownik w trzeciej wiadomości poprosił o trzecie. Model nie ma reguły pierwszeństwa i zwykle idzie za najświeższym.
Test: wypisz wszystkie instrukcje obecne w kontekście na moment błędu. Zaskakująco często okazuje się, że są sprzeczne, a nikt tego wcześniej nie zestawił.
5. Kontekst zaśmiecony wynikami narzędzi
Jak rozpoznać: policz, jaki procent kontekstu stanowią surowe wyniki narzędzi. Jeśli powyżej połowy — to jest to.
Dlaczego to boli: trzysta rekordów wklejonych w całości konkuruje o uwagę z twoimi instrukcjami. To ten sam problem, który w syndromie kosztowym objawiał się rachunkiem — tutaj objawia się jakością.
6. Przekroczenie użytecznego okna, nie nominalnego
Jak rozpoznać: kontekst mieści się w limicie, a mimo to model traci spójność.
Dlaczego to boli: okno nominalne i okno, w którym model faktycznie utrzymuje uwagę na wszystkim, to dwie różne wielkości. Deklarowane dwieście tysięcy tokenów nie znaczy, że przy stu pięćdziesięciu tysiącach wszystko działa równie dobrze.
7. Nieudane próby zostają w historii jako ustalenia
Jak rozpoznać: agent powtarza błąd, który już popełnił, albo buduje na wyniku, który wcześniej został odrzucony.
Dlaczego to boli: wywołanie zakończone błędem, argument odrzucony przez walidację, ścieżka porzucona w połowie — wszystko to zostaje w kontekście i wygląda jak część ustaleń.
Test: przejrzyj historię z perspektywy modelu i sprawdź, czy da się odróżnić kroki udane od nieudanych. Jeśli nie da się tego zrobić czytając, model też tego nie zrobi.
8. Format nie jest wymuszony, tylko poproszony
Jak rozpoznać: rozjeżdża się wyłącznie struktura odpowiedzi, treść pozostaje sensowna.
Dlaczego to boli: instrukcja „odpowiadaj w formacie JSON” przesuwa rozkład, a przy długim kontekście przesuwa go słabiej. Schemat wymuszony po stronie API nie podlega rozmyciu.
Postępowanie
Najpierw pomiar, nie poprawki. Zmierz zależność jakości od długości kontekstu — to rozstrzyga, czy problemem są przyczyny pierwsza, druga i szósta, czy któraś z pozostałych. Sposób w aneksie.
Powtórz krytyczne instrukcje na końcu. Najtańsza skuteczna interwencja. Trzy–pięć linii przypomnienia doklejane tuż przed wywołaniem, po całej historii. Kosztuje kilkadziesiąt tokenów i zwykle wystarcza przy przyczynie pierwszej.
Przycinaj wyniki narzędzi. Uchwyt zamiast pełnych danych — rozwiązuje przyczynę piątą i przy okazji rachunek.
Oznaczaj kroki nieudane wprost. „Ta próba została odrzucona, powód: …” zamiast zostawiania surowego błędu wśród udanych wyników. To naprawia przyczynę siódmą jednym zdaniem w formacie logu kroku.
Wymuś strukturę schematem zamiast prosić o nią w prompcie.
Trzymaj ustalenia poza kontekstem. Decyzje podjęte w trakcie zapisuj w stanie pętli i wstrzykuj jako zwięzłą listę, zamiast liczyć, że model odnajdzie je w historii. To odporne również na kompaktowanie.
Profilaktyka
Budżet kontekstu ustalony świadomie, niższy niż limit nominalny. Stała struktura: instrukcje na początku, przypomnienie na końcu, historia w środku i możliwie krótka.
Rozdzielenie tego, co model musi widzieć, od tego, co pętla ma pamiętać — czyli stan poza kontekstem.
Przy naprawdę długich zadaniach rozważ podział na etapy z jawnym przekazaniem ustaleń, zamiast jednego przebiegu na trzydzieści kroków.
Jak zdiagnozować u siebie
Test zależności jakości od długości kontekstu. Ta sama instrukcja, to samo pytanie, rosnąca ilość wypełniacza pomiędzy.
from openai import OpenAI

client = OpenAI()

INSTRUKCJA = ("Jesteś asystentem technicznym. ZASADA BEZWZGLĘDNA: każdą "
              "odpowiedź kończ linią 'ŹRÓDŁO: <nazwa systemu>'. "
              "Nigdy nie pomijaj tej linii.")

WYPELNIACZ = ("Wynik narzędzia: zamówienie {i}, status zrealizowane, "
              "kwota {k} PLN, kurier DPD, magazyn centralny. ")

def test(ile_wypelniacza, przypomnienie=False, n=3):
    historia = "".join(WYPELNIACZ.format(i=i, k=100+i)
                       for i in range(ile_wypelniacza))
    wiadomosci = [{"role": "system", "content": INSTRUKCJA},
                  {"role": "user", "content": historia +
                   "\n\nPytanie: jaki jest status zamówienia 5?"}]
    if przypomnienie:
        wiadomosci.append({"role": "user",
                           "content": "Pamiętaj o linii ŹRÓDŁO na końcu."})

    trafienia = 0
    for _ in range(n):
        r = client.chat.completions.create(
            model="gpt-4o-mini", messages=wiadomosci, max_tokens=120)
        tresc = r.choices[0].message.content
        trafienia += "ŹRÓDŁO:" in tresc
    tokeny = r.usage.prompt_tokens
    print(f"{tokeny:6} tokenów  przestrzega: {trafienia}/{n}"
          f"{'  (z przypomnieniem)' if przypomnienie else ''}")

for ile in (0, 50, 200, 600):
    test(ile)
print()
test(600, przypomnienie=True)
Pierwsze cztery uruchomienia pokazują krzywą: gdzieś przestaje działać reguła, która przy krótkim kontekście była przestrzegana bezwzględnie. Piąte pokazuje, ile z tego odzyskuje przypomnienie doklejone na końcu.
To jest cały test diagnostyczny w pięciu wierszach wyniku. Jeśli krzywa opada — masz przyczynę pierwszą i wiesz, że naprawa jest tania. Jeśli reguła łamie się od razu przy krótkim kontekście, problem leży gdzie indziej i wróć do listy przyczyn.
Ćwiczenie: podmień INSTRUKCJA na regułę ze swojego promptu systemowego, a wypełniacz na realne wyniki twoich narzędzi. Zmierz, przy ilu tokenach twoja reguła przestaje obowiązywać — i porównaj to z typową długością kontekstu na produkcji.
Powiązane
Jak działa uwaga i dlaczego kolejność w kontekście ma znaczenie: Anatomia LLM. Co trzymać poza kontekstem: Maszyneria agenta.
Następny syndrom: Agent zrobił to samo dwa razy.