Co to jest BMP? Goła mapa bitowa — i lekcja o tym, czym naprawdę jest kompresja
Co to jest JPG? Format, który nauczył internet słowa „kompresja”
Co to jest GIF? Format, który miał umrzeć, a stał się nieśmiertelny
Co to jest TIFF? Format, którego nigdy nie zobaczysz na stronie — i o to chodzi
Co to jest HEIC? Format zdjęć z iPhone’a, którego nie otwiera pół internetu
Co to jest SVG? Format obrazu, który nie jest obrazem
Co to jest PNG? Format, który po 22 latach dostał drugie życie
Co to jest JPEG XL? Format, który wygnano z przeglądarki — i który właśnie wraca
Co to jest AVIF? Format obrazu, który poszedł dalej niż WebP
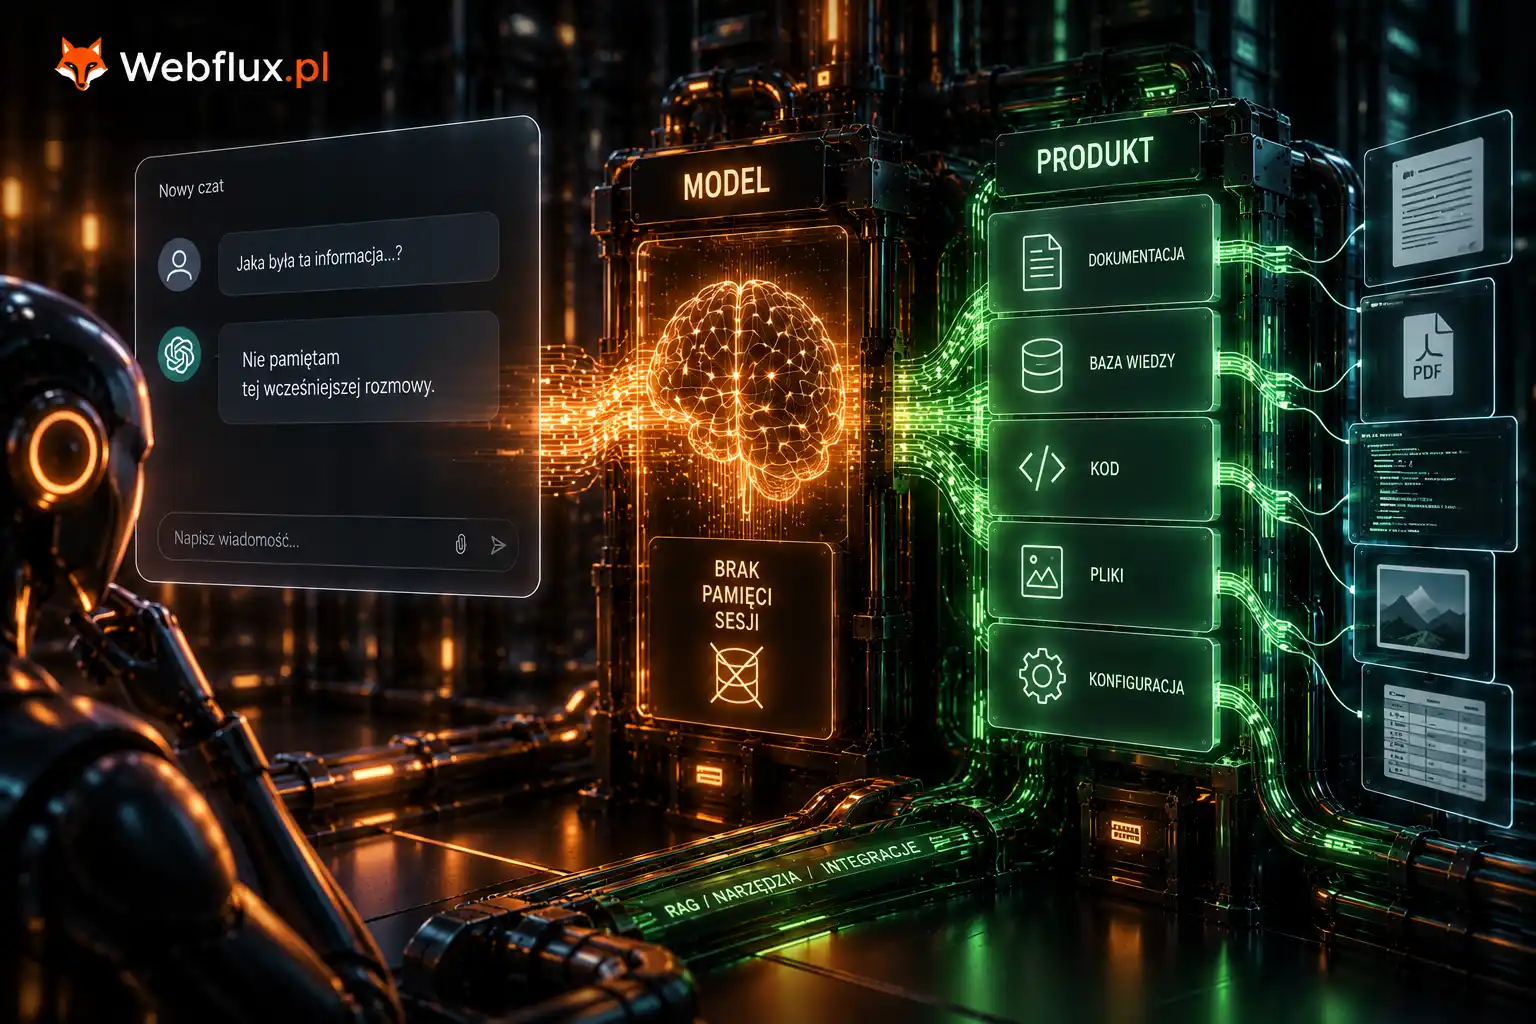
Model nie pamięta — pamięta produkt
Model nie pamięta ani jednego słowa z waszej poprzedniej wymiany. Wagi są zamrożone, między turami nie zapisuje się nic, a wrażenie ciągłości powstaje przez mechanizm tak prosty, że po jego poznaniu przestaje dziwić połowa rzeczy z tej serii — łącznie z rachunkiem za...
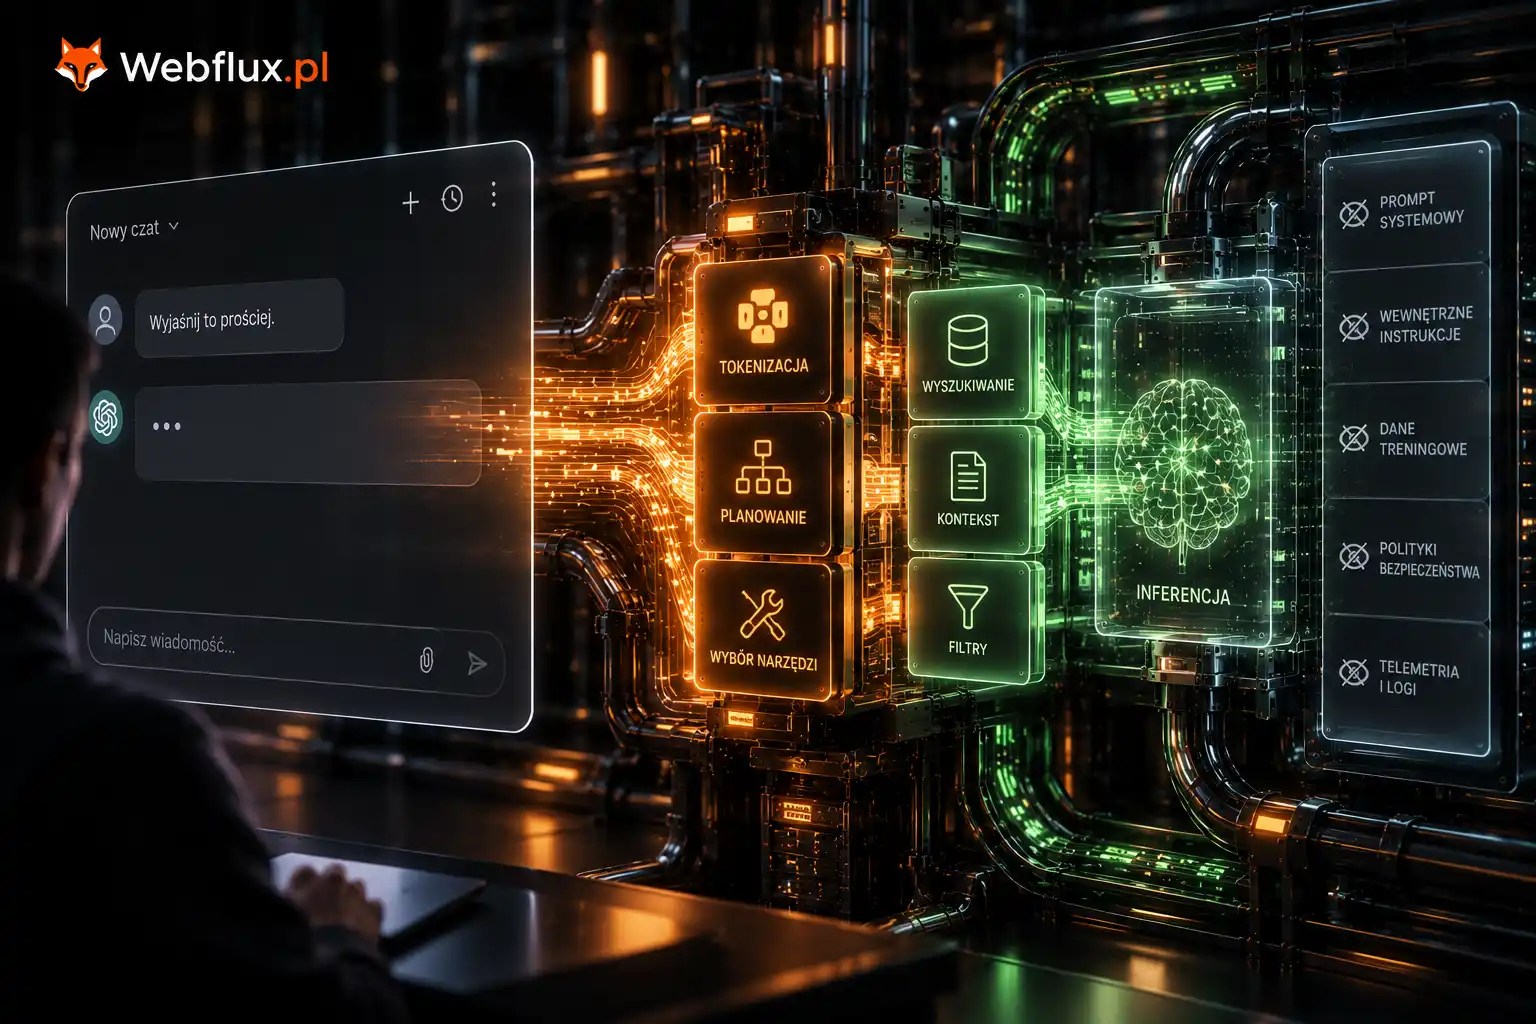
Czego nie widzisz w oknie czatu
Okno czatu wygląda jak najkrótsza możliwa droga do modelu, a jest najdłuższą. Między twoim zdaniem a wagami stoi więcej warstw niż w wywołaniu API — i żadnej z nich nie widzisz, nie ustawiasz i nie możesz wyłączyć. W poprzednim torze rozkładaliśmy to, co dzieje się na...
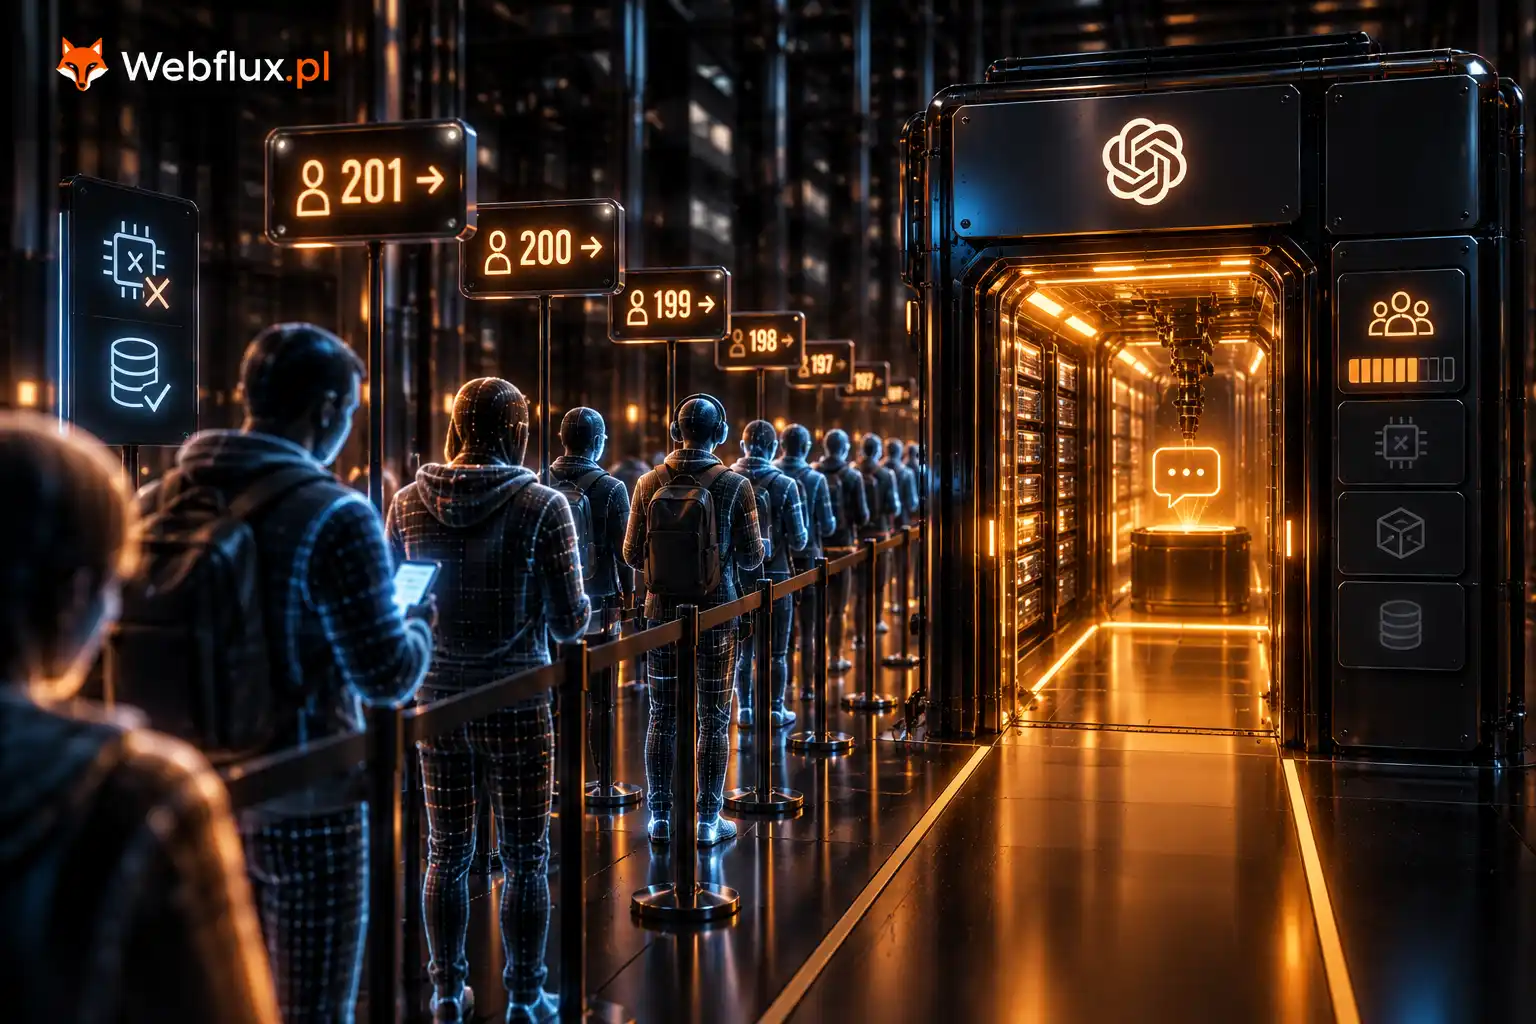
Nie płacisz za model — płacisz za miejsce w kolejce
Cennik API wygląda jak cennik produktu, a jest cennikiem czasu na karcie. Dwie kolumny, wejście i wyjście, różnica trzy- do pięciokrotnej — i żadna z tych liczb nie mówi o modelu. Mówią o tym, ile miejsca zajmujesz w partii i jak długo je blokujesz. To zamknięcie toru...
Prompt caching — dlaczego ta sama prośba raz kosztuje trzy razy mniej
Jest jedna optymalizacja, która potrafi ściąć rachunek za API o dwie trzecie, nie wymaga zmiany modelu ani frameworka i mieści się w jednej decyzji o kolejności tekstu. Jest też jedna rzecz, która ją unieważnia — i prawie każdy popełnia ten błąd przynajmniej raz. W...
Ten sam mechanizm, dwieście osób w kolejce
Twoja prośba nie jest obsługiwana sama. Dzieli kartę z kilkudziesięcioma innymi i to nie jest oszczędność dostawcy — to jedyny sposób, żeby rachunek w ogóle się domknął. Wszystko, co odczuwasz jako dziwactwa API, wynika z tej jednej decyzji: kolejka, wahania czasu...
Za HTTP — co dzieje się z prośbą po drugiej stronie
Między twoim fetch a pierwszym bajtem odpowiedzi stoi sześć warstw, z których tylko jedna jest modelem — a i ona dzieli się na dwie fazy o zupełnie różnym charakterze. Przez cztery poprzednie artykuły oglądaliśmy mechanizm na własnym urządzeniu, gdzie wszystko było...
Pierwszy token i cała reszta — prefill kontra decode
Model nie wykonuje jednej pracy, tylko dwie — i są to prace tak różne, że gdyby nie dzieliły wag, nikt nie nazwałby ich tym samym słowem. Jedna jest równoległa, obciąża rdzenie i przelatuje tysiące tokenów na sekundę. Druga jest ściśle sekwencyjna, obciąża pamięć i...
Pamięć jako sufit — dlaczego kontekst kończy się szybciej niż cierpliwość
Wagi to nie wszystko, co model trzyma w pamięci. Obok nich rośnie druga struktura, która przy pierwszym tokenie zajmuje tyle co nic, a przy długiej rozmowie potrafi przekroczyć rozmiar samego modelu. I to ona, nie wagi, najczęściej decyduje o tym, gdzie kończy się...
Kwantyzacja, którą widać — co tracisz schodząc do czterech bitów
Model w czterech bitach nie jest „trochę gorszy". Jest dokładnie tak samo dobry w dziewięciu sytuacjach na dziesięć i wyraźnie gorszy w tej dziesiątej. Cała trudność polega na tym, że to nie jest przypadkowa dziesiąta. Da się z góry powiedzieć, gdzie strata się...
Od wag do odpowiedzi — co runtime robi z plikiem modelu
Model nie jest uruchamiany. Model jest kompilowany. Między wczytaniem pliku a pierwszym tokenem dzieje się praca, o której nie mówi ani nazwa modelu, ani jego rozmiar — a która potrafi zmienić prędkość dwudziestokrotnie. To dlatego ten sam model u dwóch różnych...