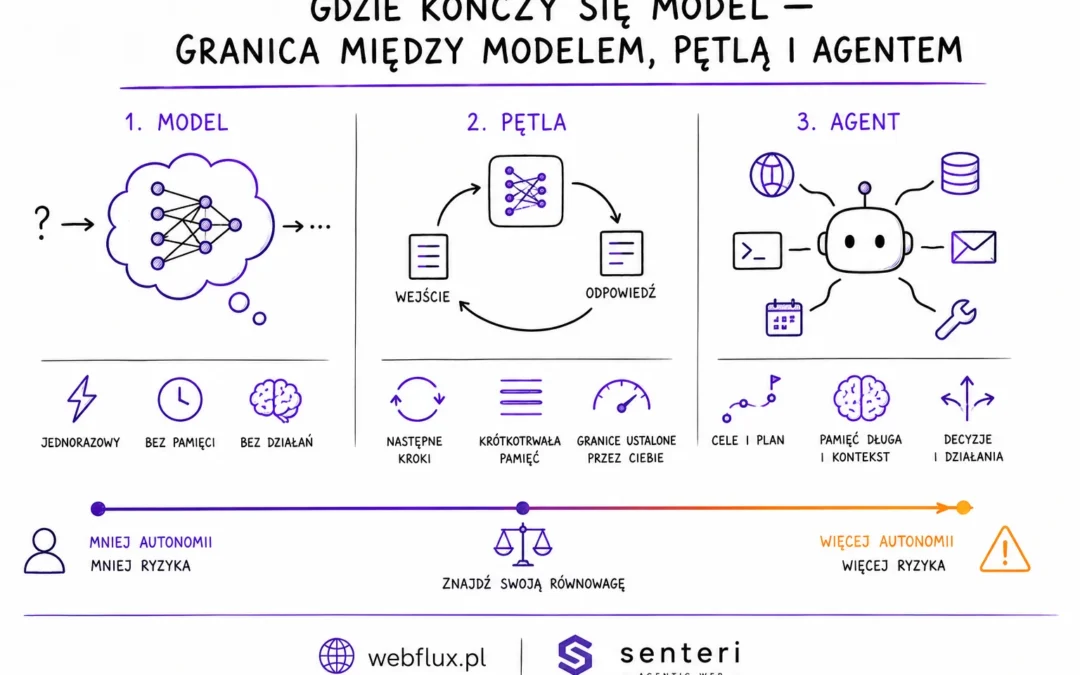
Gdzie kończy się model — granica między modelem, pętlą i agentem
Przeszliśmy przez cały model: tokeny, znaczenie, uwagę, trening, generowanie, koszt, rozmiar, rozumowanie. Został ostatni krok, który jest zarazem najważniejszy praktycznie. Nie „co model robi”, tylko czego nie robi — i gdzie dokładnie przebiega linia, za którą...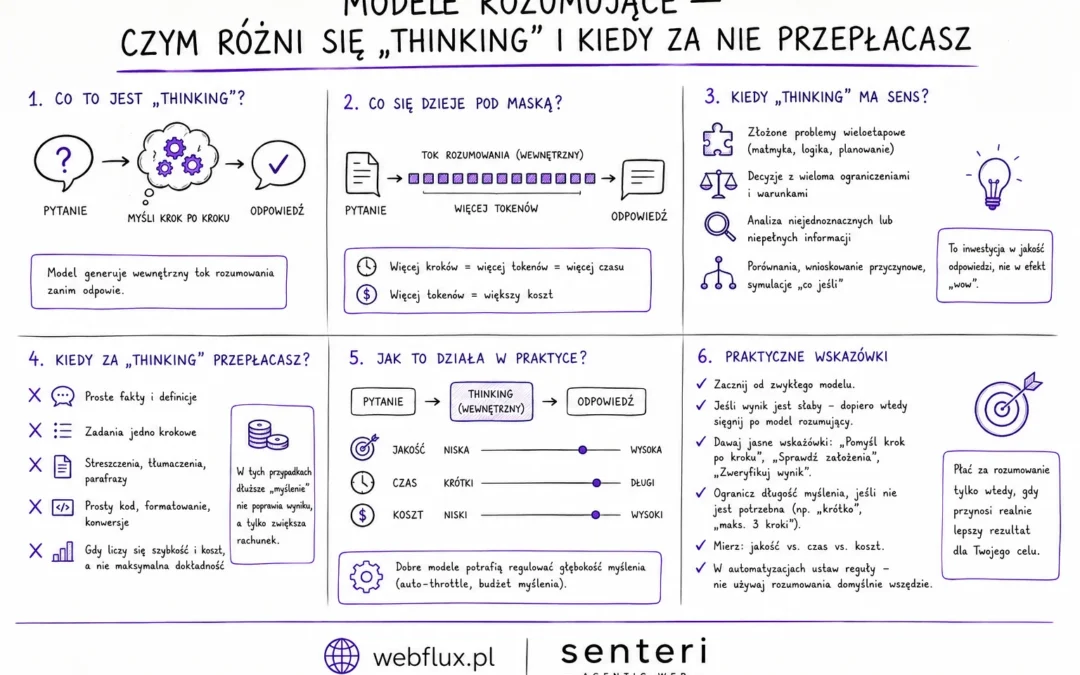
Modele rozumujące — czym różni się „thinking” i kiedy za nie przepłacasz
To samo pytanie, dwa modele. Pierwszy odpowiada po sekundzie. Drugi milczy pół minuty, wypisuje komunikat o myśleniu, a potem odpowiada — i na rachunku widnieje wielokrotność tego, co kosztował pierwszy. Za tę różnicę czasem warto zapłacić dziesięciokrotnie. Czasem...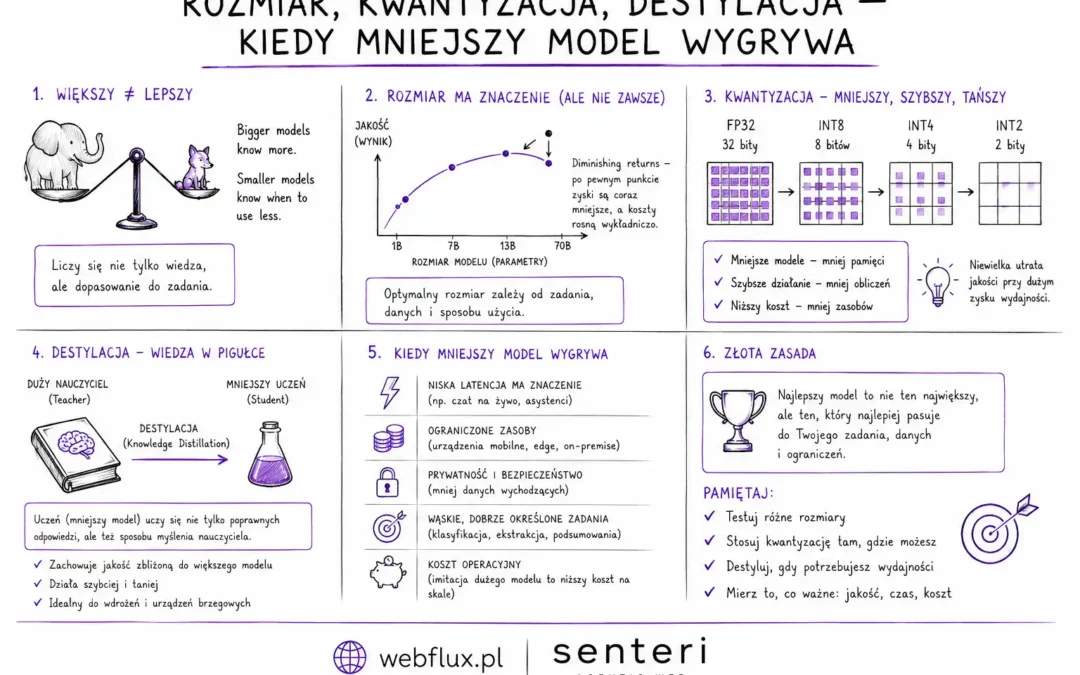
Rozmiar, kwantyzacja, destylacja — kiedy mniejszy model wygrywa
Domyślna decyzja przy większości wdrożeń brzmi: bierzemy największy dostępny model, bo będzie najlepszy. Rzadko kiedy jest to decyzja — częściej brak decyzji. Bywa słuszna. Ale przy zadaniach, które w praktyce stanowią większość ruchu w produkcji — klasyfikacja,...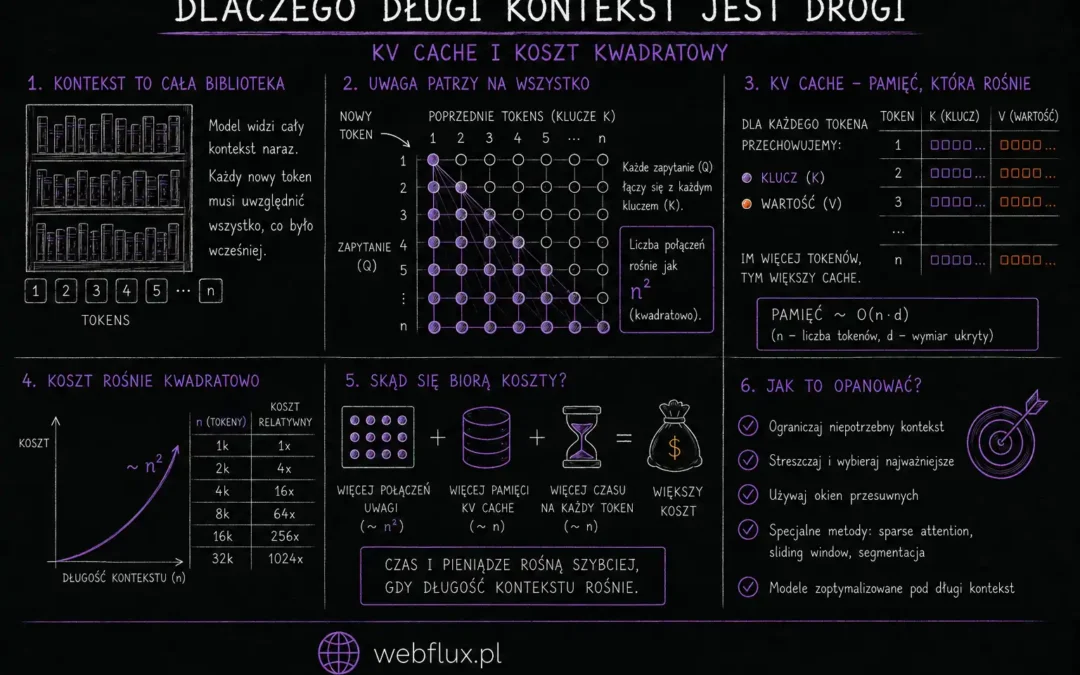
Dlaczego długi kontekst jest drogi — KV cache i koszt kwadratowy
W artykule o inference padło zdanie, że każdy kolejny token wymaga osobnego przejścia przez cały model. Brzmi to jak katastrofa obliczeniowa — i byłoby nią, gdyby przy każdym kroku model liczył wszystko od nowa. Nie liczy. To jest miejsce na sprostowanie uproszczenia,...