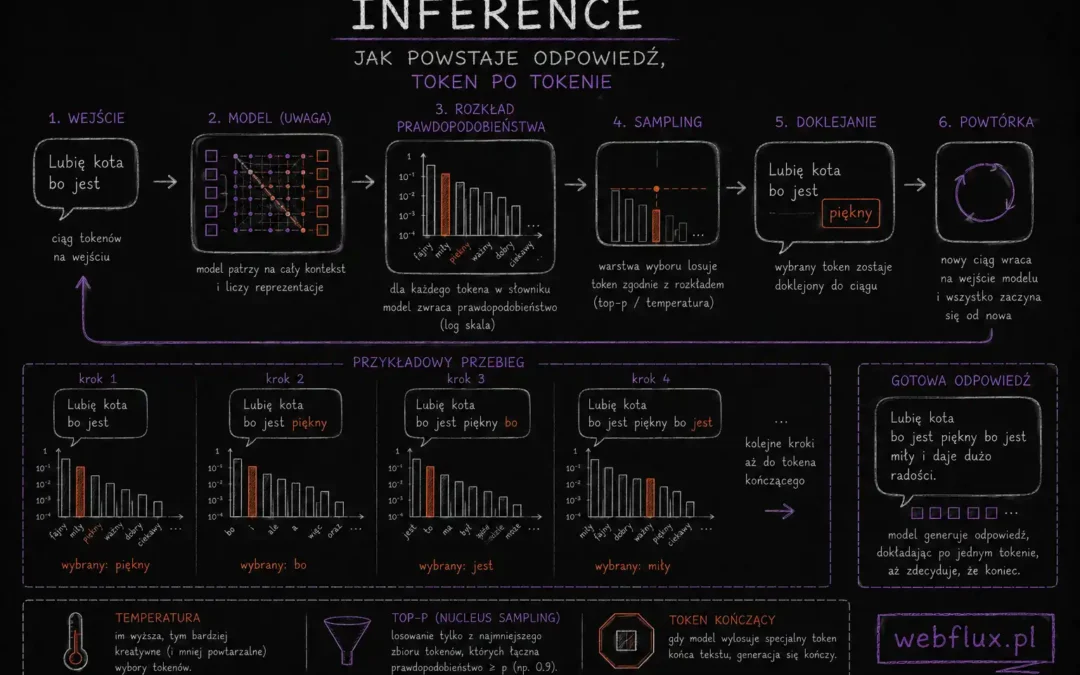
Inference — jak powstaje odpowiedź, token po tokenie
W pierwszym artykule kod z aneksu pokazywał rozkład prawdopodobieństwa: pięciu kandydatów na jeden token, każdy ze swoją liczbą. Zostawiliśmy go tam bez ciągu dalszego. Teraz pytanie, które się wtedy nasuwało: skoro model zwraca rozkład, to kto właściwie wybiera jedno...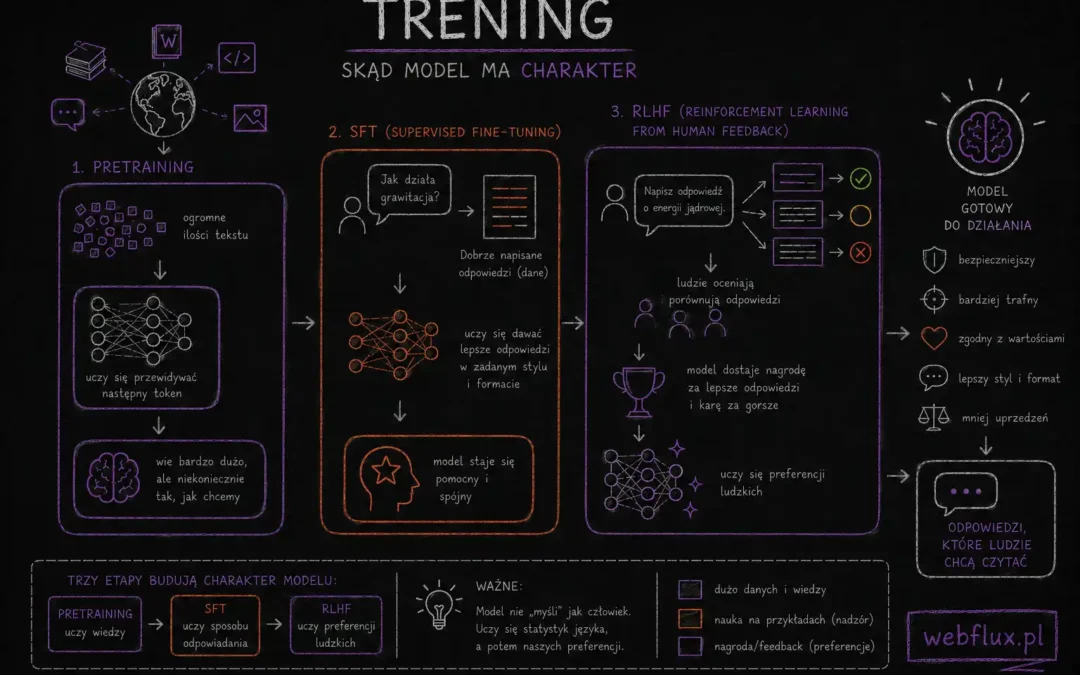
Trening — skąd model ma charakter: pretraining, SFT, RLHF
Weź dwa modele o zbliżonej liczbie parametrów, od dwóch różnych dostawców. Zadaj im to samo pytanie. Jeden odpowie w trzech zdaniach, drugi w trzech akapitach. Jeden odmówi, drugi nie. Jeden zacznie od zastrzeżeń, drugi od konkretu. Różnica prawie nigdy nie leży w...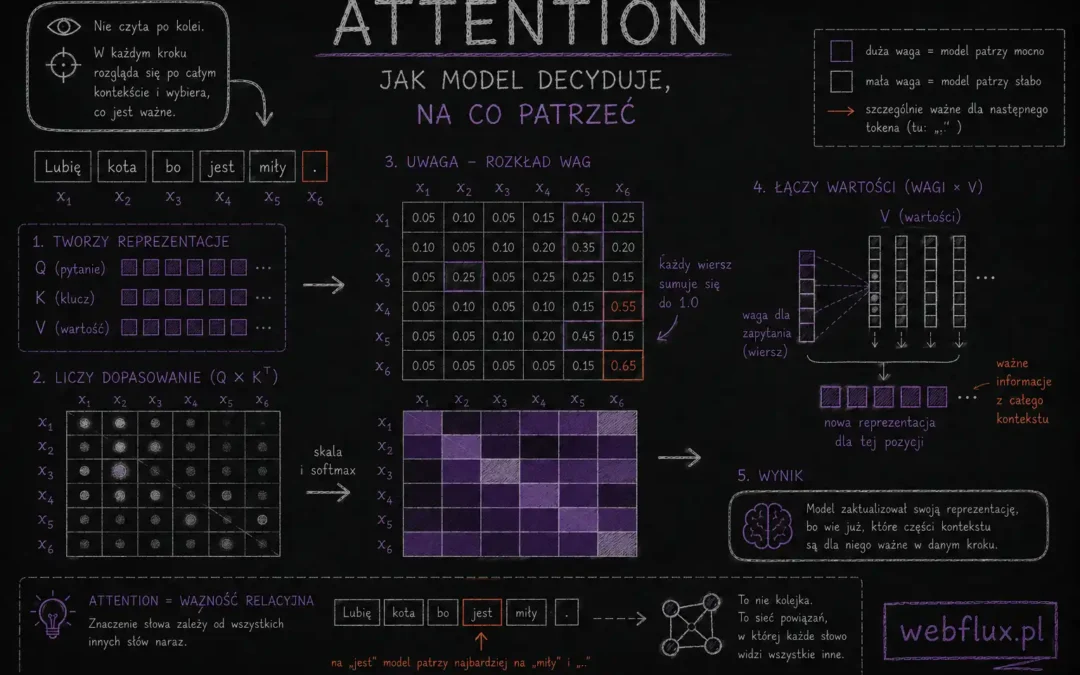
Attention — jak model decyduje, na co patrzeć
„Zamek był zardzewiały.” Przeczytałeś to i już wiesz, że nie chodzi o budowlę. Wiesz dzięki jednemu słowu, które stoi obok. Gdyby zamiast „zardzewiały” było „otoczony fosą”, to samo słowo znaczyłoby coś zupełnie innego. W poprzednim artykule...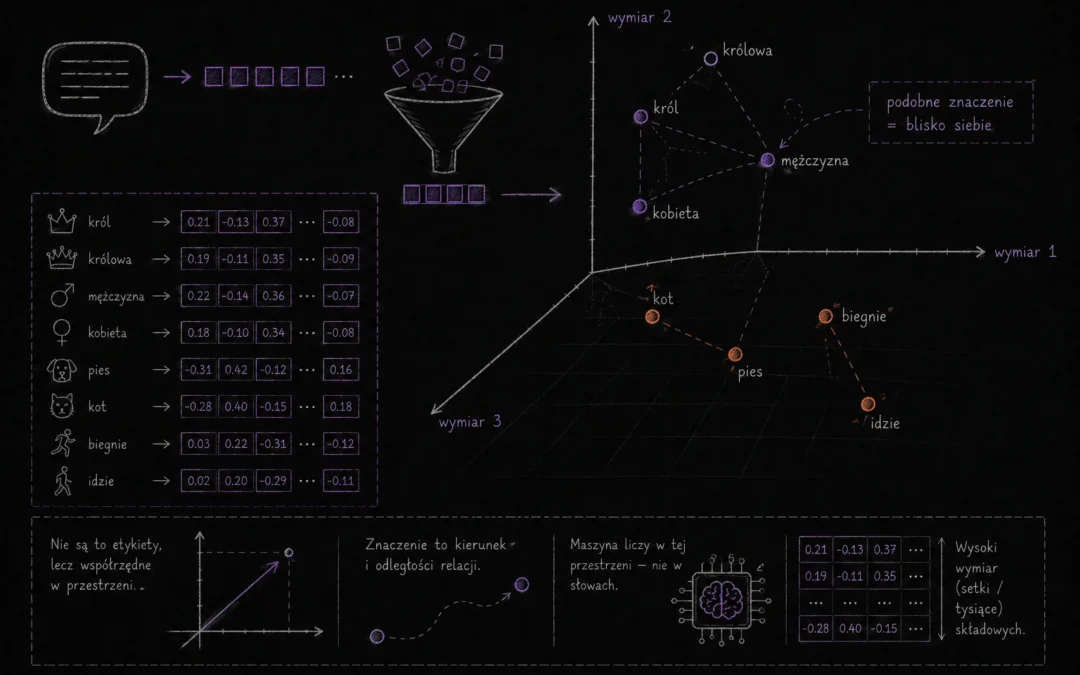
Embeddingi — czym jest znaczenie dla maszyny
Wpisz w dowolną wyszukiwarkę semantyczną „auto”, a znajdzie ci dokumenty o samochodach. Nie dlatego, że ktoś ręcznie wpisał synonimy. Te dwa słowa nie mają wspólnego rdzenia, nie mają wspólnej odmiany, a mimo to maszyna traktuje je jako bliskie. To jest jedyne...