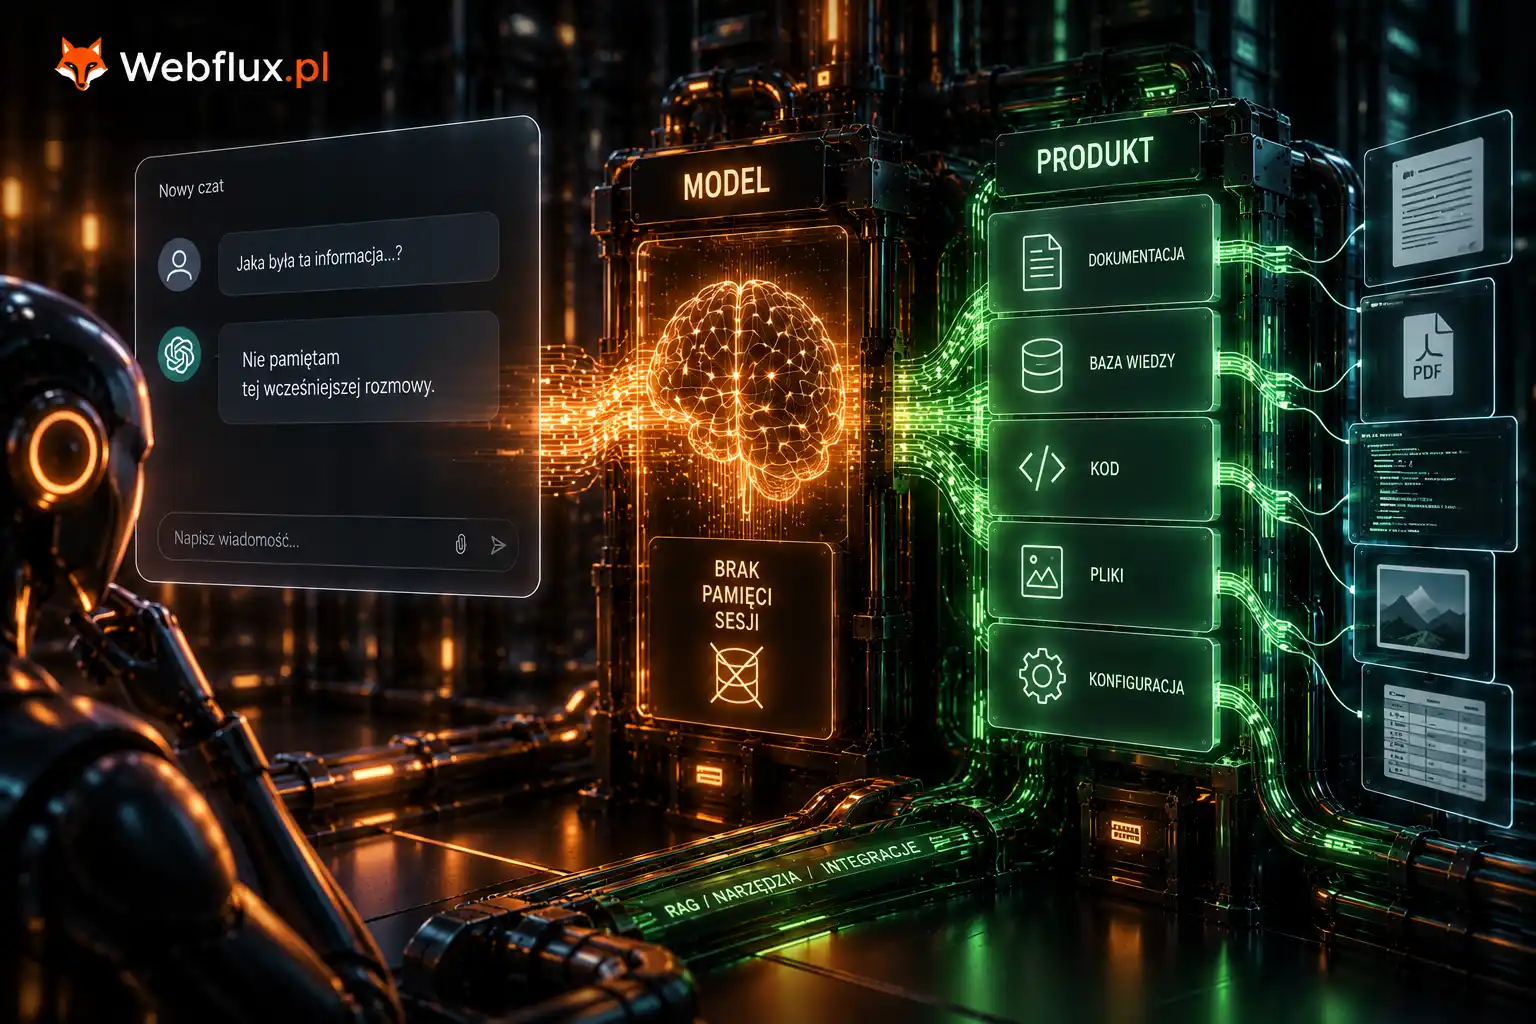
Model nie pamięta ani jednego słowa z waszej poprzedniej wymiany. Wagi są zamrożone, między turami nie zapisuje się nic, a wrażenie ciągłości powstaje przez mechanizm tak prosty, że po jego poznaniu przestaje dziwić połowa rzeczy z tej serii — łącznie z rachunkiem za API.
To jest najczęstsze nieporozumienie w kontakcie zwykłych ludzi z AI i jednocześnie najlepszy dowód tezy, od której zaczęliśmy: te same wagi, trzy maszynerie, prawie wszystko robi maszyneria.
Jak to naprawdę działa
Piszesz pierwsze zdanie. Produkt składa kontekst, wysyła, dostaje odpowiedź, wyświetla.
Piszesz drugie. Produkt składa kontekst od nowa — i tym razem wkleja do niego całą poprzednią wymianę jako tekst: twoje pierwsze zdanie, odpowiedź modelu, twoje drugie zdanie. Wysyła całość. Model czyta to jak jeden dokument i przewiduje, co powinno paść dalej.
Piszesz trzecie. To samo, tylko dokument jest dłuższy.
Nie ma żadnego stanu. Nie ma sesji po stronie modelu, nie ma niczego zapisanego między turami. Jest tekst, który za każdym razem przychodzi w całości, jakby model widział go pierwszy raz w życiu — bo widzi.
To jak rozmowa z kimś, kto po każdym zdaniu traci pamięć, ale dostaje kompletny stenogram całej rozmowy i czyta go od początku, zanim odpowie. Z zewnątrz wygląda to jak pamięć. Od środka jest czytaniem.
Dlaczego wagi nie mogą pamiętać
Warto powiedzieć, dlaczego nie da się tego zrobić inaczej — bo to nie jest brak funkcji, tylko własność architektury.
Wagi są zamrożone po treningu. To ten sam plik dla wszystkich użytkowników jednocześnie, czytany przy każdym tokenie, współdzielony przez dwieście rozmów w jednej partii. Gdyby model zapisywał w nich cokolwiek z twojej rozmowy, zapisywałby to w pliku, z którego w tej samej sekundzie korzysta ktoś inny.
Pamięć podręczna kontekstu, o której był czwarty artykuł, też nie jest pamięcią w tym sensie. Jest cache’em obliczeń dla jednej sesji, kasowanym zaraz po odpowiedzi, bo zajmuje miejsce potrzebne komu innemu.
Jedynym miejscem, gdzie cokolwiek może przetrwać między turami, jest tekst wysyłany od nowa.
Co z tego wynika
Ta jedna rzecz tłumaczy zaskakująco wiele.
Dlaczego długa rozmowa jest droga. Każda tura wysyła całą historię od nowa. Dwudziesta wiadomość w rozmowie kosztuje dwadzieścia razy więcej niż pierwsza, choć napisałeś tyle samo słów. W API widzisz to na fakturze, w czacie nie widzisz tego wcale — ale mechanizm jest identyczny.
Dlaczego rozmowa zwalnia. Cała historia musi przejść przez prefill, zanim padnie pierwsze słowo odpowiedzi. Im dłuższa rozmowa, tym dłuższa cisza po naciśnięciu przycisku.
Dlaczego rozmowa się kończy. Okno kontekstu jest skończone. Kiedy historia przestaje się mieścić, produkt musi coś z nią zrobić — najczęściej streścić starszą część albo ją odciąć. To nie jest kasowanie twoich danych ani złośliwość. To jedyne wyjście.
Dlaczego model gubi wcześniejsze instrukcje. Nadal je widzi, tylko konkurują o uwagę z czterdziestoma tysiącami tokenów, które przyszły po nich.
Dlaczego nowa rozmowa naprawia dziwne zachowania. Bo usuwa kontekst, nie dlatego, że model się zrestartował.
Czym jest „pamięć” w produktach
Skoro model nie pamięta, to co robią funkcje nazywane pamięcią?
Zapisują tekst i wklejają go później. To wszystko — i to naprawdę jest wszystko.
Produkt wyciąga z rozmowy fragmenty, które uzna za warte zapamiętania, trzyma je w swojej bazie i przy kolejnych rozmowach dokłada do kontekstu jako kolejną warstwę stosu z poprzedniego artykułu. Model dostaje je jako zwykły tekst, nieodróżnialny od twojego zdania.
To ma dwie konsekwencje, które warto znać.
Po pierwsze, pamięć produktu można przeczytać. Skoro to tekst w bazie, a nie coś wtopionego w wagi, da się go wyświetlić, poprawić i skasować. Produkty zwykle na to pozwalają i warto tam zajrzeć.
Po drugie, pamięć zajmuje kontekst. Każda zapamiętana rzecz to tokeny doklejane do każdej rozmowy — kosztują i konkurują o uwagę z tym, co piszesz teraz.
Ile z tego to model
Doszliśmy do końca i można zrobić bilans, od którego ta seria się zaczęła.
Przeszliśmy przez trzy maszynerie wokół jednego pliku z liczbami.
Na twoim urządzeniu zobaczyliśmy, że wagi trzeba przeczytać przy każdym tokenie, że kwantyzacja przyspiesza przez zmniejszenie liczby bajtów, że historia rozmowy potrafi przerosnąć model i że generowanie marnuje kartę niemal w całości. Wszystko widoczne, wszystko dające się policzyć.
Za API ten sam mechanizm stał się niewidzialny i wyrósł z niego cały porządek ekonomiczny: kolejki, partie, limity liczone w tokenach, dwie kolumny w cenniku i cache, który potrafi ściąć rachunek kilkukrotnie.
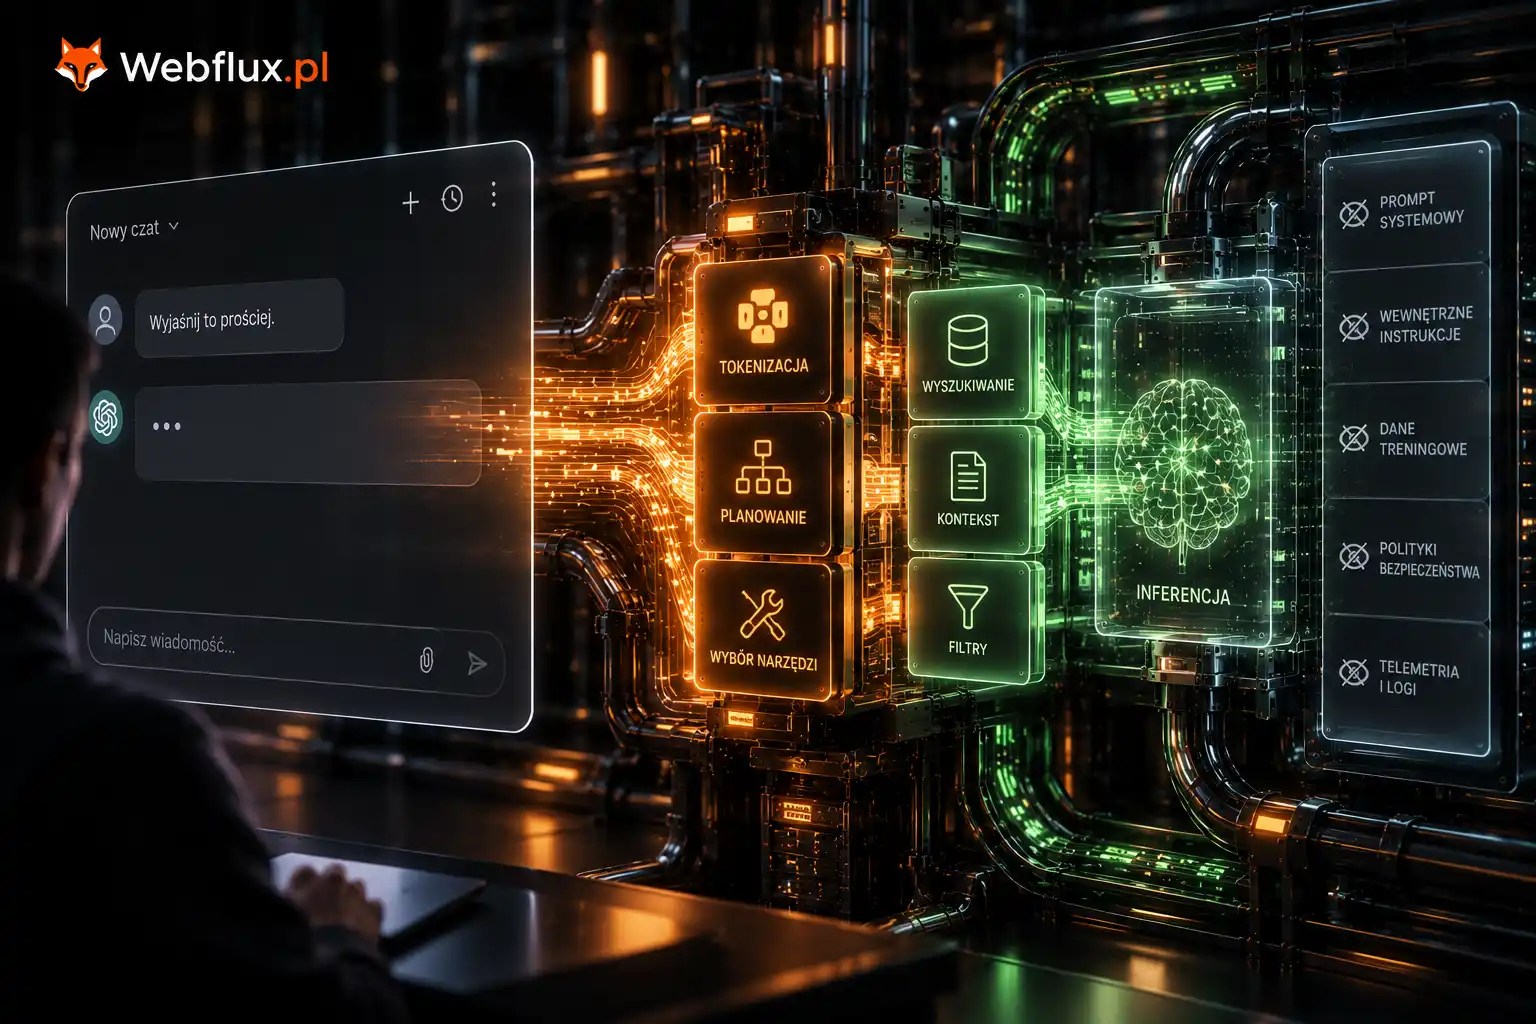
W oknie czatu nad tym wszystkim stanął produkt z własną instrukcją, własnymi narzędziami i własną pamięcią, a twoje zdanie zeszło do ułamka procenta tego, co model faktycznie czyta.
I teraz odpowiedź na pytanie z leadu.
Model odpowiada za jakość — za to, czy odpowiedź jest trafna, czy rozumowanie się trzyma, czy fakty są prawdziwe. To jest jego jedyny wkład i jest ogromny.
Wszystko pozostałe robi maszyneria. Ile czekasz. Ile płacisz. Gdzie kończy się kontekst. Czy pamięta poprzednią turę. Czy odmówi. Czy poszuka w internecie. Jak szybko pisze. Czy dziś działa wolniej niż wczoraj.
Prawie nic z tego, co nazywamy zachowaniem modelu, nie jest zachowaniem modelu.
Po co to wiedzieć
Nie po to, żeby uruchamiać modele u siebie — większość ludzi nigdy tego nie zrobi i nie musi.
Po to, żeby kierować pretensje pod właściwy adres. Optymalizować to, co da się optymalizować. Czytać cennik jako opis fizyki, a nie polityki. Nie szukać w prompcie rozwiązania problemu, który leży w kolejce. Nie oczekiwać od modelu pamięci, której architektonicznie mieć nie może. I nie dziwić się, że ta sama nazwa modelu u dwóch dostawców daje dwa różne produkty.
Tyle wystarczy. Reszta to szczegóły, które można doczytać, kiedy będą potrzebne.
Anatomia LLM schodziła pod agenta. Ta seria zeszła pod model. Niżej jest już tylko krzem.
Anatomia LLM schodziła pod agenta. Ta seria zeszła pod model. Niżej jest już tylko krzem.