Objawy
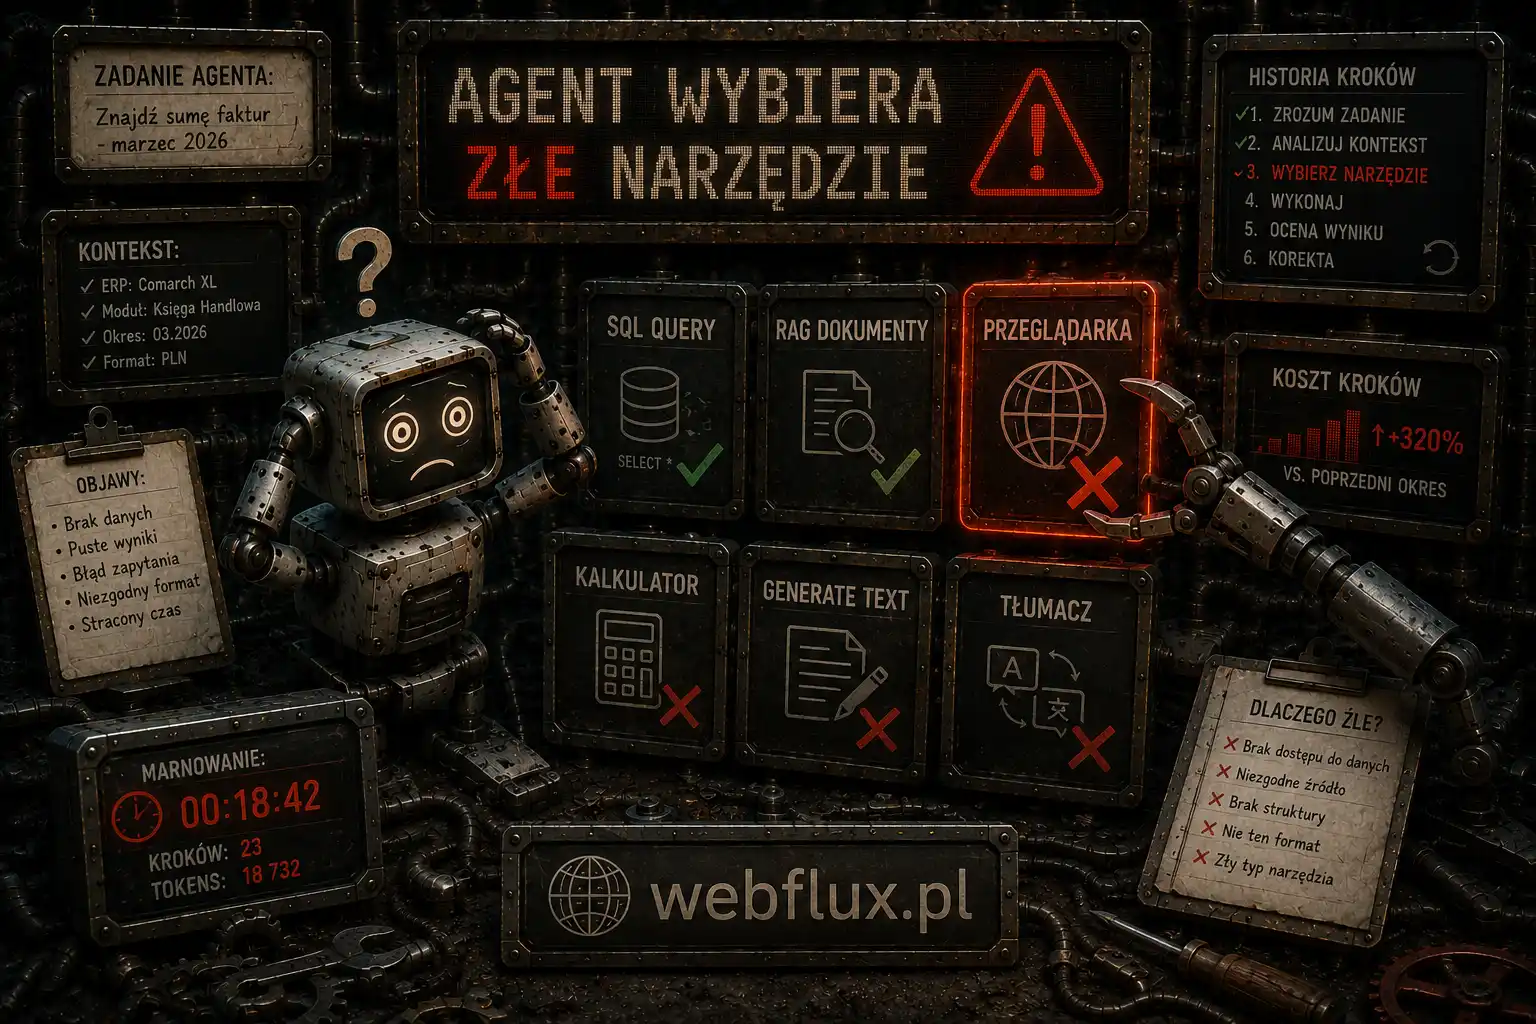
Agent odpowiada nie na to pytanie. Pobiera listę zamówień, gdy pytano o jedno konkretne. Odpowiada z pamięci, choć miał sprawdzić w bazie. Albo sięga po właściwe narzędzie i wpisuje w argumenty coś, czego nie da się użyć.
Sygnał, który odróżnia ten syndrom od losowego szumu: mylą się te same przypadki. Nie co dwudziesty losowy, tylko konkretne sformułowania, konsekwentnie, przy każdym przebiegu.
Drugi sygnał: trafność spadła po tym, jak ktoś dodał narzędzia — również te niezwiązane z mylonymi.
Najpierw ustal, która to awaria
To są trzy różne rzeczy, mylone ze sobą i wymagające innych napraw. Zanim pójdziesz dalej, sprawdź w śladzie, która występuje.
A — nie wybrał żadnego narzędzia. Model odpowiedział z siebie, mimo że powinien sprawdzić. W śladzie nie ma wywołania.
B — wybrał niewłaściwe narzędzie. Wywołanie jest, narzędzie nie to.
C — wybrał właściwe, źle wypełnił argumenty. Narzędzie się zgadza, wartości nie.
Każda ma inny zestaw przyczyn i inną naprawę. Mieszanie ich to najczęstszy powód, dla którego „poprawiliśmy opisy i nic to nie dało”.
Mechanizm w trzech zdaniach
Model nie widzi twojego kodu — widzi wyłącznie definicję narzędzia: nazwę, opis i schemat parametrów. Wybór jest zwykłą predykcją opartą na tym tekście, a nie metodycznym przeglądem listy.
Model waży wszystkie opisy naraz, więc opisy podobne realnie ze sobą konkurują — i to jest źródło większości pomyłek.
Diagnostyka różnicowa
Dla awarii A — brak wywołania
A1. Narzędzia nie ma w katalogu w tym kroku. Najbardziej banalna przyczyna i zaskakująco częsta przy ładowaniu warunkowym. Sprawdź, co realnie poszło do modelu w tym obrocie, a nie co jest zdefiniowane w kodzie.
A2. Model zna odpowiedź z treningu. Pytanie o coś ogólnego — stawki VAT, definicję, format daty — nie wygląda dla modelu na wymagające sprawdzenia. Rozpoznanie: odpowiedź jest merytorycznie sensowna, tylko nieoparta na twoich danych.
A3. Nic nie mówi, że ma używać narzędzi. Prompt systemowy opisuje rolę, ale nie zawiera zdania „przy pytaniach o dane klienta zawsze sprawdź w systemie”. Model nie zakłada tego sam.
Dla awarii B — złe narzędzie
B1. Opisy konkurują. Dwa narzędzia z tego samego obszaru, oba opisane wyłącznie przez to, co robią, żadne przez to, kiedy go nie używać. Najczęstsza przyczyna w całym syndromie.
Test: przeczytaj oba opisy, udając, że nie znasz systemu. Czy da się jednoznacznie rozstrzygnąć mylony przypadek? Jeśli wahasz się ty, model też.
B2. Nazwa odzwierciedla strukturę kodu. get_data, crm_query, api_v2 — nazwa niesie najwięcej informacji i jest widziana pierwsza. Jeśli nie mówi, co narzędzie robi z punktu widzenia zadania, opis musi nadrabiać.
B3. Przeciążenie katalogu. Trafność spada wraz z liczbą narzędzi, najmocniej przy pokrewnych. Rozpoznanie jest łatwe: zmierz trafność na tym samym zestawie zapytań przy pełnym katalogu i przy dwóch narzędziach docelowych. Jeśli różnica jest duża, to przeciążenie, nie opisy.
B4. Kontekst z poprzednich kroków ciągnie w złą stronę. Wynik wcześniejszego narzędzia zawierał treść sugerującą inną drogę. Rozpoznanie: pomyłka pojawia się dopiero od któregoś kroku, przy pierwszym wywołaniu wybór jest poprawny.
Dla awarii C — złe argumenty
C1. Format nie jest podany w opisie pola. Model zgaduje konwencję twojego systemu. Jeśli opis brzmi „numer zamówienia” zamiast „numer zamówienia w formacie ZAM-0000″, zgadywanie jest jedyną opcją.
C2. Wartości dopuszczalne opisane prozą zamiast w schemacie. Jeśli pole przyjmuje jedną z pięciu wartości, a lista jest w opisie tekstowym, model może wpisać szóstą. W schemacie — nie może.
C3. Wartość jest zmyślona. Numer, którego nigdzie nie było, wygenerowany bo pasował do formatu. To już halucynacjaw argumencie i naprawia się ją walidacją istnienia, nie opisem.
Przecinająca wszystkie trzy
Losowość na kroku wyboru. Jeśli wywołania decydujące o narzędziu idą z wysoką temperaturą, część rozstrzygnięć wypada przypadkiem. Rozpoznanie: uruchom ten sam przypadek pięć razy. Różne wyniki przy identycznym wejściu oznaczają, że problemem jest ustawienie samplingu, a nie opis.
Postępowanie
Najpierw zbuduj zestaw testowy. Kilkanaście realnych zapytań z zapisanym oczekiwanym narzędziem. Bez tego każda poprawka jest zgadywaniem, a poprawa opisu jednego narzędzia potrafi popsuć wybór innego.
Potem, zależnie od rozpoznania: dla B1 — granice negatywne w opisach, czyli zdanie „nie używaj, gdy…, wtedy użyj X”. Dla B3 — ograniczenie katalogu. Dla C1 i C2 — formaty w opisach pól i wartości dopuszczalne w schemacie. Dla A3 — jawna reguła w prompcie systemowym. Dla C3 — walidacja istnienia przed wykonaniem.
Ustaw niską losowość na krokach wyboru narzędzia. To osobna decyzja od ustawień dla kroków piszących tekst dla człowieka i warto ją podjąć świadomie.
Nie zaczynaj od zmiany modelu. Mocniejszy model podnosi trafność o kilka punktów i maskuje przyczynę, która wróci przy pierwszym trudniejszym przypadku — a kosztuje wielokrotnie więcej niż poprawienie trzech zdań w opisie.
Profilaktyka
Zestaw zapytań uruchamiany przy każdej zmianie katalogu narzędzi i przy każdej zmianie modelu. Pomiar przed i po — nie wrażenie, że jest lepiej.
Logowanie wybranego narzędzia razem z pytaniem, żeby dało się później zbudować zestaw z realnych przypadków zamiast wymyślonych.
Jak zdiagnozować u siebie
Miernik trafności z macierzą pomyłek — pokazuje nie tylko ile, ale które narzędzie jest mylone z którym. To jest informacja, która wprost wskazuje parę opisów do poprawienia.
from collections import Counter
from openai import OpenAI

client = OpenAI()

przypadki = [
    ("Gdzie jest zamówienie ZAM-4471?",          "status_zamowienia"),
    ("Co zamawiał klient KL-0012?",              "szukaj_zamowien"),
    ("Czy ZAM-9001 wysłane?",                    "status_zamowienia"),
    ("Pokaż zamówienia klienta KL-0300.",        "szukaj_zamowien"),
    ("Klient KL-0012 pyta o zakupy.",            "szukaj_zamowien"),
    ("Sprawdź ZAM-1234.",                        "status_zamowienia"),
    ("Ile kosztuje wysyłka do Niemiec?",         "brak"),
]

def zmierz(narzedzia, powtorzenia=3, temperatura=0):
    pomylki, trafienia, razem = Counter(), 0, 0
    for pytanie, oczekiwane in przypadki:
        for _ in range(powtorzenia):
            odp = client.chat.completions.create(
                model="gpt-4o-mini",
                messages=[{"role": "user", "content": pytanie}],
                tools=narzedzia, temperature=temperatura,
            ).choices[0].message
            wybrane = odp.tool_calls[0].function.name if odp.tool_calls else "brak"
            razem += 1
            if wybrane == oczekiwane:
                trafienia += 1
            else:
                pomylki[(oczekiwane, wybrane)] += 1

    print(f"trafność: {trafienia}/{razem} ({trafienia/razem:.0%})")
    for (ocz, wyb), n in pomylki.most_common():
        etykieta = "BRAK WYWOŁANIA (awaria A)" if wyb == "brak" else f"wybrano {wyb}"
        print(f"  {n}x  oczekiwano {ocz} → {etykieta}")
Trzy powtórzenia na przypadek są tu istotne: przy jednym przebiegu nie odróżnisz błędu systematycznego od losowego. Jeśli ta sama para myli się we wszystkich trzech, to opisy. Jeśli raz na trzy — to sampling.
Wywołaj zmierz dwa razy: z pełnym katalogiem i z samymi narzędziami docelowymi. Różnica jest miarą przeciążenia. Potem raz z temperaturą podniesioną — różnica jest miarą wpływu losowości.
Ćwiczenie: dopisz do zestawu przypadek, o którym wiesz, że modelowi się myli, i sprawdź, czy macierz pokazuje go jako powtarzalną parę. Jeśli tak, masz dokładnie dwa opisy do poprawienia — i nie musisz ruszać reszty katalogu.
Powiązane
Jak pisać definicje i ile narzędzi pokazywać: Maszyneria agenta. Dlaczego wybór jest predykcją, a nie decyzją: Anatomia LLM.
Następny syndrom: Działał wczoraj, dziś nie działa.