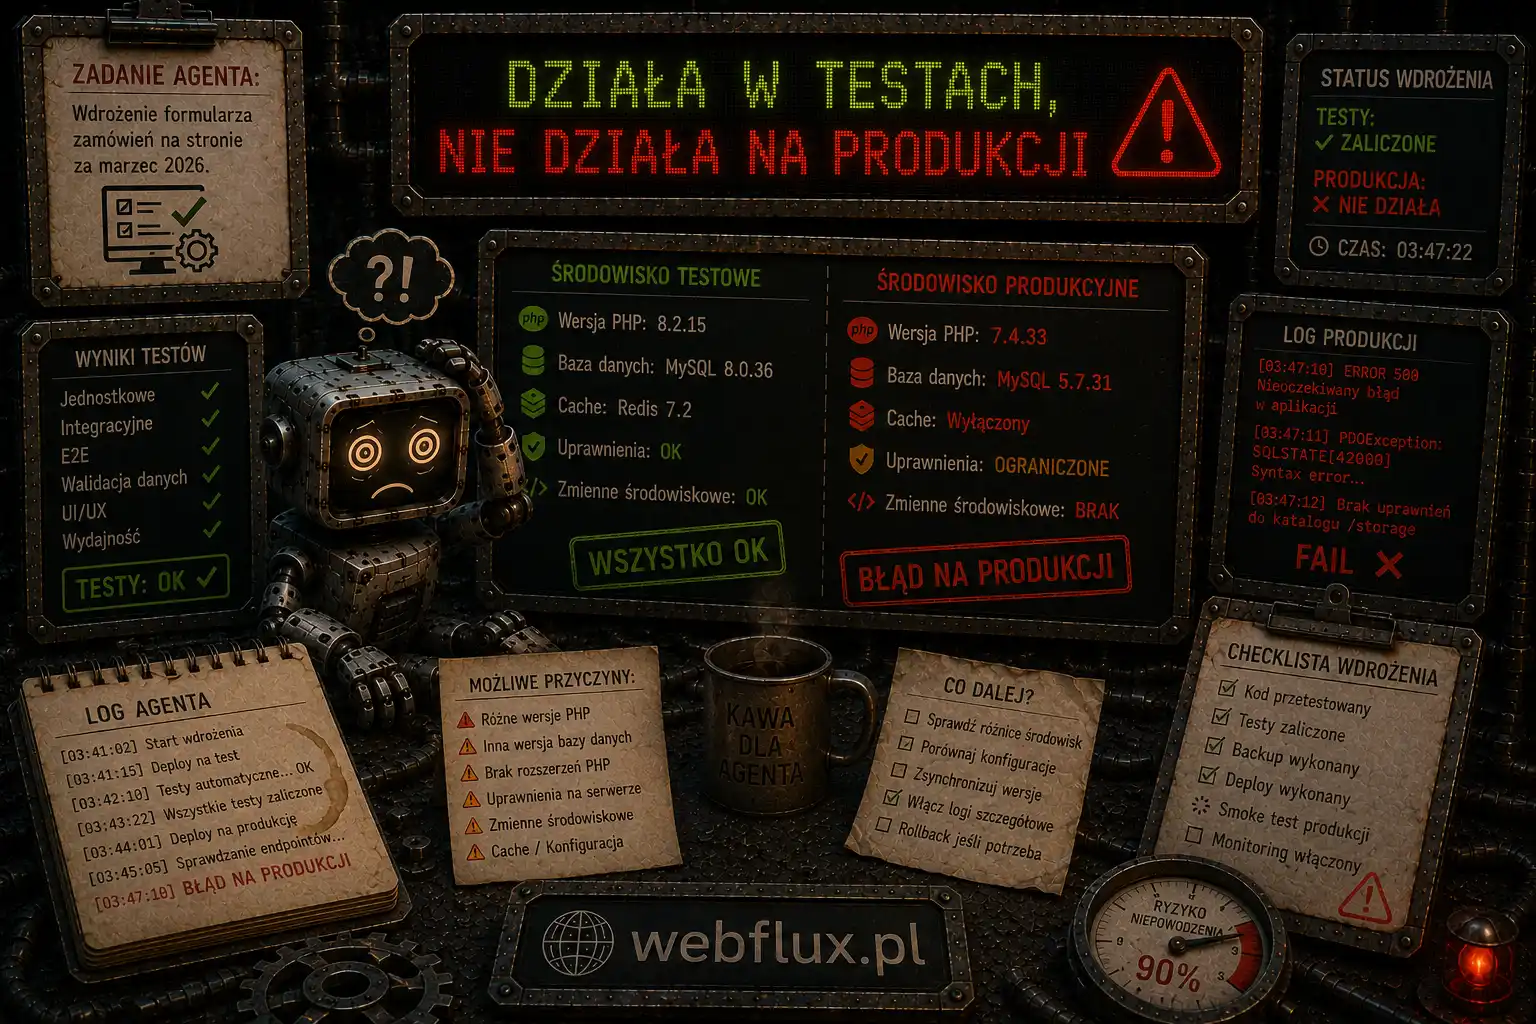
Przeszedł wszystkie testy przed wdrożeniem.
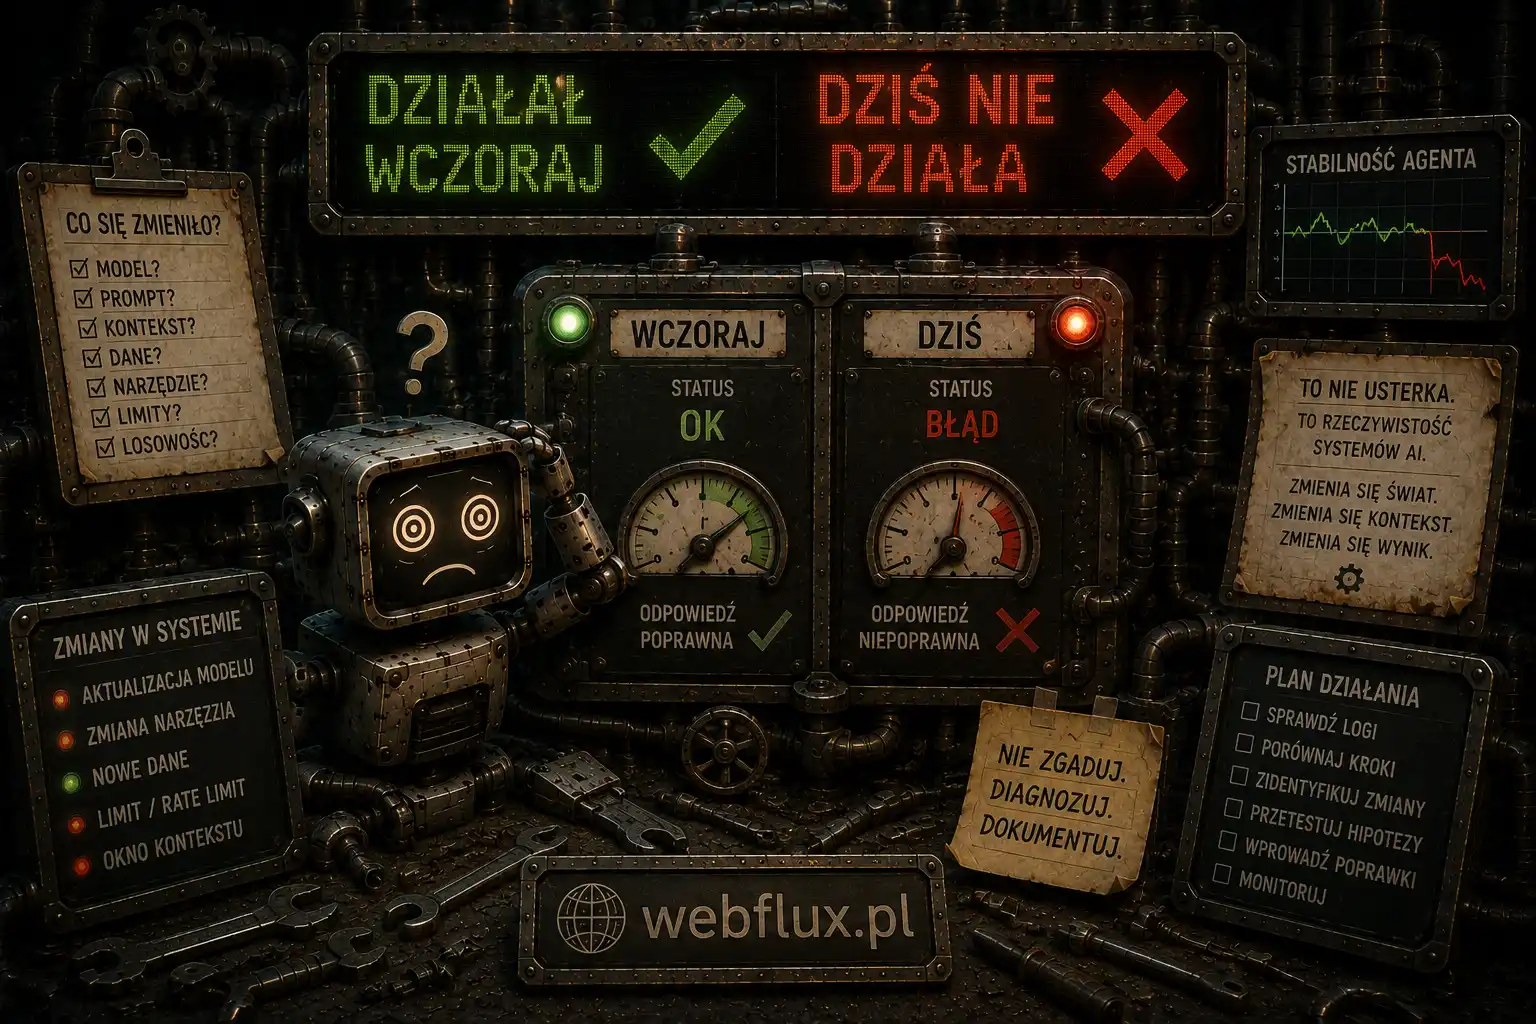
Tydzień później provider po cichu zaktualizował model. Nikt Ci o tym nie powiedział.
Artykuł 9 serii i dwa poprzednie wpisy tego wątku — ewaluacja trajektorii i ewaluacja w n8n — dotyczyły jednego momentu: przed wdrożeniem. Golden set, sędzia, quality gate. To konieczne, ale niewystarczające.
Bo agent na produkcji żyje w świecie, którego golden set nie obejmuje: pytania, których nie przewidziałeś, i zmiany, których nie wprowadziłeś. Ten wpis jest o tym drugim etapie — observability, czyli jak wiedzieć co dzieje się z agentem po wdrożeniu.
Dwa różne problemy, oba konieczne
Łatwo pomylić ewaluację z observability, bo oba dotyczą „jakości agenta”. Różnica jest czysta i warto ją trzymać:
Ewaluacja (przed deployem) odpowiada: czy ta wersja agenta jest dobra? Mierzysz na kontrolowanym golden secie, w warunkach laboratoryjnych, zanim zmiana trafi do ludzi.
Observability (po deployu) odpowiada: czy agent nadal działa dobrze teraz, na żywym ruchu? Mierzysz na rzeczywistych konwersacjach, w produkcji, ciągle.
Pierwsze chroni przed wdrożeniem złej zmiany, którą Ty wprowadziłeś. Drugie chroni przed degradacją, której niewprowadziłeś — i to jest jego unikalna wartość.
Cicha regresja — wróg, którego ewaluacja nie złapie
Najważniejszy powód, dla którego sama ewaluacja przed deployem nie wystarcza: silent regression — cicha regresja.
Twój agent stoi na modelu providera (Claude, GPT, Gemini). Ten model nie jest statyczny. Provider go aktualizuje, czasem po cichu, czasem zmieniając zachowanie w sposób, którego nie ogłasza wprost. System prompt, który działał perfekcyjnie z jedną wersją modelu, może zachowywać się inaczej z następną — to samo ryzyko, które art. 9 sygnalizował przy przejściu między wersjami modelu.
Problem z cichą regresją: nie wywołuje jej żadna Twoja zmiana. Twój kod jest ten sam. Twój prompt jest ten sam. Twój golden set z zeszłego tygodnia przeszedł. A agent nagle gorzej radzi sobie z pewną klasą pytań — bo model pod spodem jest subtelnie inny. Bez monitoringu produkcyjnego dowiesz się o tym z reklamacji, nie z dashboardu.
To dlatego observability nie jest luksusem dla dużych — jest jedynym sposobem, by złapać degradację, która nie ma związku z Twoim działaniem.
Trzy warstwy observability
Nie wszystko mierzy się tak samo. Observability agenta ma trzy warstwy, od najłatwiejszej do najtrudniejszej — i najwartościowszej.
Warstwa 1: logi techniczne. Latencja, liczba tokenów, koszt na rozmowę, błędy narzędzi, liczba kroków. To jest mierzalne zawsze i automatycznie — agent generuje te dane sam. Nagły skok latencji albo liczby kroków to pierwszy, najtańszy sygnał, że coś się zmieniło (często właśnie cicha regresja — nowy model „myśli” inaczej).
Warstwa 2: logi jakościowe. Ocena LLM-as-judge, ale tym razem na próbce rzeczywistego ruchu, nie golden setu. Bierzesz np. 10-20% produkcyjnych rozmów i przepuszczasz przez sędziego (tego samego, co w E2). Daje obraz jakości na pytaniach, których nigdy nie było w golden secie.
Warstwa 3: sygnały użytkownika. Eskalacje do człowieka, powtórzone pytania (użytkownik przeformułowuje, bo agent nie zrozumiał), porzucenia rozmowy w połowie, kciuk w dół. Najtrudniejsze do zebrania, bo wymaga instrumentacji interfejsu — ale najwartościowsze, bo to jest prawda o tym, czy agent realnie pomaga. Sędzia LLM mówi „odpowiedź spełnia kryterium”; porzucona rozmowa mówi „użytkownik się poddał”.
Sampling — nie oceniasz wszystkiego
Kluczowa decyzja w observability: nie oceniasz każdej rozmowy. Przepuszczanie 100% produkcyjnego ruchu przez sędziego LLM byłoby absurdalnie drogie — podwajasz koszt każdej rozmowy. Zamiast tego próbkujesz, i to mądrze.
Sensowna strategia łączy dwa rodzaje próbkowania:
Losowe — stały procent ruchu (np. 10%), żeby mieć reprezentatywny obraz ogólnej jakości. To Twój ciągły puls.
Celowane — 100% przypadków wysokiego ryzyka i niepewności: rozmowy, które zakończyły się eskalacją, te z niską efektywnością trajektorii (z E1), te przed nieodwracalną akcją, te w nowych kategoriach pytań. Tam, gdzie błąd kosztuje najwięcej, oceniasz wszystko.
Reguła: losowe próbkowanie mówi „jak jest średnio”, celowane mówi „gdzie jest najgorzej”. Potrzebujesz obu.
Dashboard jakości — co realnie mierzyć
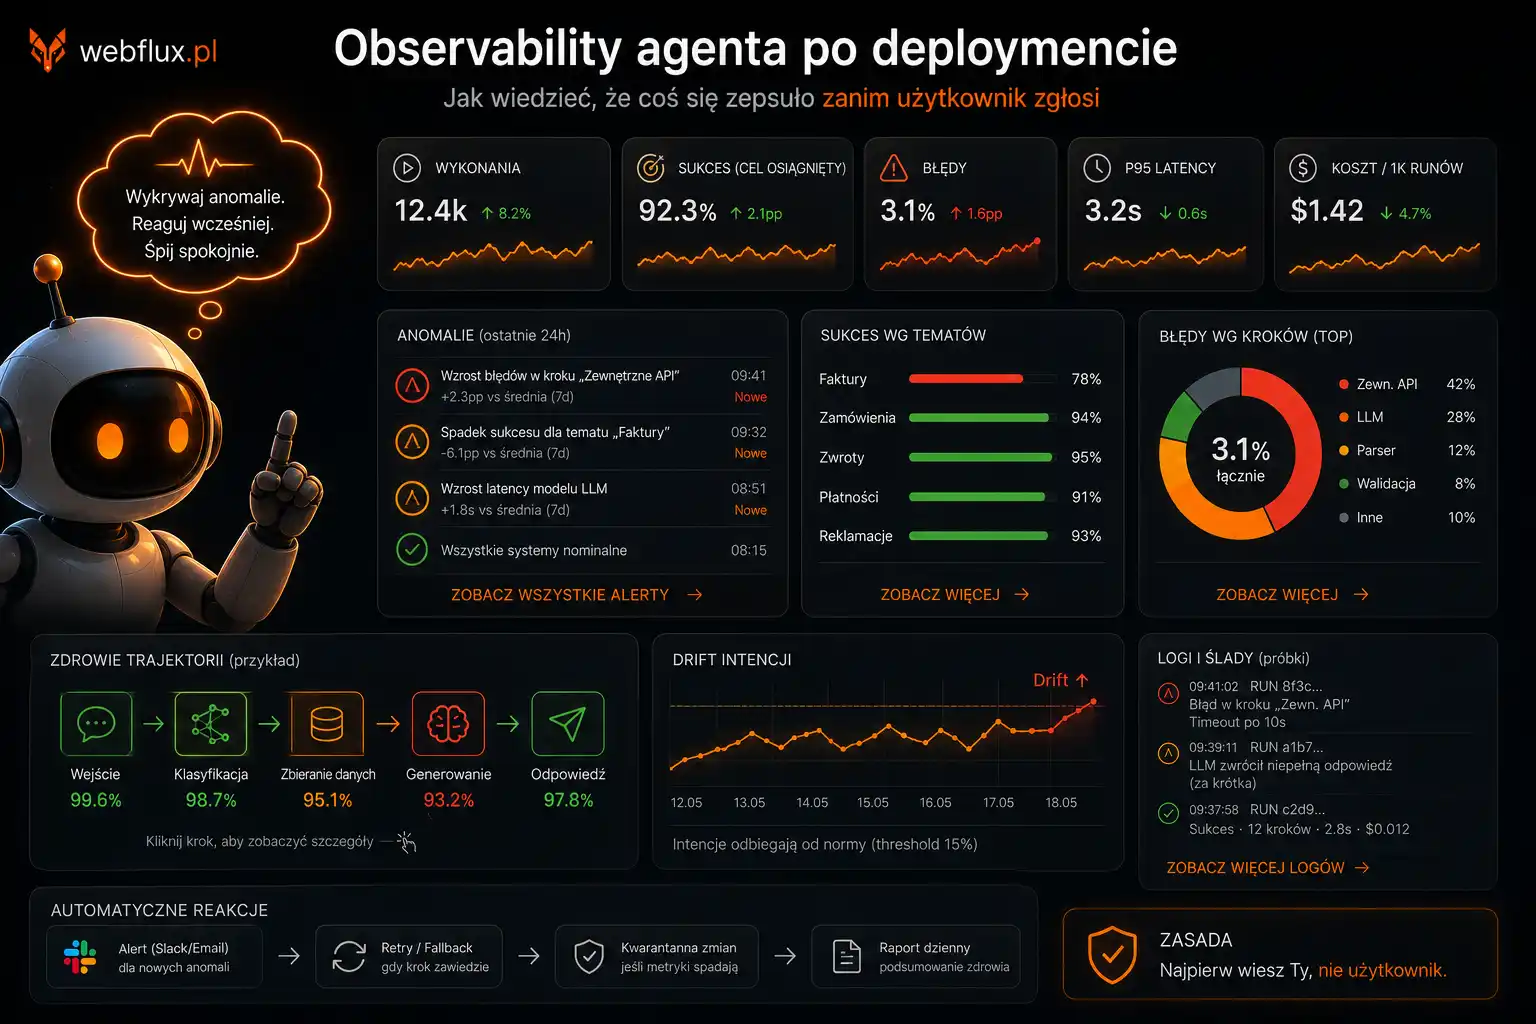
Dashboard nie musi być wymyślny. Musi odpowiadać na jedno pytanie: czy dziś jest gorzej niż wczoraj? Minimalny zestaw wskaźników:
Średni score jakości (z próbki, warstwa 2) — z podziałem na kategorie, bo regresja zwykle uderza w jedną. Latencja i koszt na rozmowę (warstwa 1) — bo skok często wyprzedza spadek jakości. Wskaźnik eskalacji (warstwa 3) — procent rozmów oddanych człowiekowi. Liczba kroków na zadanie — bo jej wzrost to wczesny sygnał cichej regresji.
Do tego progi alarmowe: jeśli którykolwiek wskaźnik przekroczy granicę (np. score spadnie o 5 punktów, eskalacje wzrosną o połowę) — dostajesz alert. To jest produkcyjny odpowiednik quality gate z art. 9: tam blokował wdrożenie, tu uruchamia dochodzenie.
Feedback loop — produkcja zasila testy
Tu domyka się cały wątek ewaluacji. Observability nie jest ślepą uliczką — każdy problem, który wykryje, wraca do ewaluacji jako nowy test.
Rozmowa, w której agent zawiódł na produkcji, staje się nowym wierszem w golden secie z E2. Eskalacja ujawnia kategorię pytań, której nie testowałeś — dodajesz ją. Cicha regresja na pewnej klasie zadań — robisz z niej test, który złapie ją następnym razem przed deployem.
To jest pętla, o której mówił art. 9, domknięta przez produkcję: golden set rośnie z każdym incydentem, którego nie przewidziałeś. Agent, który ma dobry feedback loop, z czasem ma coraz lepszy zestaw testowy — bo uczy się na własnych porażkach.
Narzędzia — mapa, nie ranking
Nie musisz budować observability od zera. Istnieje warstwa narzędzi, które to robią — i krótka mapa, żeby wiedzieć od czego zacząć:
Dla zaczynających i małej skali — często wystarczy to, co masz: logi do arkusza albo do bazy, przepływ ewaluacyjny z E2 odpalany na próbce produkcji. Zero nowych narzędzi.
Dla średniej skali — dedykowane platformy observability dla LLM (Langfuse, Arize Phoenix, MLflow) dają gotowe dashboardy, tracing trajektorii i integrację z sędziami. Langfuse jest open-source i przyjazny na start; Phoenix dobry jeśli już masz stack ML; MLflow jeśli chcesz jedną platformę na ewaluację i monitoring.
To nie jest ranking — to mapa decyzyjna. Wybór zależy od skali i tego, co już masz. Mały agent w n8n nie potrzebuje MLflow; agent obsługujący tysiące rozmów dziennie nie wystarczy arkuszem.
Most do kosztów
Jedna rzecz, którą observability daje przy okazji: widoczność kosztów. Warstwa 1 (latencja, tokeny, kroki) to dokładnie te same dane, które rozkłada wpis o tym, ile kosztuje agent w produkcji. Monitoring jakości i monitoring kosztów to ten sam strumień logów oglądany pod dwoma kątami — agent, który nagle robi więcej kroków, jednocześnie tanieje na jakości i drożeje na rachunku.
Co z tego wynika — i co domyka wątek
Ewaluacja przed deployem chroni przed złą zmianą, którą wprowadzasz. Observability po deployu chroni przed degradacją, której nie wprowadzasz — przede wszystkim przed cichą regresją modelu. Trzy warstwy (techniczna, jakościowa, sygnały użytkownika), mądre próbkowanie i feedback loop, który zwraca produkcyjne porażki do golden setu — to jest pełen obraz.
Tym domykamy wątek ewaluacji. Razem z art. 9 masz teraz komplet: jak ocenić jakość (art. 9), jak ocenić drogę a nie tylko wynik (E1), jak to zrobić bez kodu w n8n (E2) i jak nie stracić tej jakości na produkcji (ten wpis).
Zasada na koniec: agent nie jest skończony w dniu wdrożenia — jest skończony wtedy, gdy przestajesz go obserwować. A ponieważ model pod nim się zmienia bez Twojej wiedzy, ten dzień nigdy nie nadchodzi.
Pojęcia ze słownika: Agent observability · Silent regression · Sampling strategy · Agent ewaluacja · Human-in-the-loop · Golden set