Trzy dni przed Google I/O 2026 opublikowałem tutaj wpis „Twoja strona ma od teraz pierwszego czytelnika i nie jest nim człowiek”. Argument był prosty: w erze Gemini Nano w Chrome, w erze ChatGPT Search, w erze AI Overviews — twoja strona jest czytana przez model AI przed człowiekiem. Model decyduje, co człowiek z niej zobaczy, jak ją zrozumie, kiedy w ogóle do niej dotrze.
Pisałem wtedy o tekście. Pierwszy Czytelnik czyta tekst twojej strony. Nie ma oczu, nie ocenia kolorów, nie reaguje na animacje, nie słyszy podcastu w embedzie, nie ogląda twojego wideo z keynote’u.
To było 22 maja 2026.
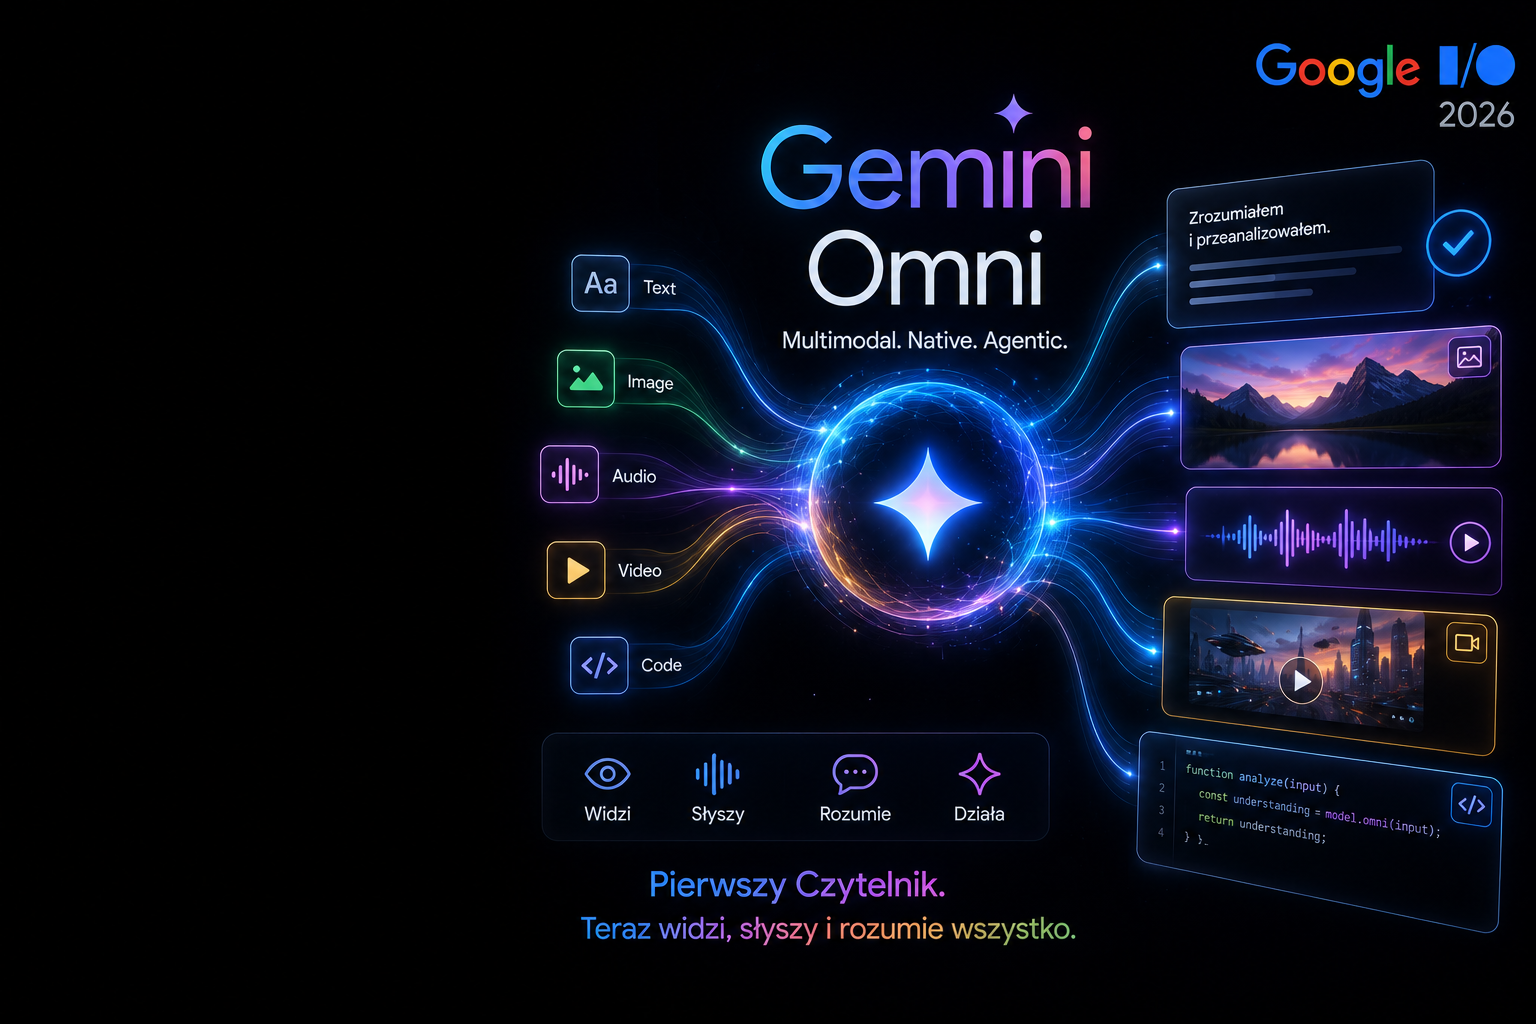
19 maja Demis Hassabis wyszedł na scenę I/O i ogłosił Gemini Omni — model, który ma być pierwszym krokiem w stronę „any input to any output”. Wideo. Audio. Obraz. Tekst. Wszystko jako input, wszystko jako output.
Pierwszy Czytelnik z trzech dni temu miał oczy zamknięte i uszy zatkane. Pierwszy Czytelnik z dnia, w którym Gemini Omni Flash trafia do produkcji — widzi i słyszy.
To zmienia wszystko co napisałem w poprzednim wpisie. Pisanie tego artykułu jest, w pewnym sensie, korektą.
Co Omni faktycznie umie
Gemini Omni Flash, pierwsza dostępna wersja serii, jest od 21 maja 2026 generally available dla subskrybentów Google AI Plus, Pro i Ultra. Pełna wersja Omni Pro planowana na drugą połowę 2026.
Kluczowe zdolności komunikowane przez Google:
- generowanie wideo z opisu tekstowego (Google Flow),
- edycja wideo poleceniami tekstowymi,
- generowanie ścieżki audio dla wideo (Google Flow Music),
- analiza obrazu z generacją opisu w dowolnym formacie,
- analiza audio (transkrypcja, klasyfikacja, opis sceny),
- generowanie obrazu z opisu tekstowego (kontynuacja Imagen 4),
- multimodal Q&A (pokaż obraz, zadaj pytanie tekstowe, dostań odpowiedź w wybranym formacie).
To co warto podkreślić: każda z tych zdolności osobno istniała wcześniej. Co Omni proponuje nowego — to symetryczna multimodalność. Jeden model przyjmuje każdy typ wejścia i generuje każdy typ wyjścia, bez przełączania architektur, bez dwóch oddzielnych pipeline’ów.
Hassabis przy ogłoszeniu określił ten kierunek jako „krok w stronę AGI”. Pozycjonowanie ambitne. Nie obciążam tego wpisu oceną tej deklaracji — interesuje mnie co Omni zmienia dla strony internetowej dziś, niezależnie od tego, gdzie nas zaprowadzi za dziesięć lat.
Pierwszy Czytelnik 2.0 — co teraz widzi
Wpis z 22 maja zawierał taką listę:
„Warstwa dla Pierwszego Czytelnika: semantyka HTML, schema.org, llms.txt, hierarchia nagłówków, jasność treści tekstowej, jasność definicji, kompletność informacji.”
To była lista dla Pierwszego Czytelnika z oczami zamkniętymi i uszami zatkanymi. Pełna lista dla Pierwszego Czytelnika z Gemini Omni jako silnikiem wygląda inaczej:
Z 22 maja (tekstowa):
- Semantyka HTML
- Schema.org dla tekstu (Article, FAQPage, HowTo)
- llms.txt
- Hierarchia nagłówków
- Jasność treści tekstowej
- Jasność definicji
- Kompletność informacji
Z 24 maja (multimodalna):
Wszystko z powyższej listy plus:
- Schema.org dla mediów — VideoObject (z polami description, transcript, embedUrl), AudioObject (z polami transcript, duration, format), ImageObject (z description, caption, contentUrl)
- Transkrypcje audio — każdy podcast, embed audio, lektor narracyjny musi mieć dostępny transkrypt
- Transkrypcje wideo — captions w SRT/VTT format, dostępne dla scrapera przez closed-caption tracks lub structured data
- Opisy semantyczne obrazów — alt text to minimum; description w schema.org ImageObject to standard
- Mikrokontekst dla obrazów decoratywnych — nawet obrazy bez merytorycznej zawartości (ozdobne) powinny być oznaczone jako takie (
alt=""w HTML, ale lepiej —role="presentation") - Spójność narracji między mediami — wideo, audio i tekst na stronie powinny mówić to samo. Sprzeczność (tekst opisuje X, wideo pokazuje Y) była wcześniej tylko UX problem; dla Omni jest danem treningowym które obniża zaufanie do strony
Cztery nowe wymiary AI-readiness po Omni
Framework ContentFox AI-Readiness Scanner (o którym pisałem dwa dni temu) mierzy stronę w sześciu warstwach. Po Omni dochodzą cztery nowe wymiary, które framework musi uwzględnić — albo go wymienić.
Wymiar 1: Media Transcription Coverage
Jaki procent treści audio/wideo na stronie ma dostępną transkrypcję? Czy transkrypcja jest w machine-readable format (VTT, SRT, embedded JSON)? Strona, na której jest pięć podcastów, dwa wideo i żaden bez transkrypcji ma Media Transcription Coverage = 0% — niezależnie jak doskonale napisana jest reszta tekstu.
Wymiar 2: Image Semantic Density
Stosunek obrazów z znaczącym alt text (>10 słów merytorycznej treści lub schema.org ImageObject z description) do wszystkich obrazów. Strona z 50 obrazami, z których 30 ma „image1.jpg” jako alt i 20 ma poprawne opisy, ma Image Semantic Density 40%. Dla Omni to oznacza że nie potrafi sensownie skomentować większości obrazów.
Wymiar 3: Cross-Media Consistency
Czy treść w różnych mediach na stronie mówi to samo? Klasyczny przypadek niedopasowania: blog post o „AI strategy” gdzie wideo embed pokazuje webinar sprzed dwóch lat o innym temacie. Tekst i wideo są sprzeczne kontekstowo. Omni to wykrywa i obniża zaufanie do strony jako źródła.
Wymiar 4: Modality-Specific Schema Coverage
Czy każdy typ medium ma odpowiednie structured data? Wideo bez VideoObject schema = Pierwszy Czytelnik wie tylko że tam jest jakieś wideo, nie wie o czym. Audio bez AudioObject = analogicznie. Image z samym alt textem (bez schema.org ImageObject) = Pierwszy Czytelnik ma podstawowy opis, brak metadanych (autor, prawa, lokalizacja, kontekst).
Implikacje per typ strony
Każdy typ strony jest pod inną presją po Omni.
Blogi z embedami wideo (większość mediów online). Średni blog newsowy embeduje 2-5 wideo na artykuł (YouTube, własne CMS, oryginalne content). Praktycznie żaden polski portal nie ma transkrypcji tych wideo. Po Omni: Pierwszy Czytelnik widzi tekst artykułu plus puste pola gdzie wideo dostarcza dodatkowy kontekst niedostępny dla niego. To pogarsza ranking AI Overviews i citation share.
Praktyczna akcja: deployment automatic transcription dla embed videos (Google Cloud Speech-to-Text, Whisper, AssemblyAI) z output jako VTT subtitles lub embedded JSON-LD VideoObject z transcript.
Strony e-commerce. Każdy produkt ma minimum 5-10 zdjęć. Większość z genericznym alt text („product photo 1”, „product photo back view”). Po Omni: Omni nie potrafi semantycznie różnicować twoich produktów na poziomie wizualnym. Konkurent z opisem schema.org ImageObject z polami description, color, material, pose — wygrywa w multi-modal search.
Praktyczna akcja: schema.org Product z embedded ImageObject dla każdego zdjęcia, opisy generowane przez sam Omni (rekurencyjna optymalizacja — używasz modelu który będzie cię czytał, do generowania metadanych dla niego).
Strony korporacyjne i instytucjonalne. Większość ma embed video powitalne CEO lub wprowadzenie do produktu. Te wideo są zwykle bez transkrypcji. Po Omni: Pierwszy Czytelnik ma niepełny obraz tego co firma robi, bo główne wprowadzenie dostarcza wideo bez tekstu.
Praktyczna akcja: każdy embed powitalny / korporacyjny dostaje transkrypcję jako element strony (nie jako downloadable PDF — jako visible HTML obok wideo). Buduje to zarówno AI-readiness, jak i a11y dla użytkowników z niepełnosprawnościami słuchowymi.
Portfolio kreatywne i agencyjne. Najgorsza sytuacja. Portfolios designerów, agencji, fotografów — w 90% są wizualne. Obrazy bez kontekstu tekstowego, wideo prezentacyjne bez transkrypcji, audio bez napisów. Z perspektywy człowieka — perfekcyjny portfolio. Z perspektywy Omni — strona praktycznie pusta.
Praktyczna akcja: case studies pisane tekstowo dla każdego projektu wizualnego. Schema.org CreativeWork z polami description, author, dateCreated. Dla portfolio fotograficznego — schema.org Photograph z keywords, location, technique.
Strony edukacyjne i naukowe. Mają zwykle dużo materiałów wideo (wykłady, demonstracje). Wcześniej polegały na fakcie że „expert reading the page” zobaczy to wideo. Po Omni: Pierwszy Czytelnik musi mieć dostęp do treści wykładu w przetwarzalnym formacie.
Praktyczna akcja: każdy wykład / demonstracja ma transcript synchronizowany czasowo (VTT), structured data Course / VideoObject z prerequisites, instructor, syllabus. To otwiera też możliwość bycia indeksowanym jako course w Google for Education.
Co robić — praktyczna sekwencja
Cztery kroki, w kolejności priorytetu, dla strony, która chce się dostosować do Pierwszego Czytelnika 2.0:
Krok 1 (najtańszy, najszybszy): audyt mediów na stronie. Wylistuj wszystkie wideo, audio, obrazy. Sprawdź ile z nich ma transkrypcję, alt text >10 słów, schema.org metadata. Wynik tej listy jest twoim baseline. ContentFox AI-Readiness Scanner nie audytuje jeszcze multi-media (na maj 2026), ale audyt można zrobić manualnie albo skryptem (każda strona po crawlu, count <video>, <audio>, <img> tags vs presence of transcripts and structured data).
Krok 2 (średni koszt): deployment auto-transkrypcji dla istniejących mediów. Google Cloud Speech-to-Text dla audio i wideo. AssemblyAI lub Whisper API jako alternatywy. Tańszy wariant: ręczna transkrypcja przez zewnętrznego freelancera dla kluczowych mediów (top 20% mediów wagi merytorycznej daje 80% wartości).
Krok 3 (większy koszt redakcyjny): schema.org dla wszystkich mediów. VideoObject, AudioObject, ImageObject. Można generować z istniejącego CMS przez plugin (WordPress: Schema App, Yoast SEO Premium częściowo). Można ręcznie dla mniejszych stron. Output jako JSON-LD w <head> lub embedded w treści.
Krok 4 (długoterminowy): redaktorska polityka multi-media. Każdy nowy artykuł / produkt / strona — z momentem dodania medium dochodzi obowiązek transkrypcji i metadanych. To wpisuje się w workflow redakcyjny obok ortografii i SEO classic.
Refleksja
Wpis z 22 maja kończył się obserwacją że web design rozdziela się na dwie warstwy — dla człowieka i dla Pierwszego Czytelnika. Dzisiejszy wpis dodaje wymiar: warstwa dla Pierwszego Czytelnika nie jest jednolita. Ma wewnętrzne sub-warstwy dla każdego typu medium.
To znaczy że narzędzia audytujące agent-readiness muszą się rozwinąć. ContentFox AI-Readiness Scanner w obecnej wersji (sześć warstw, fokus na tekst i podstawową strukturę) potrzebuje aktualizacji. Plan rozwoju ContentFox zawiera „multi-modal audit” jako planowaną funkcję — Omni właśnie zmienił priorytet tej pracy z „ważne” na „pilne”.
Strony, które do tej pory mogły radzić sobie ze „średnim AI-readiness Score” mając dobry tekst i marną resztę — teraz muszą docenić każdy z czterech wymiarów multi-media z tego wpisu. Albo, alternatywnie, pogodzić się z tym że ich citation share w erze Omni będzie poniżej możliwego.
Następny wpis w hubie Google I/O 2026 z perspektywy WebFlux: warstwa 2, Antigravity 2.0 — kiedy agent-first development staje się kategorią narzędzi.
Powiązane wpisy
W hubie Google I/O 2026:
- Google I/O 2026 — kiedy Agentic Web stała się oficjalną strategią Google (wpis flagowy huba)
Poza hubem:
- Twoja strona ma od teraz pierwszego czytelnika i nie jest nim człowiek (poprzednia iteracja paradygmatu)
- ContentFox AI-Readiness Scanner — opis narzędzia
- Przeglądarki AI w 2026 — przegląd
Słownik:
Powiązane na CyberFlux: