Czym jest ten raport
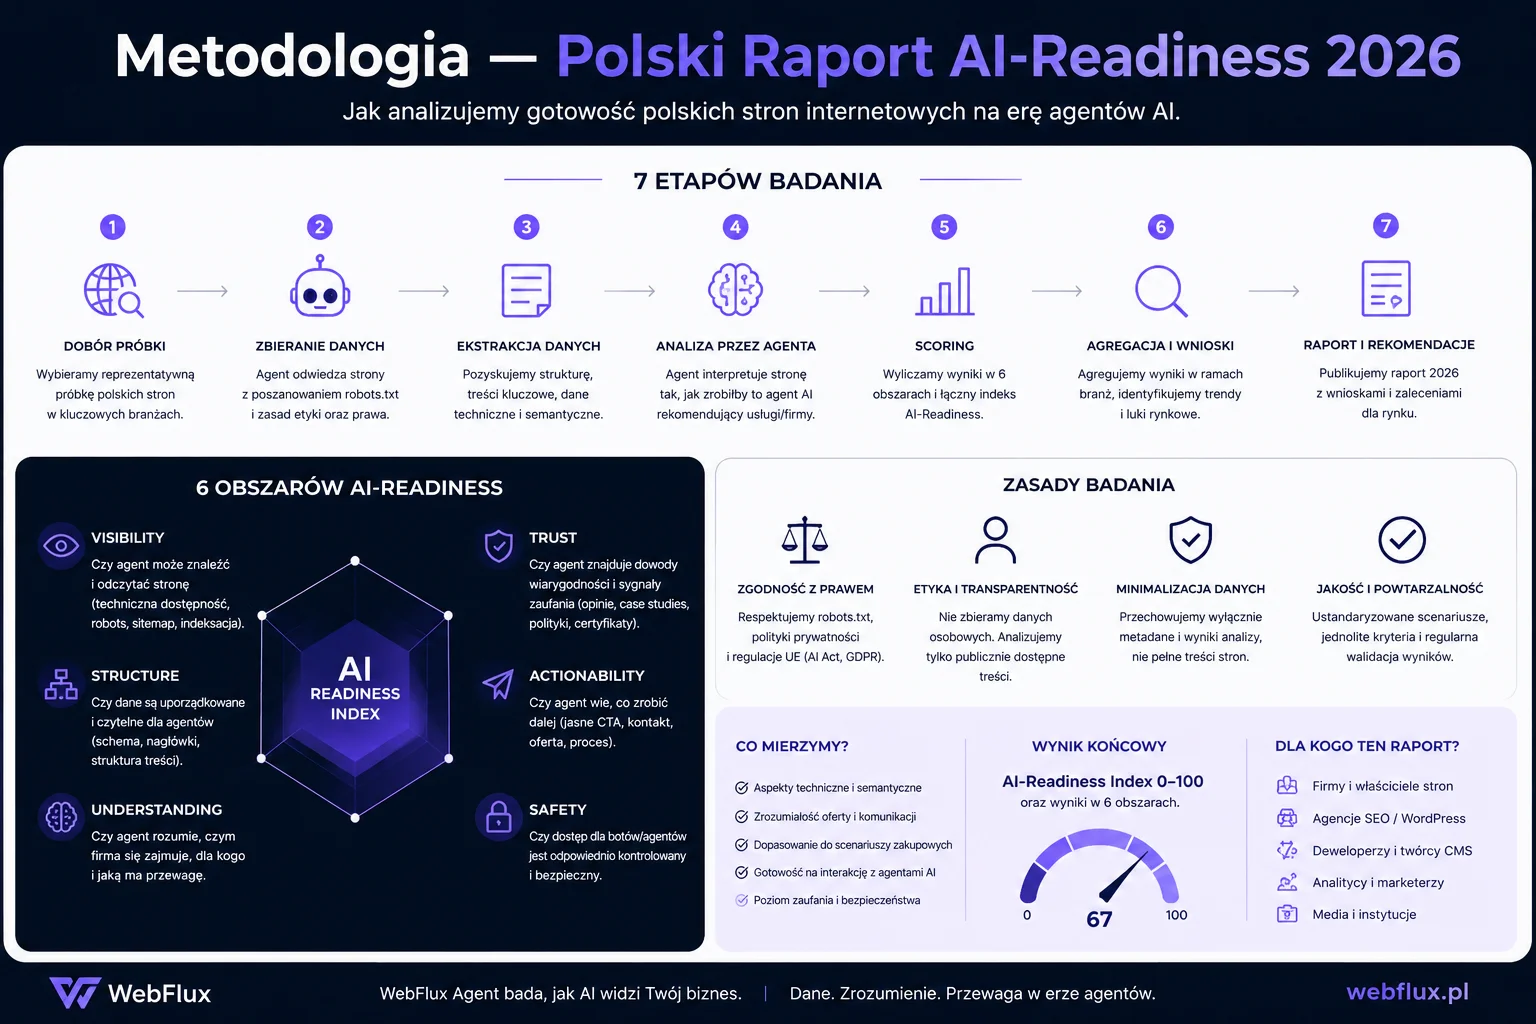
Polski Raport AI-Readiness 2026 to pierwsze systematyczne badanie gotowości polskich stron internetowych na erę agentów AI. Automatyczny agent crawlujący sprawdza próbę polskich stron branżowych pod kątem sześciu filarów agent-readiness, według kryteriów zdefiniowanych poniżej.
Raport nie ocenia jakości treści, designu ani pozycji w wyszukiwarce. Ocenia wyłącznie gotowość techniczną na to, by agent AI mógł stronę odczytać, zrozumieć i — tam gdzie to możliwe — działać w jej imieniu.
Co jest publiczne przed badaniem: kryteria oceny, system punktacji, opis próby (branże, liczba stron, zasady doboru). Co nie jest publiczne przed badaniem: lista konkretnych badanych domen. Powód: uprzednia znajomość listy zachęca do optymalizacji pod badanie zamiast pod rzeczywiste potrzeby agentów AI — co fałszuje obraz rynku.
Dobór próby — 200 stron, 4 branże (Edycja I)
Raport jest publikowany w regularnych cyklach. Każda edycja pozwala śledzić zmiany w czasie — ile stron poprawiło wyniki, które wskaźniki rosną, a które stoją w miejscu.
Zasada doboru
Próba obejmuje 200 polskich domen, podzielonych na 4 branże po 50 stron. Domeny muszą spełniać łącznie:
- Polska domena (
.pl) lub polska strona na domenie.com/.euz polskojęzyczną treścią - Działająca strona (odpowiedź HTTP 200 na stronie głównej)
- Minimum 5 podstron indeksowanych przez Google
- Aktywna działalność — ostatnia aktualizacja treści nie starsza niż 12 miesięcy
Wykluczamy: strony rządowe i samorządowe (osobna kategoria do przyszłego raportu), strony w budowie, domeny zaparkowane, serwisy wyłącznie w języku innym niż polski.
4 branże Edycji I
| Branża | Liczba stron | Źródło próby |
|---|---|---|
| E-commerce (sklepy B2C) | 50 | Ranking Gemius / własna baza |
| Agencje marketingowe i digital | 50 | Katalogi branżowe |
| Media i portale informacyjne | 50 | Ranking Similarweb PL |
| Technologia i B2B | 50 | Własna baza + katalogi |
Branże dobrane pod kątem natychmiastowych konsekwencji biznesowych agent-readiness — to są środowiska, w których agenci AI działają lub zaczną działać najwcześniej. Kolejne edycje mogą rozszerzać próbę o nowe branże.
W każdej branży próba obejmuje mix wielkości — około 30% dużych podmiotów (liderzy branży), 40% średnich, 30% mniejszych. Celem jest przekrój rynku, nie ranking największych. Konkretna lista badanych domen nie jest publikowana — patrz sekcja Etyka badania.
Co sprawdzamy — kryteria automatyczne
Agent sprawdza każdą stronę według 28 kryteriów technicznych, podzielonych na sześć filarów agent-readiness. Każde kryterium jest binarne (spełnione / niespełnione) lub stopniowalne (0/1/2 punkty).
Filar 1 — Czytelność (max 20 pkt)
Agent próbuje odczytać treść strony głównej i wybranej podstrony bez renderowania JavaScript (czysty HTML fetch).
| Kryterium | Punkty | Co sprawdzamy |
|---|---|---|
| Treść dostępna bez JS | 0-4 | Czy fetch HTML zwraca czytelną treść (>200 słów) bez potrzeby renderowania |
| Semantyczna hierarchia nagłówków | 0-2 | Czy strona ma H1, czy H2/H3 są w logicznej kolejności |
| Znaczniki semantyczne HTML5 | 0-2 | Obecność <main>, <article>, <nav>, <header>, <footer> |
| Atrybuty alt na obrazach | 0-2 | Procent obrazów z niepustym atrybutem alt (>80% = 2pkt, 40-80% = 1pkt) |
| Descriptive anchor text | 0-2 | Brak linków „kliknij tutaj”, „więcej”, „czytaj” bez kontekstu |
| Czas odpowiedzi serwera | 0-4 | <500ms = 4pkt, 500ms-1s = 2pkt, >1s = 0pkt |
| Dostępność przez HTTPS | 0-4 | HTTPS aktywne + redirect z HTTP |
Filar 2 — Struktura danych (max 25 pkt)
| Kryterium | Punkty | Co sprawdzamy |
|---|---|---|
| Schema.org obecne | 0-3 | Jakikolwiek JSON-LD lub microdata |
| Schema.org typ Organization/LocalBusiness | 0-4 | Poprawny typ z name, url, address |
| Schema.org typ właściwy dla branży | 0-4 | Product (e-commerce), MedicalOrganization (zdrowie), itd. |
| JSON-LD Person/Author | 0-3 | Dla mediów i blogów — atrybucja autora |
| Open Graph meta | 0-3 | og:title, og:description, og:image |
| BreadcrumbList | 0-2 | Dla podstron — ścieżka nawigacji |
| Brak konfliktów schema vs treść | 0-4 | Cena w schema = cena w HTML, nazwa = nazwa widoczna |
| FAQ/HowTo schema gdzie stosowne | 0-2 | Dla stron z pytaniami/instrukcjami |
Filar 3 — Odkrywalność (max 20 pkt)
| Kryterium | Punkty | Co sprawdzamy |
|---|---|---|
| robots.txt istnieje | 0-2 | Plik dostępny pod /robots.txt |
| robots.txt z regułami dla AI crawlerów | 0-4 | GPTBot, ClaudeBot, PerplexityBot, Google-Extended — jakiekolwiek reguły |
| Content Signals w robots.txt | 0-4 | Dyrektywa Content-Signal: (search/ai-input/ai-train) |
| llms.txt istnieje | 0-4 | Plik dostępny pod /llms.txt |
| llms.txt z treścią (>100 słów) | 0-2 | Nie pusty, nie placeholder |
| sitemap.xml istnieje i jest linkowany | 0-2 | Dostępna i wskazana w robots.txt |
| /dla-agentow lub podobny endpoint | 0-2 | Strona /dla-agentow, /for-agents, /ai lub rel=”service-doc” w head |
Filar 4 — Operacyjność (max 15 pkt)
| Kryterium | Punkty | Co sprawdzamy |
|---|---|---|
| Formularze kontaktowe bez CAPTCHA | 0-3 | Brak reCAPTCHA/hCaptcha na formularzu kontaktowym |
| API lub endpoint danych | 0-4 | Obecność /api/, /wp-json/, /feed/ lub podobnego |
| Checkout/rezerwacja — brak JS-only | 0-4 | Czy kluczowe akcje są dostępne bez renderowania |
| Dane kontaktowe w ustrukturyzowanej formie | 0-4 | Schema.org ContactPoint lub hCard z tel/email |
Filar 5 — Tożsamość (max 10 pkt)
| Kryterium | Punkty | Co sprawdzamy |
|---|---|---|
| JSON-LD Organization z identyfikatorem | 0-3 | sameAs z profilem LinkedIn/Google/KRS |
| Atrybucja autora treści | 0-3 | rel=author lub JSON-LD Person na artykułach |
| Polityka prywatności dostępna i linkowana | 0-2 | Link w stopce do /polityka-prywatnosci/ lub podobnej |
| Dane firmy — NIP/KRS w stopce | 0-2 | Ustrukturyzowane dane rejestrowe |
Filar 6 — Governance (max 10 pkt)
| Kryterium | Punkty | Co sprawdzamy |
|---|---|---|
| Świadoma polityka AI w robots.txt | 0-4 | Co najmniej dwie reguły specyficzne dla AI crawlerów (nie tylko * Disallow) |
| Content Signals — kompletność | 0-3 | Wszystkie trzy sygnały (search/ai-input/ai-train) zadeklarowane |
| Wersja robots.txt — data aktualizacji | 0-3 | Komentarz z datą lub plik zaktualizowany w 2025-2026 |
System punktacji
Maksymalnie: 100 punktów
| Wynik | Kategoria | Opis |
|---|---|---|
| 85-100 | ★★★★★ AI-Ready | Strona w pełni przygotowana na agentów AI |
| 70-84 | ★★★★ Zaawansowana | Solidne podstawy, drobne luki |
| 50-69 | ★★★ W trakcie | Podstawy są, brakuje warstw wyższych |
| 30-49 | ★★ Początkująca | Minimum obecne, praca do wykonania |
| 0-29 | ★ Niewidoczna | Strona niewidoczna lub nieprzyjazna dla agentów |
Co agent sprawdza technicznie — metodologia crawlu
User-agent i identyfikacja
Agent crawlujący identyfikuje się jako:
User-Agent: WebfluxReadinessBot/1.0 (+https://webflux.pl/raport-ai-readiness-2026/metodologia/)Każde żądanie zawiera nagłówek identyfikujący cel crawlu. Strony, które zablokują naszego bota w robots.txt, zostaną wykluczone z próby i zastąpione rezerwową domeną z tej samej branży.
Co crawlujemy
Per domena: strona główna + losowo wybrana podstrona (z sitemap lub link ze strony głównej). Łącznie 2 żądania per domena, maksymalnie 1 żądanie na 3 sekundy (throttling).
Czego NIE crawlujemy
- Podstron za logowaniem
- Koszyka / checkout (żadnych akcji transakcyjnych)
- Formularzy (żadnych wysyłek)
- Plików binarnych (PDF, obrazy, wideo)
Crawl jest wyłącznie read-only.
Ograniczenia techniczne automatycznej oceny
Raport przyznaje punkty za obecność i poprawność składniową elementów technicznych. Nie oceniamy:
- Jakości treści w llms.txt (czy jest pomocna, czy tylko formalność)
- Jakości opisów w schema.org (czy opis produktu jest dobry)
- Tego, czy API faktycznie działa i zwraca sensowne dane
- Cybersec — agent nie przeprowadza testów penetracyjnych
To są ograniczenia, które raport explicite przyznaje. Wynik 100/100 oznacza techniczną kompletność — nie gwarancję, że agent AI efektywnie obsłuży każde zadanie na stronie.
Dodatkowe ograniczenia odkryte w praktyce:
Soft-404 a llms.txt. Część serwerów zwraca HTTP 200 dla nieistniejących zasobów (tzw. soft-404) zamiast HTTP 404. Agent traktuje to jako obecność pliku. Wyniki dla llms.txt mogą być zawyżone — raport każdorazowo podaje procent z adnotacją o tym ograniczeniu.
Blokady WAF i Cloudflare. Część domen — w tym duże marki z zaawansowaną infrastrukturą — blokuje zewnętrznych crawlerów niezależnie od zadeklarowanego user-agenta. Takie domeny są wykluczane z próby i zastępowane rezerwowymi. Ich nieobecność w wynikach jest osobną informacją: strony które blokują crawlery AI-readiness, blokują też agentów AI.
Etyka badania
Crawl bez uprzedzenia. Badane strony są publicznie dostępne — ich crawl jest odczytem publicznych zasobów, identycznie jak robi to Google, Bing czy każda inna wyszukiwarka. Agent identyfikuje się własnym user-agentem z linkiem do tej strony metodologii. Respektuje robots.txt: domeny, które zablokują naszego bota, są wykluczane z próby i zastępowane rezerwowymi.
Bez listy badanych domen. Konkretna lista badanych stron nie jest publikowana ani przed, ani w raporcie końcowym. Podajemy kryteria, branże i zasady doboru — wystarczy to, by każdy mógł ocenić rzetelność badania. Publikowanie listy z wyprzedzeniem prowadziłoby do optymalizacji pod raport, a nie pod rzeczywistą gotowość — co podważa wartość danych.
Wyniki zagregowane, nie indywidualne. Raport publikuje statystyki per branża i ogółem — „X% polskich sklepów ma schema.org Product” — bez ujawniania wyników poszczególnych domen. Wyjątek: wyniki wybitnie dobre mogą być przywoływane jako przykłady dobrej praktyki, za zgodą właściciela.
Narzędzie lookup po publikacji. Po opublikowaniu raportu uruchamiamy możliwość sprawdzenia wyniku własnej domeny w GEO Checkerze na iFox.pl — każdy właściciel strony może zobaczyć, jak wypada jego serwis według tej samej metodologii. Wyniki indywidualne są dostępne tylko dla osoby odpytującej własną domenę.
Korekty techniczne. Jeśli agent popełnił błąd techniczny przy ocenie konkretnej domeny (np. strona tymczasowo nie odpowiadała, element był obecny ale nie został wykryty), właściciel może zgłosić korektę po publikacji raportu. Korekty dotyczą wyłącznie błędów agenta — nie są mechanizmem poprawiania wyniku przez aktualizację strony po fakcie.
Harmonogram
| Etap | Status | Publiczne? |
|---|---|---|
| Publikacja metodologii | maj 2026 | tak |
| Crawl agenta (wewnętrznie) | maj 2026 | nie |
| Analiza i czyszczenie danych | maj 2026 | nie |
| Publikacja raportu | maj 2026 | tak |
| Uruchomienie lookup własnej domeny | razem z publikacją | tak |
| Kolejne edycje | regularnie | tak (wyniki) |
17.08.2026: Późniejsze testy wykazały że uproszczenie typu blokada w robots.txt dla crawlerów blokuje również agentów AI jest tylko uproszczenie i nie obejmuje selective agent access.
Pytania dotyczące metodologii: lukasz@vereri.pl Webflux.pl — Agentic Web po polsku