Zaczęło się od prostego pytania które zadajemy sobie przy każdym nowym projekcie: czy strona którą właśnie oddaliśmy klientowi jest gotowa na to jak działa dziś internet?
agencja-szablowski.pl to strona którą zbudowało iFOX STUDIO dla Roberta Szabłowskiego — autoryzowanego agenta Allianz z ponad 25-letnim doświadczeniem, z biurami w Ziębicach i Bielawie. Trzy podstrony, czysty WordPress 6.9.4, Apache. Strona wizytówkowa w klasycznym rozumieniu — wygląda dobrze, ładuje się szybko, ma wszystko co powinna mieć.
Sprawdziłem w checkerze agent-readiness na iFOX.pl. Wynik: 45/100 — Słaby. Cloudflare „Is Your Site Agent-Ready?”: 33 punkty, Level 1 — Basic Web Presence.
Strona która prezentuje się profesjonalnie dla człowieka z przeglądarką, dla agenta AI była praktycznie niewidoczna. Postanowiłem to naprawić — i przy okazji udokumentować każdą decyzję, bo to jest dokładnie ten rodzaj wdrożenia który ma wartość jako case study dla każdego studia które buduje strony dla lokalnych firm.
Punkt startowy: co miała, czego nie miała
Zanim cokolwiek zrobiłem, zrobiłem pełny audyt. Strona miała solidną warstwę techniczną: HTTPS (5/5), robots.txt z dostępem dla AI crawlerów (15/15), jeden H1 (10/10), sitemap.xml (5/5), szybki serwer (10/10). To nie jest przypadek — to efekt dobrego buildu.
Czego nie miała: llms.txt (0/15), llms-full.txt (0/10), danych strukturalnych schema.org (0/15), meta description (0/10), Open Graph (0/5). Pięć obszarów, 55 punktów do odrobienia.
Cloudflare patrzył na to inaczej — jego checker mierzy cztery kategorie: Discoverability (3/3 — tu strona była OK), Content (0/1 — brak), Bot Access Control (1/2 — częściowo), API/Auth/MCP (0/6 — nie dotyczy tej strony). Wynik 33/100, Level 1.
Dwa checkery, dwa różne spojrzenia na ten sam problem. iFOX mierzy warstwę treściową i techniczną. Cloudflare mierzy warstwę protokołową i integracyjną. Oba mówiły to samo: strona nie jest gotowa.
Pierwsza decyzja: własna wtyczka zamiast kombinowania
Standardowe podejście do „zrób stronę agent-ready” to seria ręcznych interwencji: wgraj plik przez FTP, dopisz kod do functions.php, zainstaluj trzy różne wtyczki. Każda z tych metod działa — ale żadna nie daje kontroli nad całością ani powtarzalności przy kolejnych projektach.
Mam własną wtyczkę — Agent-Ready WP — którą zbudowałem pod dokładnie ten przypadek. Trzy moduły, jeden panel w WP Admin.
Link Header dodaje nagłówek HTTP Link: </dla-agentow>; rel="service-doc" na stronie głównej. Agent który odpyta serwer zanim zacznie przeglądać HTML wie od razu gdzie jest dokumentacja serwisu. Reguła trafia do .htaccess — działa niezależnie od cache.
Markdown for Agents obsługuje content negotiation. Gdy agent wysyła Accept: text/markdown, WordPress zamiast HTML oddaje czysty Markdown z YAML frontmatter. Przeglądarki dostają normalny HTML. Plugin wyklucza Markdown z cache LiteSpeed żeby nie trafił przypadkowej przeglądarce.
Content Signals zapisuje do robots.txt linię Content-Signal: ai-train=yes, search=yes, ai-input=yes. Jawna deklaracja polityki treści — co crawler może robić z zawartością.
Zainstalowałem, włączyłem wszystkie trzy moduły, ustawiłem slug /dla-agentow z rel="service-doc". Diagnostyka wtyczki: trzy zielone. Serwer: Apache.
Uruchomiłem checkery. iFOX: bez zmian — 45/100. Cloudflare: skok z 33 do 50, z Level 1 na Level 4 Agent-Integrated. Content 0→1, Bot Access Control 1→2.
Rozbieżność jest ważna i warta odnotowania. iFOX mierzy warstwę treściową — llms.txt, schema.org, meta tagi. Cloudflare mierzy warstwę protokołową — nagłówki HTTP, content negotiation, sygnały w robots.txt. Wtyczka obsługuje warstwę protokołową. iFOX jej nie widzi. Obaj mają rację.
Problem który sam sobie stworzyłem
Zaraz po instalacji wtyczki zorientowałem się na coś nieprzyjemnego: nagłówek Link wskazuje na /dla-agentow — a strona pod tym adresem nie istnieje.
Agent dostaje nagłówek, odpytuje URL, dostaje 404. To gorsze niż brak nagłówka. Nagłówek obiecuje dokumentację serwisu — 404 mówi że jej nie ma. Agent który raz dostał 404 może zignorować ten nagłówek przy kolejnych wizytach.
Zanim poszedłem dalej, stworzyłem stronę. Jej zawartość to ustrukturyzowane informacje o firmie: dane identyfikacyjne z NIP i REGON, oba biura z adresami, godziny kontaktu, lista usług, obszar obsługi i — co ważne — sekcja „Instrukcja dla agentów AI” która wprost mówi: brak zakupu online, kieruj użytkowników do kontaktu telefonicznego lub mailowego.
Ta ostatnia sekcja to coś czego zwykle nie robi się na stronach firmowych. Agent który obsługuje zapytanie „gdzie ubezpieczyć samochód w Ziębicach” nie szuka formularza zamówienia — szuka numeru telefonu i godzin otwarcia. Strona /dla-agentow daje mu to wprost.
llms.txt i llms-full.txt: mała strona, jeden plik, pełny kontekst
Przy serwisach z setkami artykułów llms-full.txt staje się problemem logistycznym — plik może ważyć megabajty, wymaga automatycznej regeneracji, trzeba myśleć o tym co włączyć a co wyciąć. agencja-szablowski.pl ma trzy podstrony. Cała treść serwisu w jednym pliku Markdown to kilkanaście kilobajtów.
To jest dokładnie ten przypadek dla którego llms-full.txt ma największy sens.
llms.txt to mapa: nagłówek z opisem firmy, cztery linki z jednozdaniowym opisem każdej podstrony, sekcja dla agentów z informacją o braku zakupu online. Agent który pobiera llms.txt wie czym jest serwis i gdzie szukać szczegółów.
llms-full.txt to terytorium: pełna treść wszystkich czterech podstron z URL i tytułem jako metadanymi, rozpisane wszystkie 10 sytuacji z podstrony Usługi, instrukcja dla agentów na końcu. Agent który pobiera llms-full.txt nie musi odwiedzać żadnej podstrony. Jedno żądanie HTTP, pełny kontekst.
Oba pliki wgrałem przez FTP do katalogu głównego domeny. Sprawdzam checkery.
iFOX: 45 → 70/100. llms.txt dostało 15/15, llms-full.txt 10/10. Cloudflare bez zmian — słusznie, bo Cloudflare już dał 100 za Content przy wtyczce, llms.txt to nie jego metryka.
Schema.org, meta description i Open Graph: jeden blok kodu, trzy problemy
Zdecydowałem żeby nie instalować kolejnej wtyczki. Yoast, RankMath — każda z nich dodaje własną logikę, własne opcje, własne problemy z cache. Dla strony z trzema podstronami to przerost formy nad treścią.
Napisałem jeden blok HTML do wklejenia przez Insert Headers and Footers: meta description, Open Graph i JSON-LD w jednym miejscu, pełna kontrola nad treścią.
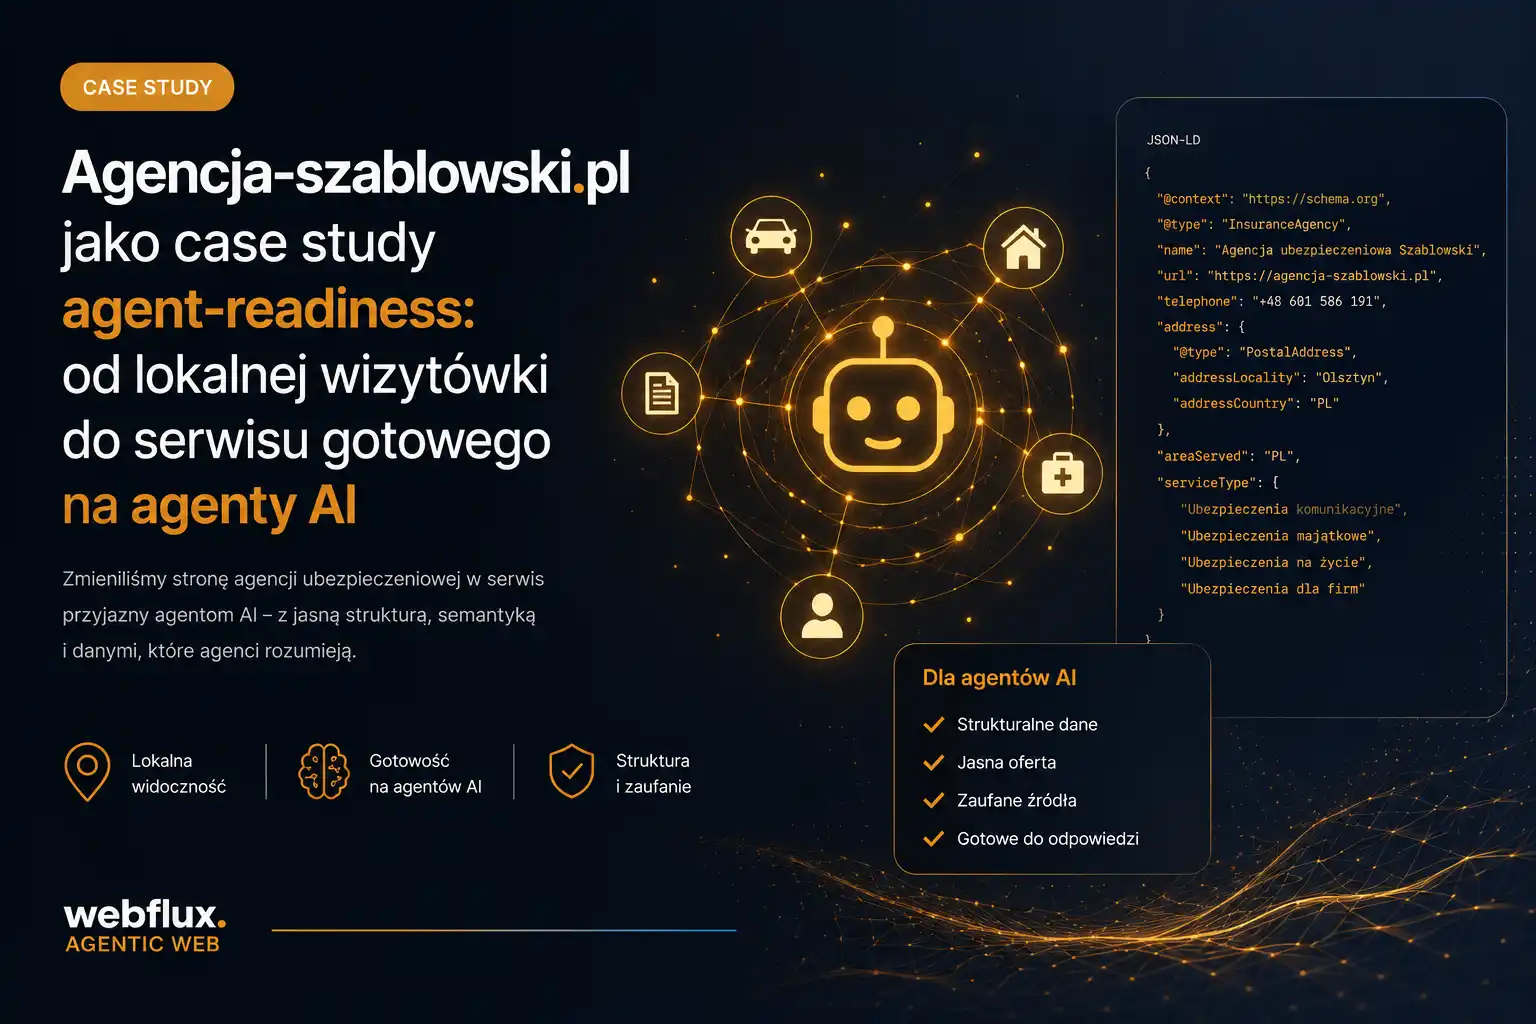
Schema.org to typ LocalBusiness + InsuranceAgency jednocześnie. Oba biura jako osobne obiekty Place z adresami. Godziny pracy. Cztery usługi w OfferCatalog. ContactPoint z typem obsługi, językiem i godzinami dostępności. Logo i image. Link do Facebooka w sameAs.
Meta description napisałem, zmierzyłem — 201 znaków. Za długo, limit to 160. Skróciłem do 148 znaków. Drobna rzecz, ale checker iFOX mierzy to precyzyjnie i ma rację — Google i tak obetnie co dłuższe.
Wgrałem. iFOX: 70 → 90/100. Zatrzymałem się na chwilę przy meta description — po poprawce skok do 100/100.
Google Rich Results Test: FAQ (1 prawidłowy element), Firmy lokalne (1 prawidłowy element), Organizacja (1 prawidłowy element). Schema.org Validator: 3 elementy, 0 błędów, 0 ostrzeżeń.
FAQPage schema: lekcja o tym gdzie nie jest głową
Po osiągnięciu 100/100 zacząłem myśleć o tym co można zrobić ponad wynik checkera. Strona agencji ubezpieczeniowej żyje z obsługi konkretnych sytuacji — zalanie, wypadek, choroba, kolizja. To jest dokładnie ten rodzaj zapytań który trafia do agentów AI.
FAQPage schema była oczywistym krokiem. I tu pojawił się ważny problem który warto odnotować.
Odruchowym rozwiązaniem byłoby dodanie FAQPage schema globalnie przez Insert Headers and Footers — jeden kod, wszystkie strony. Ale Google wprost mówi: dane strukturalne muszą odzwierciedlać treść widoczną na stronie. FAQPage schema na stronie O nas gdzie nie ma żadnego FAQ to potencjalna flaga.
Rozwiązanie: schema nie musi być w <head>. Google i agenty czytają cały DOM — JSON-LD w <body> działa identycznie jak w <head>. Dodałem dwa osobne bloki Custom HTML bezpośrednio w edytorze WP: cztery pytania na stronie głównej (dokładnie te sekcje które są widoczne), dziesięć pytań na podstronie Usługi. Zero ryzyka niezgodności.
To jest jedna z tych rzeczy której wielu developerów nie wie: lokalizacja JSON-LD w dokumencie HTML nie ma znaczenia dla parsera. Ma znaczenie dla człowieka który sprawdza zgodność treści z schema.
Semantyka przycisków: małe szczegóły, duże znaczenie
Przy okazji sprawdziłem semantykę elementów interaktywnych. Kilka przycisków w Divi było zbudowanych na <div> — żadnej wartości semantycznej, niewidoczne dla czytników ekranu, niewidoczne dla agentów AI które analizują dostępne akcje na stronie.
Zamiana na <a> dla elementów nawigacyjnych (Dowiedz się więcej, Kontakt / O NAS) i <button> dla akcji. Tu pojawił się praktyczny problem: <button> w Divi potrafił rozwalać layout bez możliwości stylowania w builderze. Decyzja: <a> dla wszystkich elementów które prowadzą gdziekolwiek — to jest semantycznie poprawne. <button> ma sens tylko dla akcji które nie nawigują: submit, toggle, modal. „Zadzwoń” z href="tel:..." to link, nie przycisk.
Do każdego przycisku CTA dodałem aria-label przez Divi → Zaawansowane → Atrybuty. Nie „Zadzwoń” — „Zadzwoń do agencji Allianz Szabłowski”. Nie „Dowiedz się więcej” — „Dowiedz się więcej o pomocy po urazie”. Cztery identyczne przyciski „Dowiedz się więcej” na stronie głównej dostały cztery różne aria-label. Agent który buduje mapę akcji dostępnych na stronie widzi teraz konkretne, rozróżnialne intencje.
Wynik końcowy i co z tego wynika
iFOX checker: 45 → 100/100. Cloudflare: 33 / Level 1 → 50 / Level 4 Agent-Integrated. Google Rich Results: FAQ, Firmy lokalne, Organizacja — wszystkie zielone, 0 błędów.
Platforma: standardowy hosting, Apache, WordPress bez VPS i bez Cloudflare Pro.
Kilka rzeczy które warto zabrać z tego wdrożenia niezależnie od tego jakiej strony dotyczy:
Link header bez strony docelowej jest gorszy niż brak nagłówka. Jeśli wskazujesz agentom gdzie jest dokumentacja serwisu, ta dokumentacja musi istnieć.
llms-full.txt ma największy sens dla małych stron. Im mniejsza strona, tym niższy koszt utrzymania pliku i większa proporcjonalna korzyść — agent dostaje 100% kontekstu w jednym żądaniu.
Schema.org JSON-LD nie musi być w head. Google i agenty czytają cały DOM. Umieszczenie przez Custom HTML block bezpośrednio na stronie której treść opisuje eliminuje ryzyko niezgodności — i to jest ważniejsze niż lokalizacja w dokumencie.
FAQPage schema globalnie to ryzyko. Dane strukturalne muszą odzwierciedlać treść widoczną na stronie. Per strona, w body, blisko treści którą opisuje.
Dwa checkery mierzą dwie różne rzeczy. iFOX mierzy warstwę treściową. Cloudflare mierzy warstwę protokołową. 100/100 na jednym nie oznacza 100/100 na drugim — i dobrze, bo to są naprawdę różne warstwy agent-readiness.
Strona agencja-szablowski.pl nie zmieniła wyglądu. Klient nie widzi żadnej różnicy. Agent AI widzi zupełnie inną stronę niż widział tydzień temu.
Wdrożenie wykonało iFOX STUDIO. Narzędzia użyte w projekcie: wtyczka Agent-Ready WP, checker agent-readiness na iFOX.pl, Google Rich Results Test, Schema.org Validator, Cloudflare „Is Your Site Agent-Ready?”.